はじめに
OpenAIが2026年2月11日、同社のエンジニアリングブログで、Codexを使用して人間が一行もコードを書かずに内部製品を開発した実験結果を公開しました。本稿では、この5ヶ月間の実験から得られた知見と、エージェント主導の開発環境における新しいエンジニアリングの在り方について解説します。
参考記事
- タイトル: Harness engineering: leveraging Codex in an agent-first world
- 著者: Ryan Lopopolo, Member of the Technical Staff
- 発行元: OpenAI
- 発行日: 2026年2月11日
- URL: https://openai.com/index/harness-engineering/
要点
- OpenAIのチームは5ヶ月間、人間が一行もコードを手書きせず、すべてをCodexに生成させる制約で内部製品を開発した
- 3人のエンジニアで約1,500件のプルリクエストを処理し、1エンジニアあたり1日平均3.5件のPRをマージした
- エンジニアの役割は、コードを書くことから、エージェントが動作できる環境設計、意図の明確化、フィードバックループの構築へと変化した
- リポジトリの知識ベースを構造化し、AGENTS.mdを目次として機能させることで、エージェントが効率的に動作できる環境を実現した
- アーキテクチャの制約を機械的に強制することで、エージェントが高速に開発しながらも品質を維持できる仕組みを構築した
詳細解説
実験の概要:完全にエージェント生成されたコードベース
OpenAIのチームは2025年8月末から、意図的に「人間が一行もコードを手書きしない」という制約を設けて製品開発を開始しました。最初のコミットから、リポジトリ構造、CI設定、フォーマット規則、パッケージマネージャーの設定、アプリケーションフレームワークまで、すべてGPT-5を使用したCodex CLIによって生成されました。
5ヶ月後、このリポジトリには約100万行のコードが含まれるようになりました。OpenAIによれば、アプリケーションロジック、インフラストラクチャ、ツール、ドキュメント、内部開発者ユーティリティなど、あらゆる要素がエージェントによって生成されています。この期間中、約1,500件のプルリクエストが3人のエンジニアによって開き、マージされました。重要なのは、この製品が実際に数百人の内部ユーザーに使用されており、毎日使うパワーユーザーもいるという点です。
100万行というコード量は、中規模のWebアプリケーションに相当する規模と言えます。一般的な人間のエンジニアチームであれば、同様の規模の製品を開発するには数年単位の時間が必要になることが多く、OpenAIの推定では手書きの場合の約1/10の時間で構築されたとされています。
エンジニアの役割の再定義
この実験で最も興味深い変化は、エンジニアの役割が根本的に変わったという点です。OpenAIによれば、初期の進捗は予想より遅かったものの、その原因はCodexの能力不足ではなく、環境が十分に定義されていなかったためだとされています。
エンジニアの主な仕事は、エージェントが有用な作業を実行できるようにすることへと変化しました。具体的には、大きな目標を小さな構成要素(設計、コード、レビュー、テスト等)に分解し、エージェントにそれらの構成要素を構築させ、それらを使用してより複雑なタスクを実現する、という深さ優先のアプローチです。
人間とシステムの相互作用は、ほぼ完全にプロンプトを通じて行われます。エンジニアはタスクを記述し、エージェントを実行させ、プルリクエストを開かせます。PRを完成させるために、Codexに自身の変更をローカルでレビューさせ、追加のエージェントレビューをローカルおよびクラウドで要求し、人間やエージェントからのフィードバックに応答させ、すべてのエージェントレビュアーが満足するまでループで反復させます。
この開発スタイルでは、「もっと頑張る」という対処法は機能しません。何かが失敗したとき、エンジニアは常に「どの能力が欠けているか、そしてそれをエージェントにとって理解可能かつ強制可能にするにはどうすればよいか」を問う必要があります。
アプリケーションの可読性向上
コードの生産量が増加するにつれ、OpenAIによれば、ボトルネックは人間のQA能力になりました。人間の時間と注意が固定の制約であるため、チームはアプリケーションのUI、ログ、メトリクスをCodex自身が直接理解できるようにすることで、エージェントに能力を追加する取り組みを行いました。
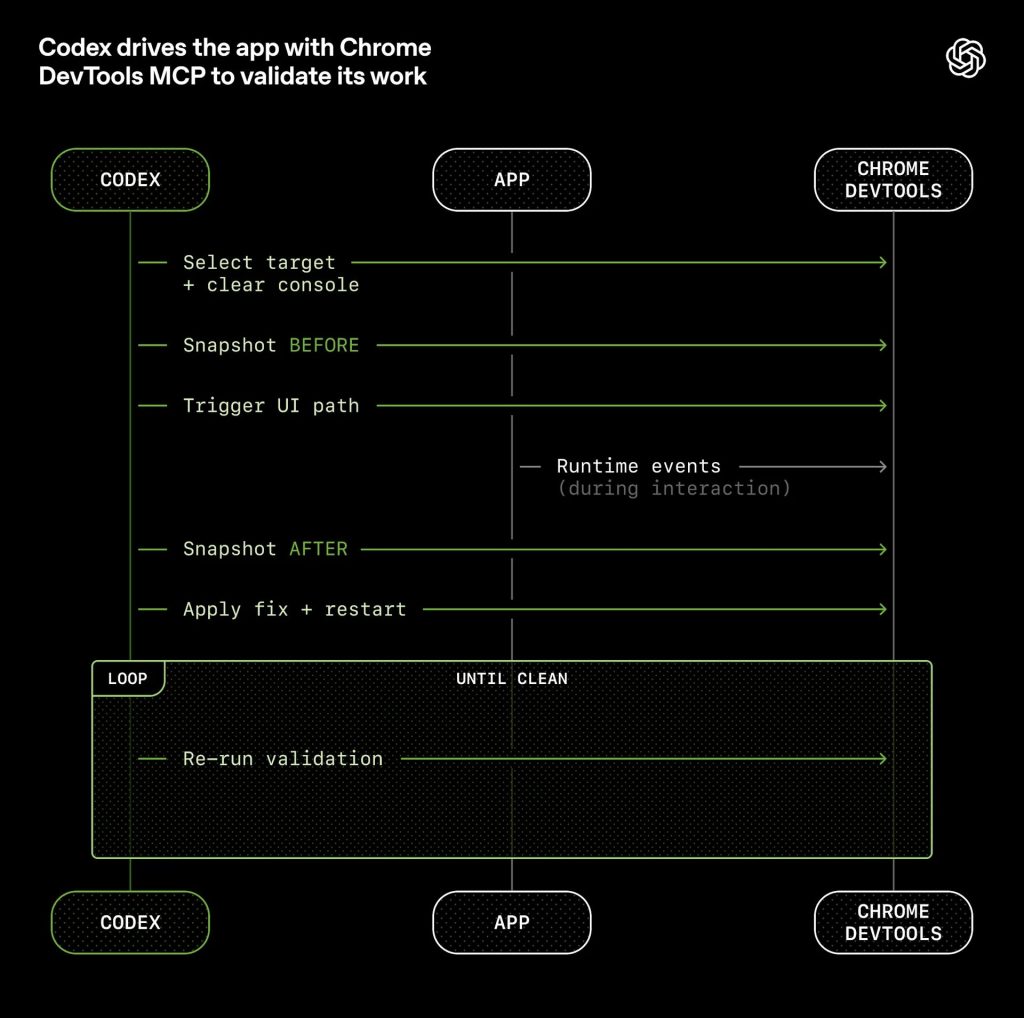
例えば、Codexがgitワークツリーごとに1つのインスタンスを起動できるようにアプリを起動可能にしました。また、Chrome DevTools Protocolをエージェントランタイムに組み込み、DOMスナップショット、スクリーンショット、ナビゲーションを扱うスキルを作成しました。これにより、Codexはバグを再現し、修正を検証し、UI動作について直接推論できるようになりました。
同様に、可観測性ツールについても対応しました。ログ、メトリクス、トレースは、各ワークツリーに対してエフェメラルなローカル可観測性スタック経由でCodexに公開されます。Codexは完全に分離されたバージョンのアプリ(ログとメトリクスを含む)で作業し、タスクが完了すると削除されます。エージェントはLogQLでログを、PromQLでメトリクスをクエリできます。このコンテキストが利用可能になることで、「サービス起動が800ms未満で完了することを確認する」や「これら4つの重要なユーザージャーニーのスパンが2秒を超えないようにする」といったプロンプトが実行可能になります。
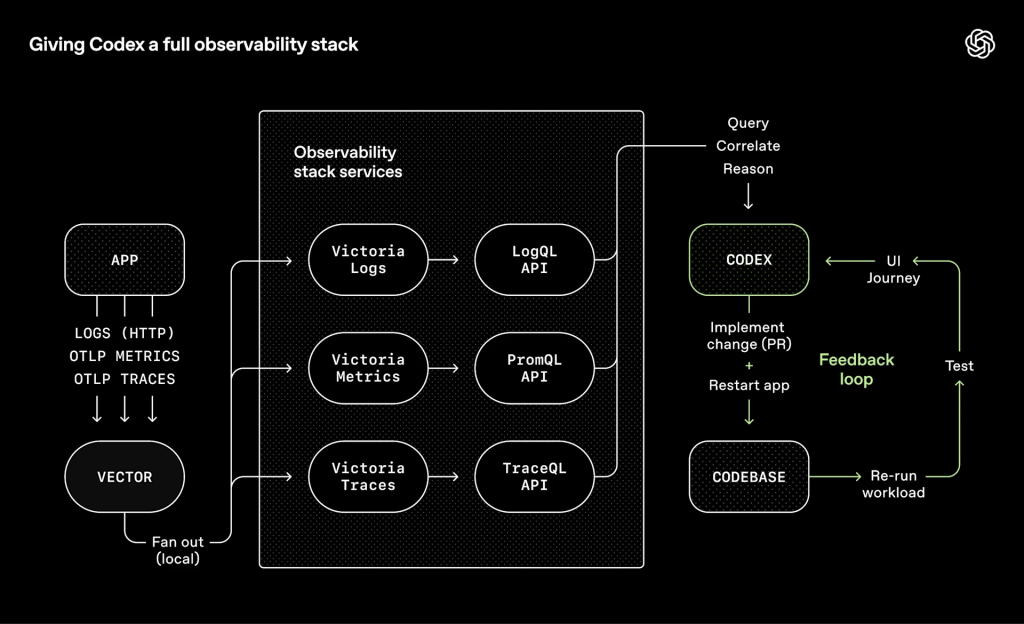
OpenAIの報告では、Codexが単一のタスクで6時間以上(人間が寝ている間も)動作し続けることが定期的に観察されているとのことです。
リポジトリ知識を信頼できる情報源に
コンテキスト管理は、エージェントを大規模で複雑なタスクで効果的にする上で最大の課題の1つです。OpenAIが早期に学んだ最も重要な教訓は、「Codexに地図を与えて、1,000ページの取扱説明書を与えない」というものでした。
チームは当初「1つの大きなAGENTS.md」アプローチを試しましたが、予想通り失敗しました。巨大な指示ファイルはタスク、コード、関連ドキュメントを圧迫し、エージェントが重要な制約を見逃すか、間違った制約を最適化し始めるという問題が発生しました。また、あまりにも多くのガイダンスは「ガイダンスなし」と同じになり、エージェントは意図的にナビゲートする代わりにローカルでパターンマッチングを始めます。さらに、モノリシックなマニュアルは瞬時に腐敗し、エージェントは何が真実かを判断できなくなります。
代わりに、AGENTS.mdを百科事典ではなく目次として扱うアプローチを採用しました。リポジトリの知識ベースは、信頼できる情報源として扱われる構造化されたdocs/ディレクトリに存在します。短いAGENTS.md(約100行)がコンテキストに注入され、主に地図として機能し、他の場所にある深い真実の情報源へのポインタを提供します。
設計ドキュメントは分類・索引化され、検証ステータスとエージェント主導の運用原則を定義する一連のコアビリーフが含まれています。アーキテクチャドキュメントは、ドメインとパッケージレイヤリングのトップレベルマップを提供します。品質ドキュメントは、各製品ドメインとアーキテクチャレイヤーを採点し、時間の経過とともにギャップを追跡します。
計画は第一級の成果物として扱われます。小さな変更には短命で軽量な計画が使用され、複雑な作業はリポジトリにチェックインされた進捗と決定ログを持つ実行計画でキャプチャされます。この構造により、エージェントは小さく安定したエントリポイントから始め、次にどこを見るべきかを教えられるため、最初から圧倒されることがありません。
これは機械的に強制されています。専用のリンターとCIジョブが、知識ベースが最新で、相互リンクされ、正しく構造化されていることを検証します。定期的な「ドキュメント整備」エージェントが、実際のコード動作を反映していない古いまたは時代遅れのドキュメントをスキャンし、修正プルリクエストを開きます。
エージェントの可読性を目標に
OpenAIによれば、リポジトリが完全にエージェント生成されているため、まずCodexの可読性のために最適化されています。チームが新しいエンジニアの採用者に対してコードのナビゲート性を向上させることを目指すのと同様に、人間のエンジニアの目標は、エージェントがリポジトリ自体から直接ビジネスドメイン全体について推論できるようにすることでした。
エージェントの観点から見ると、実行中にコンテキストでアクセスできないものは事実上存在しません。Google Docs、チャットスレッド、人々の頭の中にある知識は、システムにアクセスできません。リポジトリローカルでバージョン管理された成果物(コード、markdown、スキーマ、実行可能な計画など)のみが見えます。
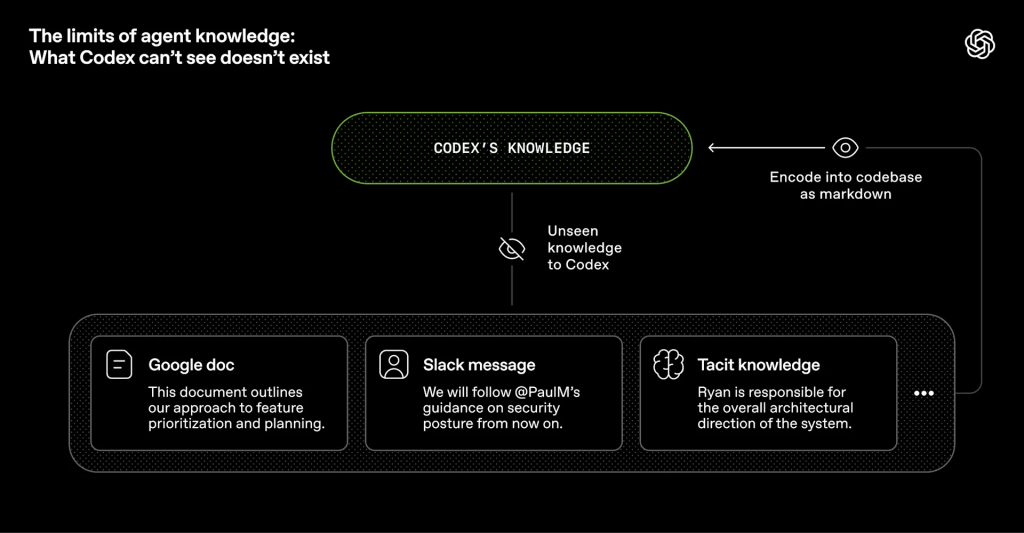
この考え方により、多くのトレードオフが明確になりました。完全に内部化され、リポジトリ内で推論できる依存関係と抽象化が優先されました。「退屈」と表現されることが多い技術は、組み合わせ可能性、APIの安定性、トレーニングセットでの表現により、エージェントがモデル化しやすい傾向があります。場合によっては、不透明な上流の動作に対処するよりも、エージェントに機能のサブセットを再実装させる方が安価でした。
より多くのシステムをエージェントが検査、検証、直接変更できる形式にすることで、Codexだけでなく、コードベースで作業している他のエージェント(Aardvarkなど)に対してもレバレッジが増加します。
アーキテクチャとテイストの強制
ドキュメントだけでは、完全にエージェント生成されたコードベースの一貫性を保つことはできません。不変条件を強制し、実装を細かく管理しないことで、エージェントが基盤を損なうことなく高速に出荷できるようになります。
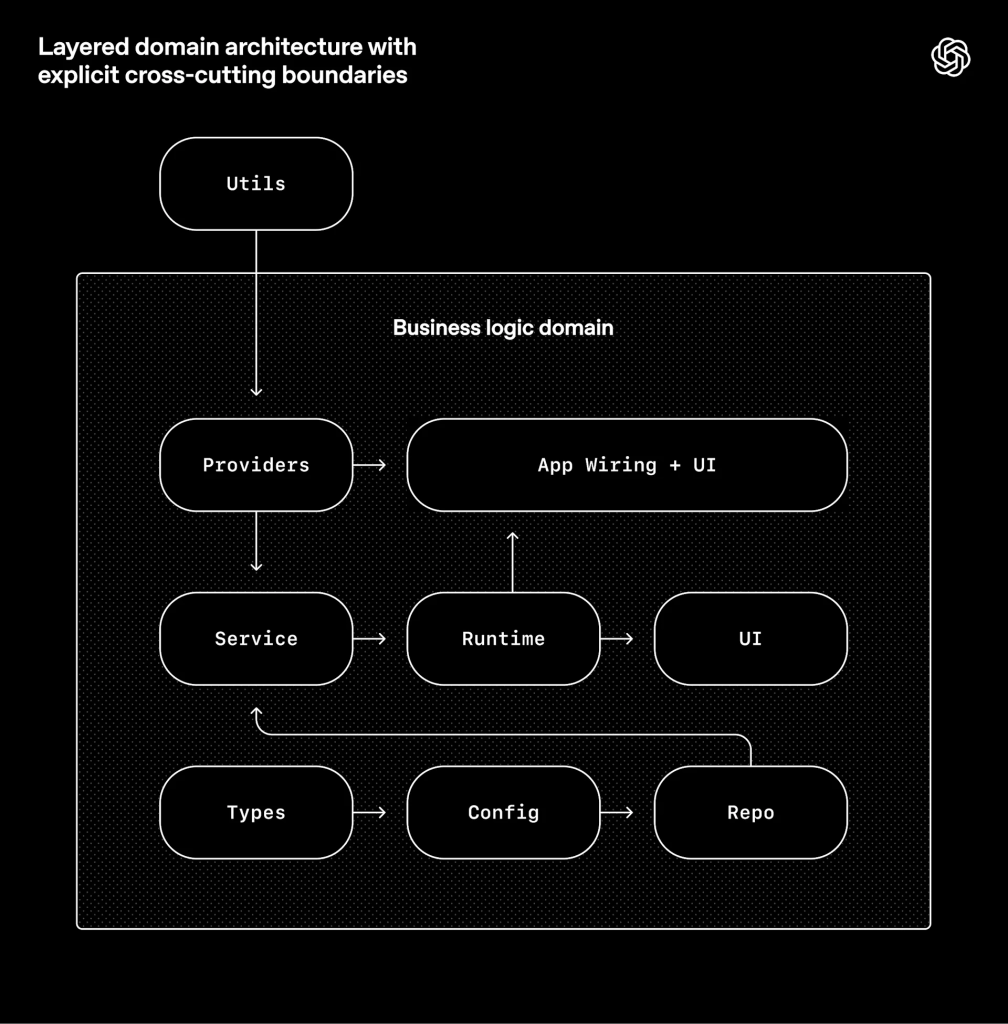
エージェントは、厳格な境界と予測可能な構造を持つ環境で最も効果的です。そのため、アプリケーションは厳格なアーキテクチャモデルを中心に構築されました。各ビジネスドメインは固定されたレイヤーセットに分割され、依存関係の方向が厳密に検証され、許可されるエッジのセットが制限されています。これらの制約は、カスタムリンター(もちろんCodex生成)と構造テストを介して機械的に強制されます。
各ビジネスドメイン内で、コードは固定されたレイヤーセット(Types → Config → Repo → Service → Runtime → UI)を通じて「前方に」のみ依存できるというルールがあります。横断的関心事(認証、コネクタ、テレメトリ、機能フラグ)は、Providersという単一の明示的なインターフェースを通じて入ります。それ以外は許可されず、機械的に強制されます。
これは通常、数百人のエンジニアがいるまで延期されるタイプのアーキテクチャです。コーディングエージェントでは、これは早期の前提条件となります。制約こそが、崩壊やアーキテクチャのドリフトなしにスピードを可能にするものです。
実際には、カスタムリンターと構造テスト、さらに少数の「テイスト不変条件」でこれらのルールを強制しています。例えば、構造化ロギング、スキーマと型の命名規則、ファイルサイズ制限、プラットフォーム固有の信頼性要件をカスタムリントで静的に強制します。リントがカスタムであるため、エラーメッセージを書いてエージェントコンテキストに修復指示を注入します。
人間主導のワークフローでは、これらのルールは些末または制約的に感じられるかもしれません。エージェントでは、これらは乗数になります。一度エンコードされれば、一度にすべての場所に適用されます。
同時に、制約が重要な場所と重要でない場所について明示的にしています。これは、大規模なエンジニアリングプラットフォーム組織をリードすることに似ています。境界を中央で強制し、ローカルで自律性を許可します。正しさと再現性を深く気にかけます。これらの境界内では、チーム(またはエージェント)にソリューションの表現方法においてかなりの自由を許可します。
結果として生成されるコードは、必ずしも人間のスタイル的好みと一致しないことがありますが、それで問題ありません。出力が正しく、保守可能で、将来のエージェント実行にとって理解可能である限り、基準を満たしています。
スループットがマージ哲学を変える
Codexのスループットが増加するにつれ、多くの従来のエンジニアリング規範が逆効果になりました。OpenAIによれば、リポジトリは最小限のブロッキングマージゲートで運用されています。プルリクエストは短命です。テストフレークは、進捗を無期限にブロックするのではなく、フォローアップの実行で対処されることが多くなっています。
エージェントのスループットが人間の注意をはるかに上回るシステムでは、修正は安価で、待つことは高価です。低スループット環境では無責任と言えるこの手法も、ここでは適切なトレードオフであることが多いと考えられます。
エントロピーとガベージコレクション
完全なエージェント自律性は、新しい問題も導入します。Codexは、リポジトリに既に存在するパターンを複製します。不均一または最適でないパターンも含めてです。時間の経過とともに、これは必然的にドリフトにつながります。
当初、人間が手動でこれに対処していました。チームは毎週金曜日(週の20%)を「AIスロップ」のクリーンアップに費やしていました。当然ながら、これはスケールしませんでした。
代わりに、「ゴールデンプリンシプル」と呼ばれるものをリポジトリに直接エンコードし、定期的なクリーンアッププロセスを構築し始めました。これらの原則は、将来のエージェント実行のためにコードベースを理解可能で一貫性のあるものに保つための、独自の機械的ルールです。定期的に、逸脱をスキャンし、品質グレードを更新し、ターゲットを絞ったリファクタリングプルリクエストを開く一連のバックグラウンドCodexタスクがあります。これらのほとんどは1分未満でレビューでき、自動マージされます。
これはガベージコレクションのように機能します。技術的負債は高金利のローンのようなものです。痛みを伴うバーストで取り組むよりも、小さな増分で継続的に返済する方がほぼ常に良いと考えられます。人間のテイストは一度キャプチャされ、その後すべてのコード行で継続的に強制されます。これにより、悪いパターンが数日または数週間コードベースに広がるのではなく、毎日ベースでキャッチして解決することもできます。
まだ学んでいること
OpenAIによれば、この戦略は内部ローンチとOpenAI内での採用を通じてこれまでうまく機能してきました。実際のユーザーのための実際の製品を構築することで、投資を現実に固定し、長期的な保守性に向けて導くことができました。
まだわからないのは、完全にエージェント生成されたシステムでアーキテクチャの一貫性が数年にわたってどのように進化するかです。人間の判断が最もレバレッジを追加する場所と、その判断を複利的にエンコードする方法についてまだ学んでいます。また、モデルが時間の経過とともにより能力が高くなり続けるにつれて、このシステムがどのように進化するかもわかりません。
明らかになったのは、ソフトウェアを構築するには依然として規律が必要ですが、その規律はコードよりも足場に現れるということです。コードベースの一貫性を保つツール、抽象化、フィードバックループがますます重要になっています。
まとめ
OpenAIの実験は、エージェント主導の開発環境において、エンジニアリングの本質が「コードを書く」ことから「環境を設計し、フィードバックループを構築する」ことへと変化することを示しました。完全にエージェント生成されたコードベースの維持には、構造化された知識ベース、機械的に強制される制約、継続的なリファクタリングプロセスが不可欠です。今後、Codexのようなエージェントがソフトウェアライフサイクルのより大きな部分を担うようになるにつれ、人間のエンジニアの役割はさらに進化していくと考えられます。