はじめに
Google Researchが2026年8月12日、LLM(大規模言語モデル)の事実誤りの原因を分析した研究成果を公開しました。研究者らは、モデルが「知識を持っていないのか」「知識はあるのに引き出せないのか」を切り分ける手法「知識プロファイリング」を提案し、その結果を報告しています。
参考記事
- タイトル: Empty Shelves or Lost Keys? Recall Is the Bottleneck for Parametric Factuality
- 著者: Nitay Calderon, Gal Yona
- 発行元: Google Research Blog
- 発行日: 2026年8月12日
- URL: https://research.google/blog/empty-shelves-or-lost-keys-recall-is-the-bottleneck-for-parametric-factuality/
関連記事
要点
- Google Researchは、LLMの事実誤りを「知識が符号化(エンコード)されていないため」と「符号化された知識を引き出せない(想起できない)ため」に切り分ける「知識プロファイリング」という分析手法を提案した
- Wikipediaの事実2,150件から構築したベンチマーク「WikiProfile」を用いて13種類のLLMを評価した結果、Gemini 3 ProやGPT-5では95〜98%の事実が符号化されている一方、26〜34%は直接想起できないことが判明した
- 「思考(thinking)」を有効にすると想起の失敗率は11〜12%まで下がり、符号化済みで想起できなかった事実のうち40〜65%を回復できることが確認された
- 出現頻度の低い事実や、主語と目的語を入れ替えた逆方向の質問(reversal curse)においても、符号化はできているのに想起だけが難しいという共通の傾向が見られた
詳細解説
知識プロファイリングとは何か
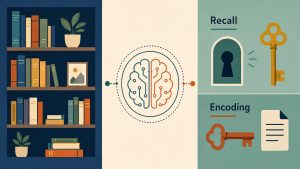
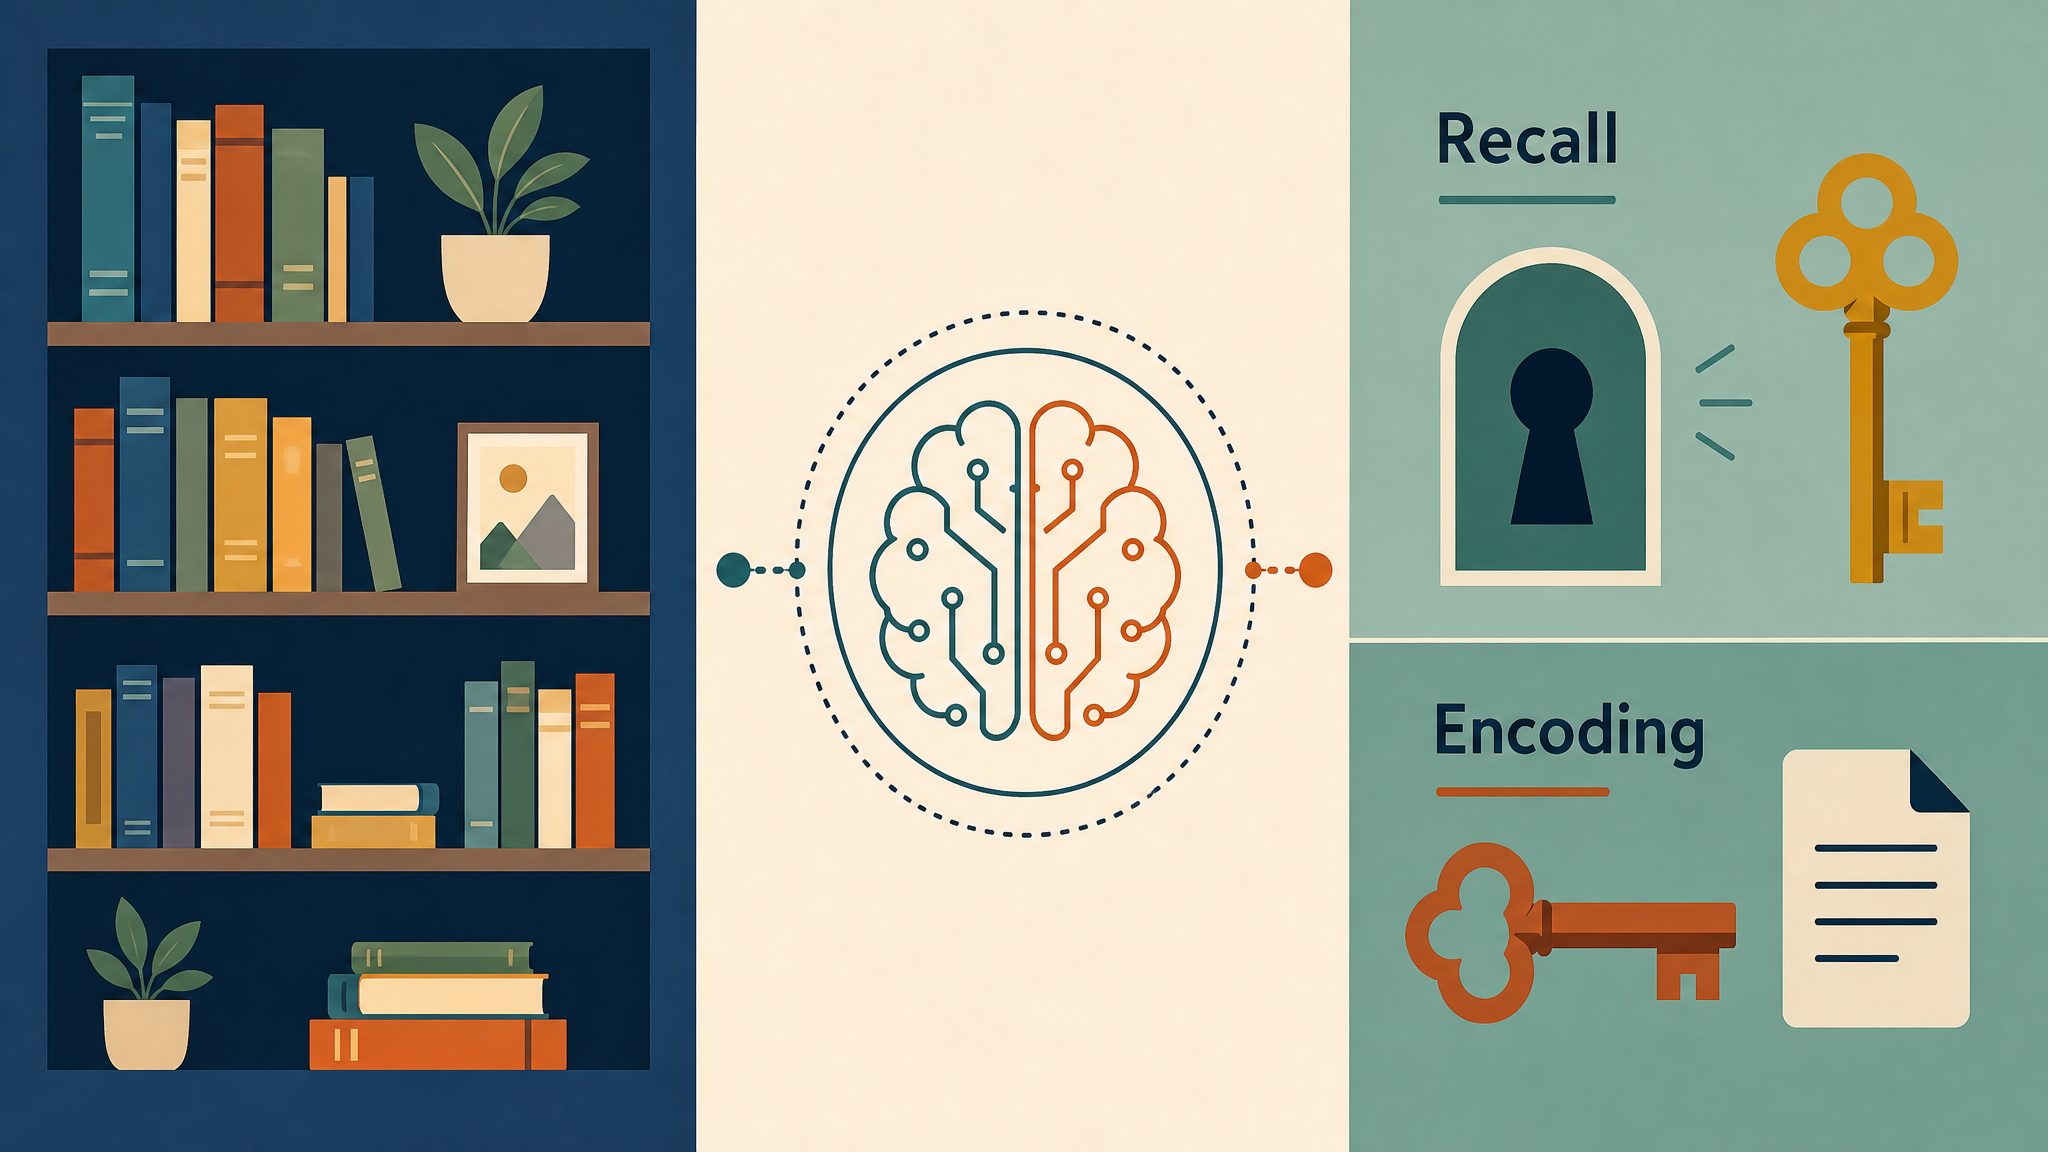
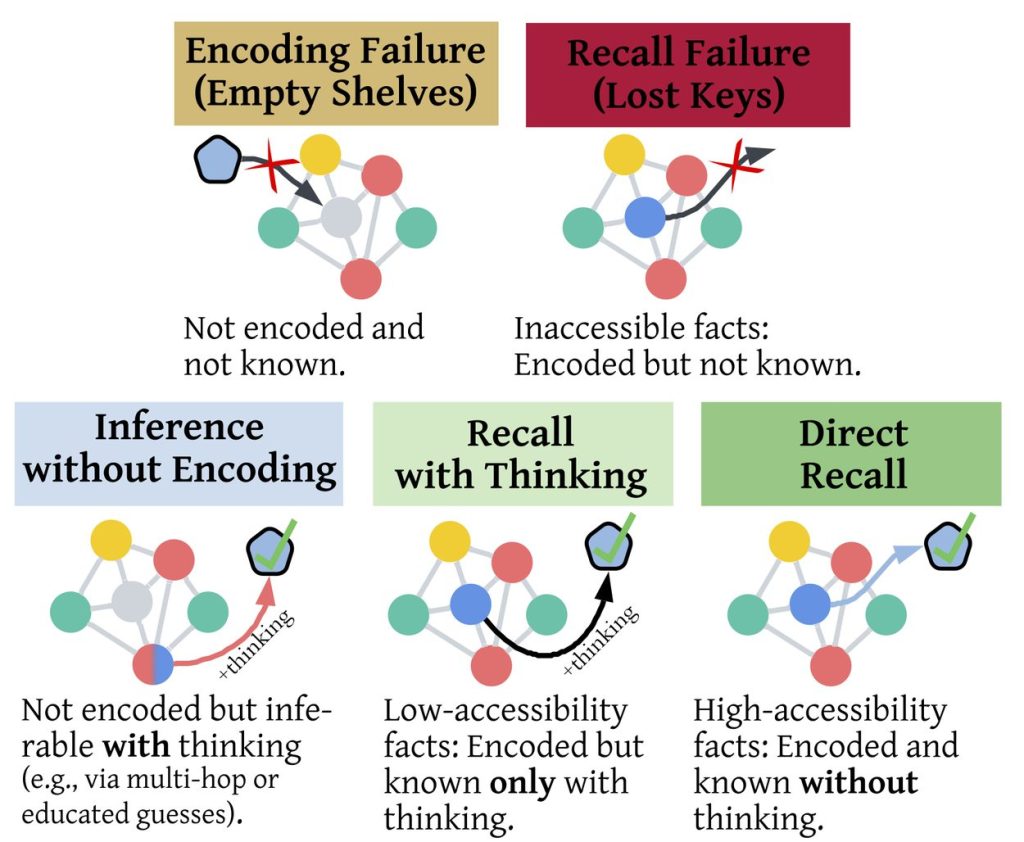
Google Researchは、LLMの事実に関する振る舞いを「符号化(encoding)」「知識(knowledge)」「想起(recall)」という3つの観点で捉え直す枠組みを提案しています。符号化とは、事前学習で見たような文脈の中でモデルが事実を正しく再現できるかどうかを指し、知識とは、言い回しや質問の方向(順方向・逆方向)を変えても正しく答えられるかどうかを指します。そして想起とは、符号化済みの事実について、実際に知識として引き出せている状態を意味します。
この枠組みに基づき、各事実は「符号化失敗」「想起失敗」「直接想起」「思考を伴う想起」「符号化なしの推論」という5つのプロファイルに分類されます。従来の正答率という指標では、事実を全く知らないケースと、知ってはいるが引き出せていないケースが同じ「不正解」として扱われてしまいますが、この2つは原因も対処法も異なると考えられます。前者にはモデルの規模拡大やデータ拡充が有効だと思われる一方、後者には学習後の調整や推論時の工夫が効く可能性があるという整理です。
WikiProfileベンチマークと評価の枠組み
この分析を実現するため、Wikipediaの記述から抽出した2,150件の事実に、それぞれ10種類の質問(符号化用2問、知識評価用4問、多肢選択式の認識評価用4問)を紐づけたベンチマーク「WikiProfile」が構築されました。事実の抽出や質問生成、フィルタリングは、Gemini 2.5 Proをベースにした自動パイプラインで行われ、最終的に人手による検証も加えられています。
評価対象はGemini 3 Pro・Flash、GPT-5を含む13種類のLLMで、思考の有無それぞれについて1事実・1タスクあたり8回ずつ応答をサンプリングし、合計で約450万件の応答を収集しています。これだけ大規模なサンプリングを行っているのは、モデルの応答には揺らぎがあるため、1回の質問への正誤だけでは「符号化されているが想起できない」のか「そもそも符号化されていない」のかを安定して判定しにくいためだと考えられます。
主要な発見:符号化はほぼ限界、ボトルネックは想起に移っている
Gemini 3 ProやGPT-5のようなフロンティアモデルでは、事実の符号化率はすでに95〜98%に達しており、ほぼ飽和状態にあります。しかし、これらのモデルでも事実の26〜34%は直接には想起できず、思考を有効にしてもなお11〜12%は正しく答えられないと報告されています。つまり、フロンティアモデルの事実誤りは、知識が「そもそも無い」ことよりも、「あるのに引き出せない」ことに起因する割合が増えていると考えられます。
Gemma 3ファミリーでのスケーリング比較でも同様の傾向が見られ、モデルサイズを大きくすると符号化の失敗は大きく減る一方、想起の失敗はあまり改善せず、残る誤りの中で相対的に大きな割合を占めるようになります。これは、以前の記事でも触れた「思考によって想起精度が高まる」という知見とも符合しており、モデルの規模拡大が「知識の蓄積」には効いても「知識の利用」には必ずしも効かないという課題を裏付けるものだと言えます。
想起が難しくなる2つのケース
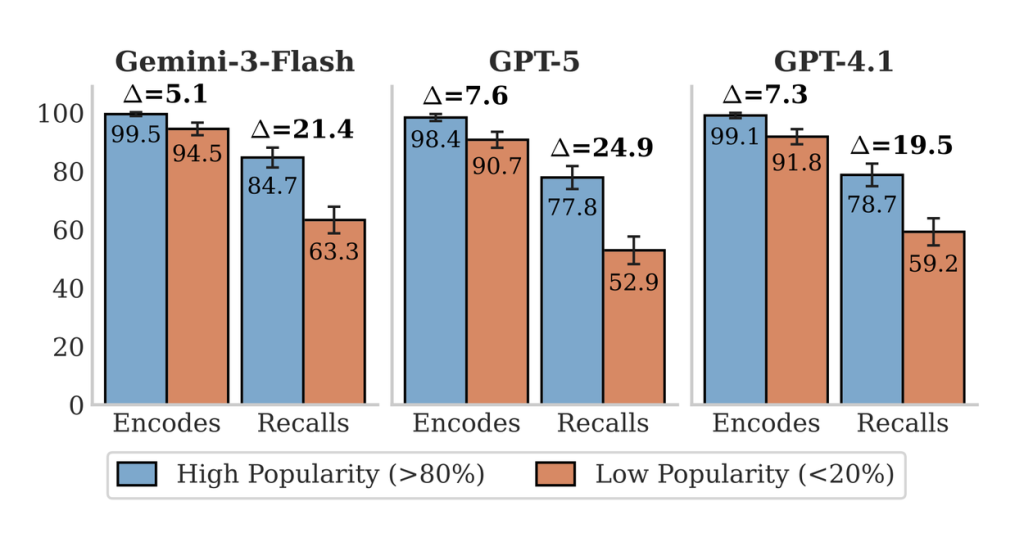
研究チームは、想起が失敗しやすい典型例として2つのケースを挙げています。1つは出現頻度の低い「ロングテール」な事実です。人気度の低い事実と高い事実を比較すると、符号化率の差は比較的小さいのに対し、想起率の差ははるかに大きいと報告されています。従来、ロングテールな事実への弱さはモデルの容量不足として語られることが多かったものの、この結果は、事実自体はパラメータ内に存在しているが、アクセスしづらいだけという可能性を示していると考えられます。
もう1つは「reversal curse(逆転の呪い)」として知られる現象です。「AはBである」と学習したモデルが「Bとは何か」という逆方向の質問には答えられないという課題ですが、今回の分析では、多肢選択式の認識タスクでは逆方向の質問も順方向と同程度、あるいはそれ以上に解けるのに対し、自由記述形式の想起タスクでは逆方向の質問が一貫して難しいという結果が示されました。選択肢の中から正解を見分けられるということは、その知識自体は符号化・認識できていることを意味するため、この現象は知識の欠如というより、学習時に出会った文脈や方向性から外れた問い方をされたときに想起がうまく働かないという、想起特有の問題だと整理されています。
「思考」は想起を助ける回復装置になり得るか
思考を有効にした場合の効果も検証されています。思考(モデルが最終的な答えを出す前に中間的な推論過程を経ること)は、直接の想起が弱い場面ほど効果を発揮しやすく、ロングテールな事実やreversal curseのギャップを狭める傾向が確認されました。思考最適化モデルでは、符号化済みだが直接は想起できなかった事実のうち40〜65%を思考によって正答へ導けた一方、そもそも符号化されていない事実に対しては5〜15%程度の改善にとどまっています。
この結果からは、思考は主に「モデルがすでに持っている知識へアクセスしやすくする」ための仕組みとして機能しており、複雑な多段階推論によってゼロから答えを導き出しているわけではないと考えられます。ただし、思考には計算コストがかかるため、どのような場面で思考を使うべきかの判断は依然として難しい課題として残ると考えられます。
まとめ
Google Researchの分析は、フロンティアモデルの事実誤りが「知識の欠如」よりも「知識の利用」の問題に移りつつあることを示しています。モデルの規模拡大だけでなく、すでに持っている知識をどう引き出すかという観点が、今後の精度向上の鍵になると考えられます。