はじめに
OpenAIが公開するPrompt Cachingガイドでは、GPT-5.6以降に明示的なcache breakpointと新しい課金体系が導入されています。本稿では、安定した前置きを再利用するリクエスト構造、設定例、監視指標、キャッシュが効かない場合の確認点を解説します。
参考記事
- タイトル: Prompt caching
- 発行元: OpenAI Developers
- 発行日: 記載なし(2026年8月15日確認)
- URL: https://developers.openai.com/api/docs/guides/prompt-caching#improve-cache-hit-rates-with-a-prompt-cache-key
要点
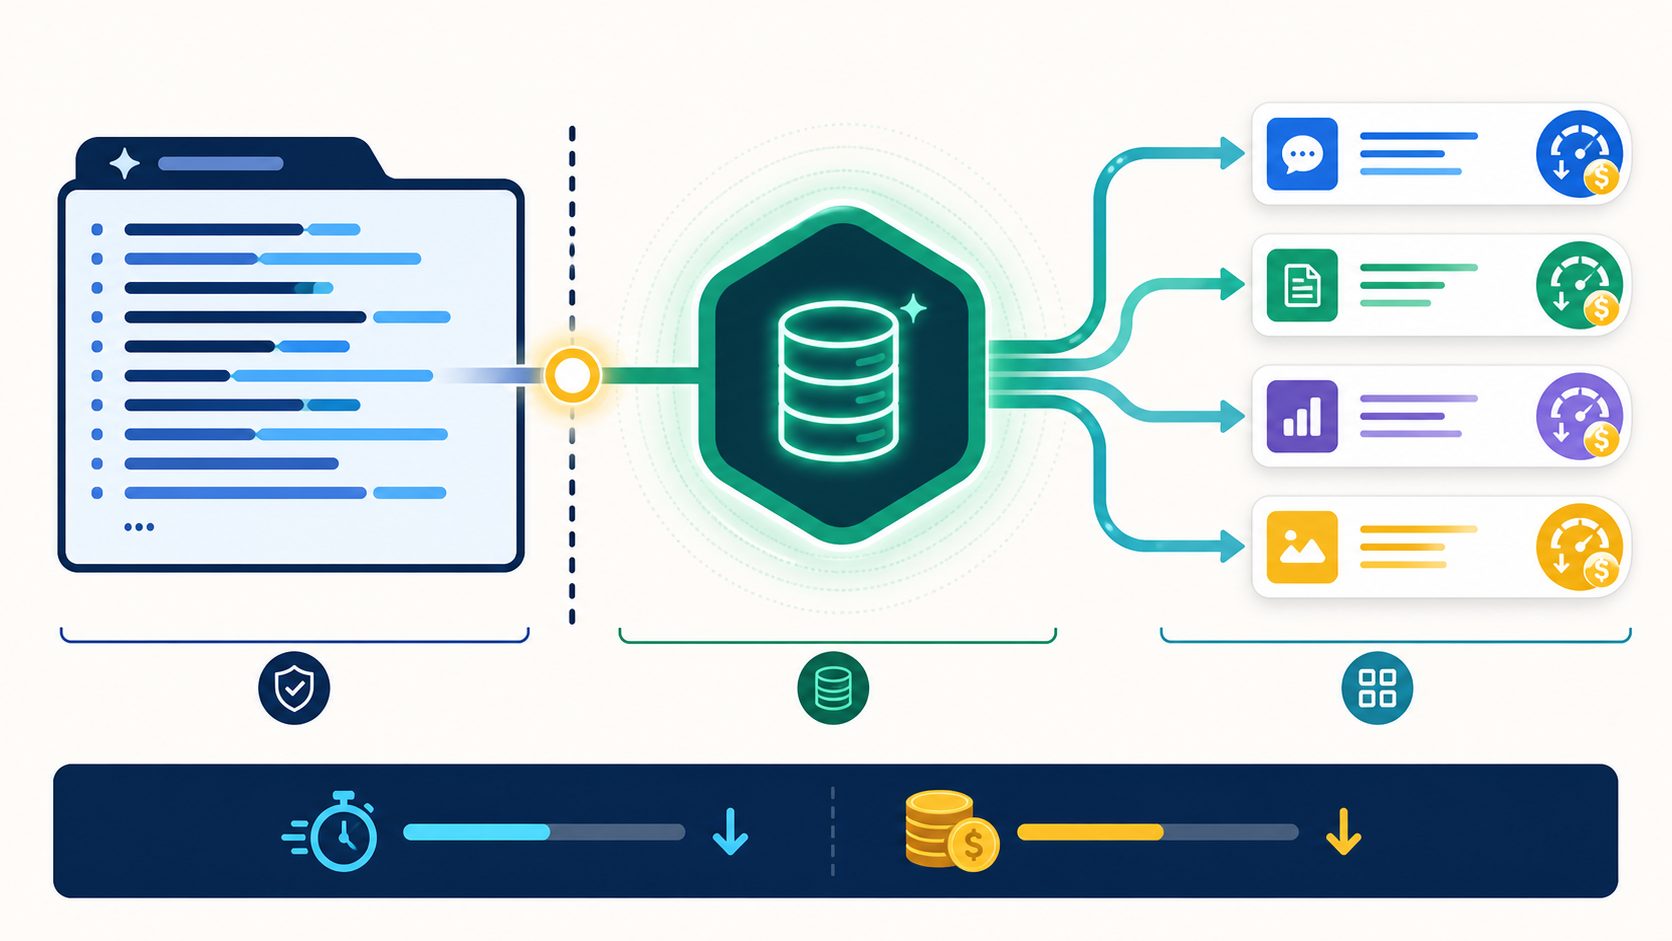
- Prompt Cachingは完全に一致するプロンプト前方部分を再利用し、入力遅延と料金を抑える機能である
- GPT-5.6以降は、breakpointまでの前置きが1,024トークン以上であることがキャッシュ条件である
- implicit modeは最新のuserまたはtool messageにも自動breakpointを置き、explicit modeは明示箇所だけを対象にする
- キャッシュ読み出しは通常入力の0.1倍、書き込みは1.25倍で、cached_tokensとcache_write_tokensから効果を確認できる
- prompt_cache_keyは同じ前置きを持つ通信の経路をそろえるが、異なる前置きを一致させる機能ではない
詳細解説
完全一致する前方部分だけが再利用される
Prompt Cachingは、systemやdeveloperの指示、共通資料、会話履歴など、リクエストの先頭から連続して一致する部分を再利用します。途中に時刻、利用者ID、要求IDなどの可変値が入ると、その後ろが同じでも一致しません。静的な指示、例、ツール定義、構造化出力schema、共通画像を前へ置き、利用者固有の入力を後ろへ置くことが基本です。
画像の順序やdetail設定、tools配列の順序、parameter schemaも前置きへ含まれます。呼び出せるツールだけを絞りたい場合は、tools自体を入れ替えず、対応モデルではallowed_toolsを利用します。ログ用途の値は可能であればpromptではなくmetadataへ置くと、キャッシュを維持しやすくなります。
GPT-5.6のbreakpointとmode
GPT-5.6以降では、breakpointが再利用する前置きの終端を示します。既定のimplicit modeは最新のuserまたはtool messageに暗黙のbreakpointを置き、明示breakpointも併用します。会話履歴を末尾へ追加し続ける用途では、以前のbreakpointを読み出し、新しい末尾を次回向けに書き込めます。
独立したリクエストで、共通指示の後ろに毎回異なる時刻と質問を置く場合、最新メッセージだけのimplicit breakpointでは可変部分まで書き込みます。共通指示の末尾へexplicit breakpointを置き、prompt_cache_options.modeをexplicitにすると、変わる後半を新規キャッシュへ書きません。breakpointまでにレンダリングされる全体が1,024トークン以上必要です。
{

  "model": "gpt-5.6",
  "prompt_cache_key": "support:knowledge-base-v1",
  "prompt_cache_options": {
    "mode": "explicit"
  },
  "input": [
    {
      "type": "message",
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "Follow the shared support policies and reference material...",
          "prompt_cache_breakpoint": {
            "mode": "explicit

  ]

}
Responses APIのtop-level instructionsにはbreakpointを付けられません。再利用するdeveloper指示をinput_text blockとしてdeveloper message内へ置きます。explicit modeを選んでも明示breakpointが一つもなければ、キャッシュの読み書きは発生しません。
複数の更新頻度へbreakpointを分ける
共通規則は長期間変わらず、参照資料は日ごとに更新される場合、両者の末尾へ別々のbreakpointを置けます。1リクエストで新規に書き込めるbreakpointは最大4件です。implicit modeでは最新メッセージが1枠を使うため、明示breakpointの書き込みは最大3件になります。読み出しでは会話内の最新50件までを確認し、最も長く一致する前置きを使います。
breakpointを増やすこと自体に料金はかかりませんが、実際に書き込まれたトークンには課金されます。更新頻度が異なる境界だけへ置き、再利用しない可変部分を暗黙breakpointで繰り返し書いていないか確認することが重要です。
prompt_cache_keyで経路を安定させる
prompt_cache_keyは、長い共通前置きを持つリクエストを同じキャッシュへ到達しやすくするための値です。セッションIDや利用者IDなど、同じ前置きを共有する単位で安定したkeyを使います。GPT-5.6では、implicitとexplicitの両方で、keyを設定するとより確実な一致が利用できます。
keyが同じでもpromptの前置きが異なれば一致しません。また、一つのkeyへ異なる前置きの大量通信を集めるとcache missが増えます。OpenAIは、各keyに属する全前置きの合計をおよそ毎分15リクエストに保ち、高負荷時は利用者やセッションなどの安定した規則で分割するよう案内しています。
料金と指標を読み分ける
GPT-5.6以降では、cached inputが通常入力の0.1倍、cache writeが1.25倍、読み書きされない入力が通常料金です。1.25倍は通常料金に追加される額ではなく、書き込みトークンの合計単価です。キャッシュを再利用すれば30分のTTLが更新され、再書き込み料金は発生しません。
{
  "usage": {
    "input_tokens": 2600,
    "input_tokens_details": {
      "cached_tokens": 2000,
      "cache_write_tokens": 400
    }
  }
}
この例では2,000トークンを読み出し、400トークンを書き込み、残る200トークンは通常入力として処理されています。cache_write_tokensが高いままcached_tokensが低い場合、時刻や利用者入力がbreakpointより前にある可能性があります。両方がゼロなら、1,024トークン未満、過去に同じ前置きが書かれていない、keyが一致しないなどを確認します。
以前のモデルとの違い
GPT-5.6より前の対応モデルでは、1,024から2,048トークンの範囲でモデルごとに最小値が異なり、自動的に一致する前方部分を探します。cache writeの追加料金はなく、prompt_cache_retentionでin_memoryまたは対応モデルの24時間保持を選べます。自動方式でも、静的内容を前、可変内容を後ろへ置く原則は同じです。
Prompt Cachingは出力生成を省略せず、同じpromptでも非決定的な出力は変わる場合があります。cached tokensもtokens-per-minute制限へ数えられ、手動のcache削除機能はありません。費用だけでなく、遅延、cache hit率、rate limitを合わせて評価する必要があります。
まとめ
GPT-5.6のPrompt Cachingでは、安定した前置きの末尾へbreakpointを置き、同じprefixへ同じkeyを割り当てる設計が重要です。cached_tokensとcache_write_tokensを継続的に計測し、可変情報の位置、implicitな書き込み、高負荷時のkey分割を調整すると効果を確認しやすいと思います。