はじめに
Google Researchは2026年3月31日、機械学習モデルの評価における再現性向上のための研究成果を発表しました。本稿では、限られた評価予算のなかで評価者数(K)と評価項目数(N)をどう最適化するか、その手法と実践的な意味合いについて解説します。
参考記事
- タイトル: Building better AI benchmarks: How many raters are enough?
- 著者: Flip Korn, Chris Welty(Research Scientists, Google Research)
- 発行元: Google Research Blog
- 発行日: 2026年3月31日
- URL: https://research.google/blog/building-better-ai-benchmarks-how-many-raters-are-enough/
〇GitHub:https://github.com/google-research/vet
要点
- AIベンチマークの再現性は、人間のアノテーター間の意見のばらつきに大きく左右される
- 従来広く使われてきた「1〜5人」という評価者数は、人間の意見のニュアンスを十分に捉えられないことが多い
- 測定する指標によって最適な評価者数・項目数の比率は異なり、ニュアンスの把握には10人以上の評価者が必要になるケースがある
- 比率を正しく設定すれば、総アノテーション数が約1,000件程度でも統計的に有意な再現性を達成できる
- 研究チームはオープンソースのシミュレーターをGitHubで公開している
詳細解説
再現性の課題:人間の意見のばらつきが見落とされてきた
機械学習における再現性とは、同じコード・データ・設定で実験を繰り返したとき、同じ結果が得られる度合いを指します。再現性が高ければチーム間の信頼が生まれ、研究の積み重ねが可能になります。
しかし、AIの評価データは人間によるラベル付けに依存しており、人間は同じ問題に対して異なる判断を下すことが少なくありません。これは倫理的な判断や有害コンテンツの検出といった主観的なタスクで特に顕著です。Google Researchによれば、この人間の意見のばらつきを事実上無視している現状の評価手法は、AI分野全体で長らく見落とされてきた課題だとされています。
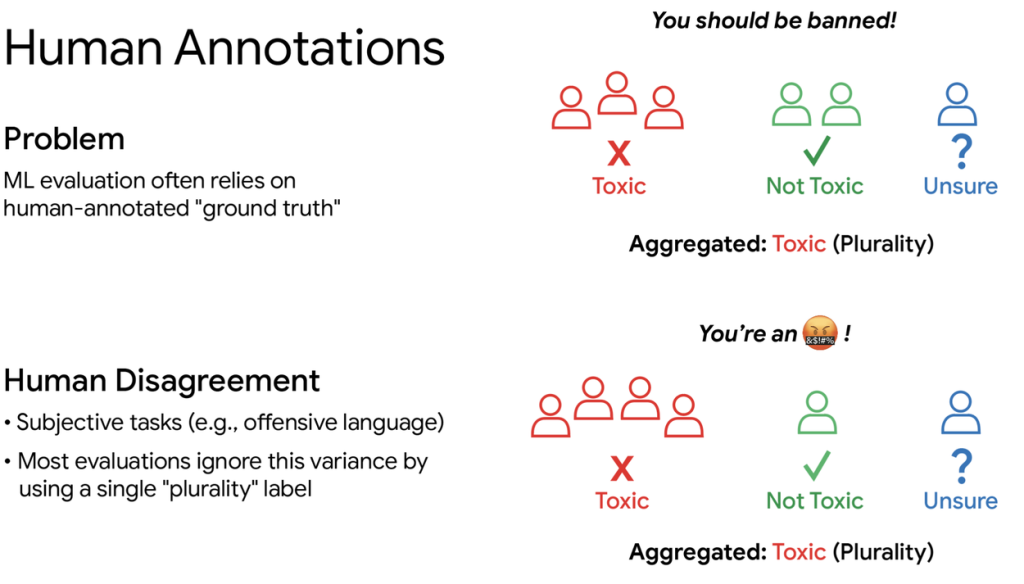
典型的な問題として「多数決による単一ラベル化」があります。たとえば、6人中4人が「有害」と判断したケースと、6人全員が「有害」と判断したケースが、いずれも「有害」という同一ラベルで処理されてしまいます。この単純化によって、意見の分布に関する重要な情報が失われてしまうと考えられます。
実験設計:「森」と「木」のトレードオフ
Google Researchの研究チームは、評価予算が限られた中で「どの比率が最も信頼性の高い結果をもたらすか」を体系的に検討しました。研究では主に2つの変数を操作しています。
- N(スケール): 評価する項目の総数(100〜50,000件)
- K(クラウド): 同一項目を評価する人数(1〜500人)
研究チームはこのトレードオフを「森(Forest)」と「木(Tree)」のアプローチとして説明しています。「森」アプローチは1,000人が各自1品ずつ料理を試してレストラン全体の質を評価するイメージで、幅広い項目をカバーします。一方、「木」アプローチは20人が同じ50品を試食して特定の料理を深く評価するイメージです。歴史的にAI評価は「森」寄りの設計が主流で、1〜5人の評価者数が一般的な慣行とされてきました。
実験では、毒性(Toxicity:107,620件のSNSコメントを17,280人が評価)、AIチャットボットの安全性(DICES:350件の会話を123人が16次元で評価)、文化横断的な不快感評価(D3code:21か国4,309人による4,554件)、求人関連ツイート(Jobs:2,000件を5人が評価)という4つの実データセットが使われました。Google Researchはこれらを用いて数千通りの組み合わせをシミュレートし、どの設定が統計的に有意(p値 < 0.05)な結果を安定して生み出すかを検証しています。
主要な知見:3つのインサイト
1. 「3〜5人」という慣行は不十分なことが多い
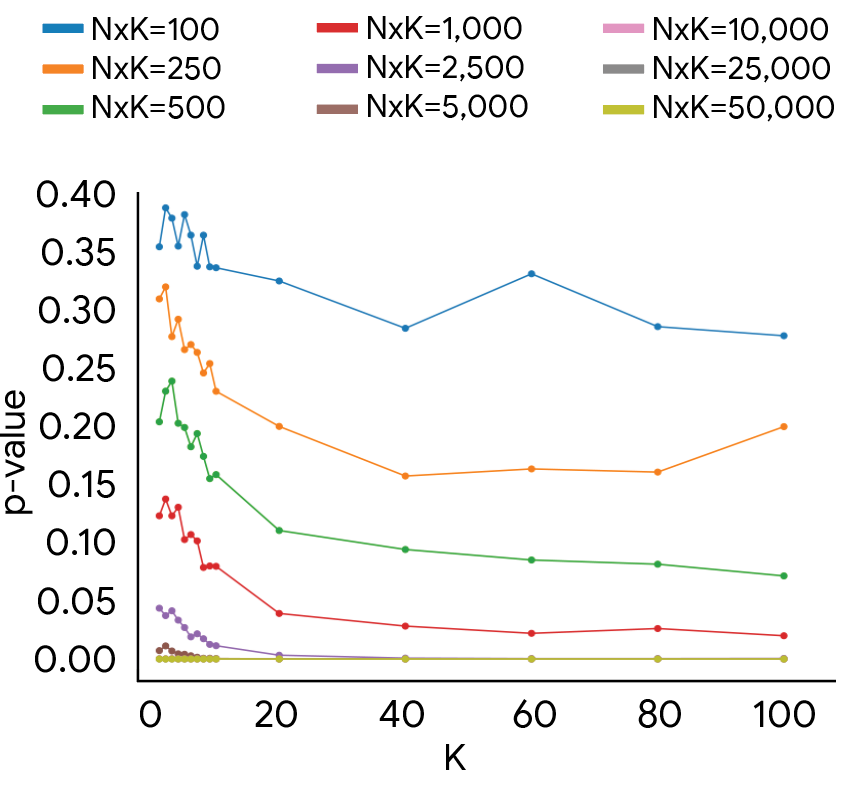
Google Researchの分析によれば、評価者数が1〜5人では人間の意見の全体像も個別の深みも十分に捉えられないことが多いとのことです。ニュアンスを含む主観的なタスクでは、10人以上の評価者が必要になるケースが多いとされています。評価者を増やすにつれてp値が統計的有意水準に近づくという結果も示されており、現在の業界標準を見直す必要があると考えられます。
2. 測定指標によって最適な戦略は異なる
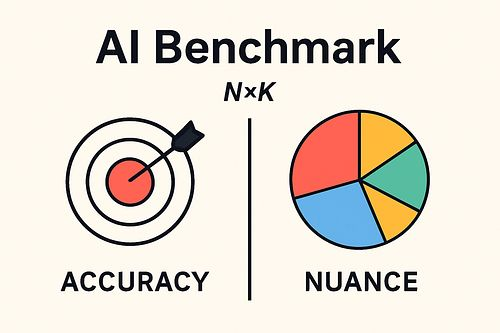
「これが正解」という万能な比率は存在せず、目的に応じた使い分けが重要です。モデルが人間の多数派意見と一致するかを確認したい場合(精度重視)は「森」アプローチが有効で、項目数を増やすことが効果的です。一方、意見の分布や「賛否が拮抗している」といったニュアンスを把握したい場合は「木」アプローチが適切で、同一項目への評価者を増やすことが唯一の方法とされています。
3. 適切な比率なら限られた予算でも再現性を達成できる
Google Researchによれば、N×Kの比率を正しく設定することで、総アノテーション数が約1,000件程度でも高い再現性を達成できることが示されました。一方、比率の設定を誤ると、予算を増やしても信頼性の低い結論しか得られない可能性があるとのことです。研究チームが開発したシミュレーターはGitHubでオープンソースとして公開されており、実務での活用が可能です。
AI評価の根本的な前提を問い直す
この研究が提起しているのは、AI評価の根本的な前提に関わる問いです。これまでの分野では「すべての入力に対して唯一の正しいラベルが存在する」という前提のもとで評価が行われてきました。しかし、倫理的判断や有害なコンテンツの識別など主観的な領域にAIが進出するにつれて、その前提が成立しにくくなっています。
本研究が提供するのは、「人間がどこで一致するか」だけでなく「なぜ意見が割れるのか」を理解するための数理的なツールです。評価者間の不一致を「ノイズ」として排除するのではなく、「信号」として正面から取り扱う設計思想が、今後のより信頼性の高いAIベンチマーク構築に必要と考えられます。
まとめ
Google Researchは、AIベンチマークにおける評価者数と項目数の最適バランスを分析した研究を発表しました。従来の「3〜5人」という慣行を見直し、測定目的に応じた比率を設計することが再現性と効率の両立につながると考えられます。シミュレーターの公開により、実務でも試しやすい環境が整いつつあります。