はじめに
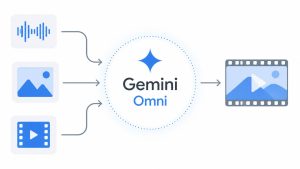
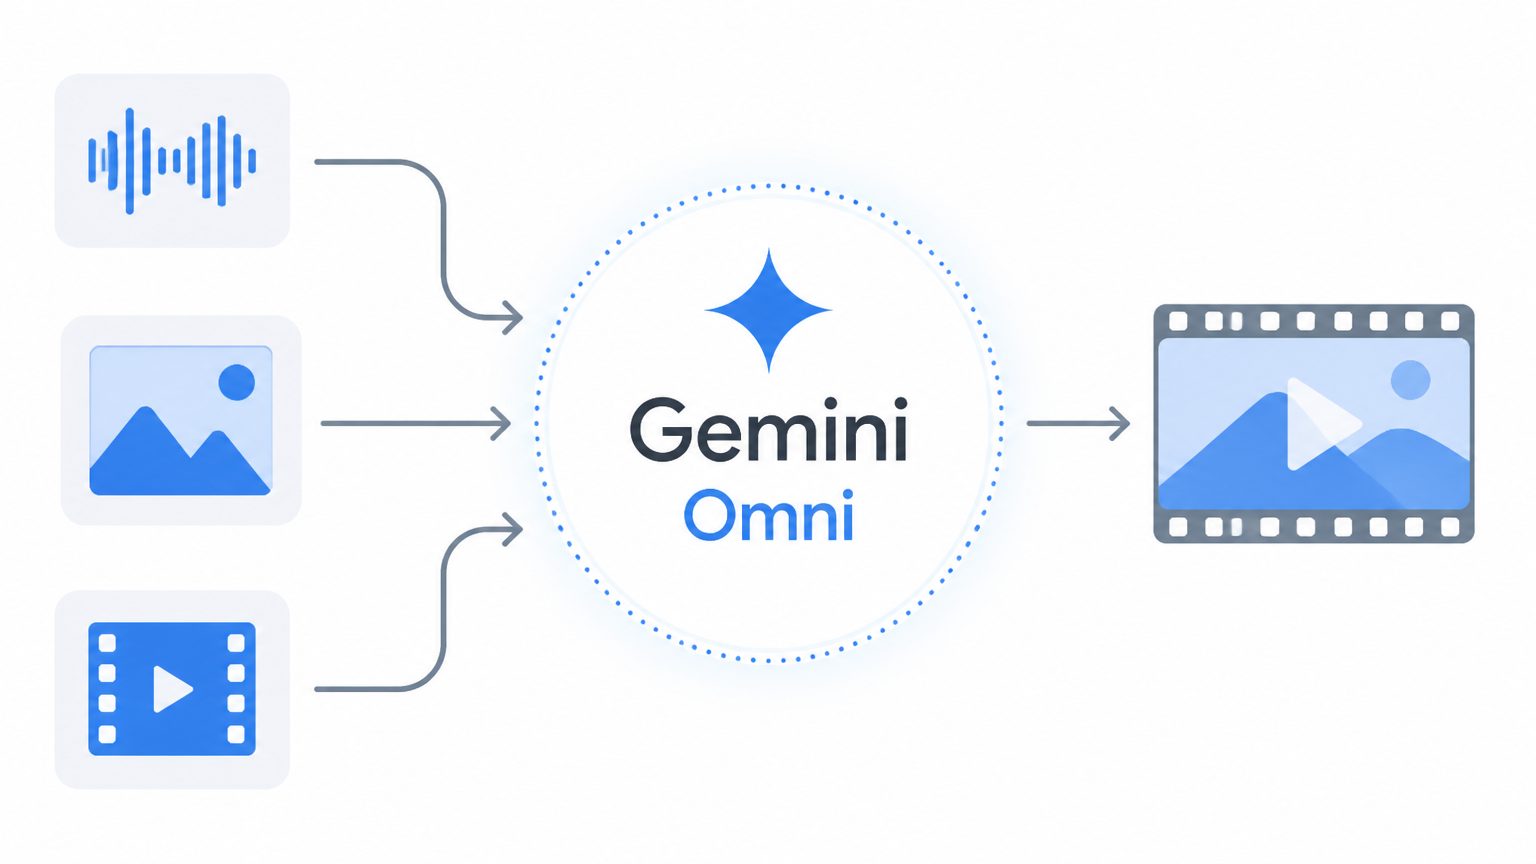
GoogleのCTO・Koray Kavukcuoglu氏が2026年5月、あらゆる入力からコンテンツを生成できる新モデルファミリー「Gemini Omni」を発表しました。本稿では第1弾の「Gemini Omni Flash」を中心に、自然言語による動画編集機能、マルチ入力対応、提供状況について解説します。
参考記事
- タイトル: Introducing Gemini Omni
- 著者: Koray Kavukcuoglu(CTO, Google DeepMind and Chief AI Architect, Google)
- 発行元: Google(blog.google)
- 発行日: 2026年5月
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
関連記事
要点
- Gemini Omni Flashは、画像・音声・動画・テキストを組み合わせて入力し、高品質な動画を生成・編集できる新モデルである
- 自然言語による複数ターンの動画編集が可能で、前の指示を引き継ぎながら登場人物の一貫性や物理的な整合性を維持する
- 重力・運動エネルギー・流体力学などの物理法則への理解が向上し、よりリアルな映像表現を実現する
- Google AI Plus・Pro・Ultraサブスクライバー向けにGeminiアプリとGoogle Flowで提供開始され、YouTube ShortsとYouTube Createアプリのユーザーには無料で展開される
- 生成されたすべての動画にはSynthIDによる電子透かしが付与され、AI生成コンテンツであることを識別できる
詳細解説
Gemini Omniとはなにか
昨年、Googleは画像生成・編集モデル「Nano Banana」(Gemini向け)を投入し、古い写真の修復やスケッチからのデザイン生成を可能にしました。Gemini Omniはその延長線上に位置する新モデルファミリーで、「推論する能力」と「創造する能力」を統合することをコンセプトとしています。画像・音声・動画・テキストのいずれかまたは組み合わせを入力として受け取り、高品質な動画を出力します。Google Flowでの動画生成においては、Googleが継続的に取り組んできた動画生成ツールの進化とも連続する動きと言えます。
会話で進める複数ターンの動画編集
Gemini Omniの中心的な機能は、自然言語による動画編集です。Googleによれば、指示のたびに文脈が引き継がれ、登場人物の一貫性・物理的な整合性・シーンの記憶が保持されます。例えば「鏡に触れた瞬間、鏡が液体のように波紋を作り、腕が鏡面素材に変わるようにして」と指示するだけで映像表現が変化します。また、複数ターンにわたって環境・アングル・スタイルを変えていくことが可能で、最初のシーンの文脈を失わずに仕上げていける点が特徴です。従来の動画編集ソフトでは個別のツールや専門知識が求められていましたが、この方式では対話的な指示だけで映像を作り込んでいけると考えられます。
物理法則の理解と知識との融合
Omniは重力・運動エネルギー・流体力学といった物理法則をより直感的に理解しており、例えば「鎖式トラックを滑らかに転がるビー玉」のような映像でも物理的に整合した表現が可能です。さらに、Geminiが持つ歴史・科学・文化的な知識と映像生成を結び付けることも特徴の一つです。「タンパク質の折り畳みをクレイアニメで正確に説明する動画」のように、複雑な概念を視覚化したコンテンツも短いプロンプトから生成できます。この「知識の埋め込まれた映像生成」は、教育・コンテンツ制作の現場での活用可能性があると思います。
マルチ入力による動画制作
Omniでは、特定のキャラクターや場所の画像を参照として渡したり、既存動画の映像スタイルや動きを参考にしたりすることで、自分の素材を起点にした動画制作が行えます。入力素材としては画像・テキスト・動画・音声に対応していますが、Googleによれば音声参照については当面ボイスリファレンスのみの対応となっており、その他の音声入力は順次拡張予定とのことです。スタイルや動きのエフェクトを自然言語で指定する方法と、参照素材から継承させる方法の2通りを使い分けられる点は柔軟性が高いと思います。
アバター機能とコンテンツの透明性
Avatars機能として、自分の声をもとにデジタルアバターを作成し、自分に似た映像を生成できる機能が提供されます。Googleによれば、音声・台詞を自由に変更する編集機能については責任ある形で提供できるよう検討中とのことです。コンテンツの透明性については、Omniで生成されたすべての動画にGoogleのSynthIDによる電子透かしが自動的に付与されます。Geminiアプリ・Gemini in Chrome・Google検索を通じて、AI生成コンテンツであることを確認できます。フェイク動画への懸念が高まる中、透明性確保の仕組みをモデルに組み込む姿勢は注目に値すると思います。
提供状況
Gemini Omni Flashは今回より、Google AI Plus・Pro・Ultraのサブスクライバー向けにGeminiアプリおよびGoogle Flowで提供開始されます。また今週中に、YouTube ShortsとYouTube Createアプリのユーザーにも無料で展開される予定です。開発者・エンタープライズ向けのAPIについては数週間以内に提供予定とのことです。
まとめ
Gemini Omni Flashは、テキストだけで動画を段階的に作り込める新しい体験を示すモデルだと思います。物理表現の精度向上やSynthIDによる透明性確保を含め、今後APIが公開された際の開発者・クリエイターへの影響が注目されます。動画生成モデルの技術背景をより詳しく知りたい方は、Veo 3.1を活用した動画生成の解説もあわせてご覧いただければと思います。