はじめに
Google ResearchとBeth Israel Deaconess Medical Center(BIDMC)が共同で、会話型医療AI「AMIE」の実臨床環境における実現可能性を初めて検証しました。2026年3月11日に発表されたこの前向き臨床試験の結果について、本稿で詳しく解説します。
参考記事
- タイトル: Exploring the feasibility of conversational diagnostic AI in a real-world clinical study
- 著者: Mike Schaekermann(Research Lead, Google Research)、Alan Karthikesalingam(Director/Principal Scientist, Google DeepMind)
- 発行元: Google Research Blog
- 発行日: 2026年3月11日
- URL: https://research.google/blog/exploring-the-feasibility-of-conversational-diagnostic-ai-in-a-real-world-clinical-study/
要点
- AMIEが外来診療前ヒアリングとして100名の患者と対話し、全インタラクションを通じて人間のAIスーパーバイザーによる安全停止(セーフティストップ)はゼロだった
- 受診8週後のチャートレビューと照合した鑑別診断の正答率は、上位7候補内で90%、上位3候補内で75%、単一最有力診断としての正答率は56%だった
- 鑑別診断と管理計画の総合的な質については、AMIEとプライマリケア医(PCP)の間にブラインド評価で有意差は見られなかった
- 管理計画の実用性と費用対効果ではPCPがAMIEを上回る結果となった
- 患者はAMIEとの対話後にAIに対する態度が有意に改善し、その水準は医師との診察後も維持された
詳細解説
AMIEとは何か——研究の背景
AMIE(Articulate Medical Intelligence Explorer)は、Googleが開発する診断推論と医療対話に特化した会話型医療AIです。これまでの研究は主にシミュレーション環境での評価——専門医による診断チャレンジの支援や患者俳優との対話実験——にとどまっていました。
Natureに掲載された最近のレビュー論文も指摘するように、医療AIを実際の診療に組み込むためには、現実のワークフローでの評価が不可欠です。今回の研究は、その「シミュレーションから実証へ」という移行を担う最初の前向き臨床試験として設計されました。
研究の設計——どのように実施されたか
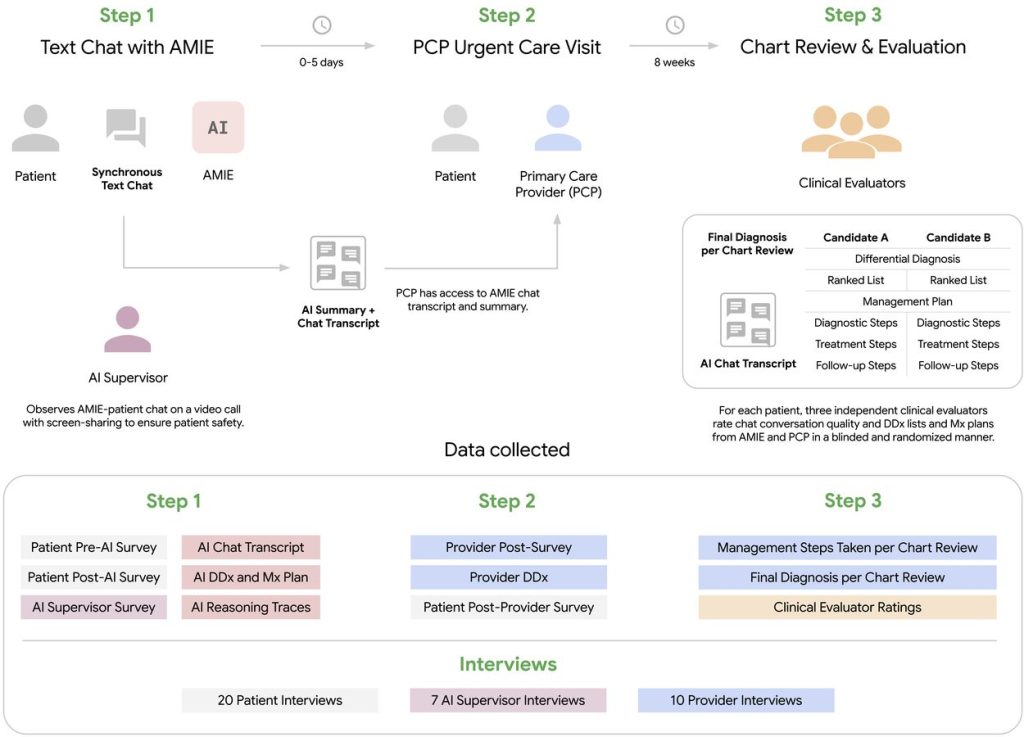
本研究は事前登録済み・IRB(倫理審査委員会)承認済みの前向き単施設実現可能性試験として実施されました。BIDMCにおける外来一次診療(新規・非緊急・エピソード性の主訴)の予約患者を対象に、AMIEが受診前のヒアリング(病歴聴取)を担当しました。
患者はセキュアなウェブリンク経由でAMIEとテキストチャットを行い、「AIスーパーバイザー」と呼ばれる専任の医師がライブビデオ通話で対話全体を監視しました。スーパーバイザーが介入を判断する安全基準として、(1)自傷他害の懸念、(2)AI対話に起因する著しい精神的苦痛、(3)臨床的危害の可能性、(4)患者からの中断要求——の4項目が事前に定められていました。対話終了後、AMIEが生成した要約と文字起こしは患者の同意を得たうえで担当PCPに提供され、診察前の情報として活用されました。
医師トレーニングにおける指導医監督(研修医が指導医の監視のもとで患者と対話する仕組み)に類似したこの体制は、臨床安全を確保するうえでの現実的なアプローチと言えます。
安全性の結果——ゼロ件のセーフティストップ
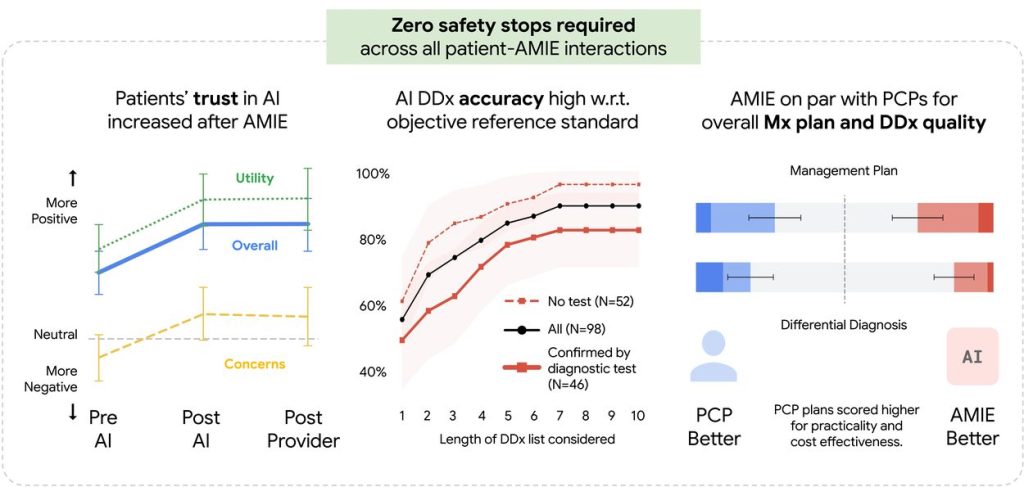
Google Researchによれば、100名の患者(うち98名が実際に受診)との全インタラクションを通じて、安全停止は一件も発生しませんでした。これは、監視体制を伴う現実の診療環境においてAMIEが会話上の安全性を維持できることを示す、初めての実世界的な証拠です。
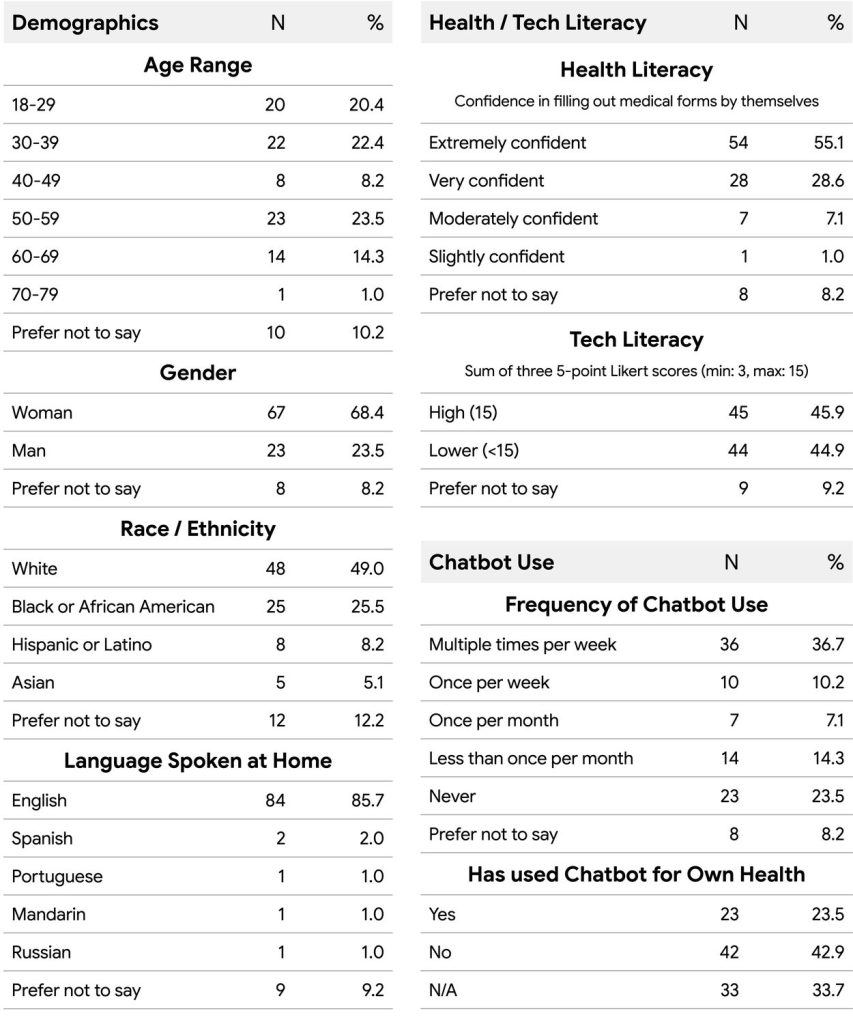
参加患者は年齢・人種・民族・健康リテラシー・テックリテラシー・チャットボット利用経験においてさまざまな背景を持っていました。ただし研究参加者は若年層に偏る傾向があり(全外来受診者の半数以上が60歳以上であったのに対し)、多様な集団への一般化については引き続き検討が必要と考えられます。
診断精度と管理計画——PCPとの比較評価
臨床評価の中核として、研究に直接関与していない医師パネルが、AMIEとPCPの鑑別診断(DDx)と管理計画(Mx)をブラインド・ランダム化方式で採点しました。各症例は3名の臨床評価者が評価し、中央値を集計する形で結果がまとめられています。
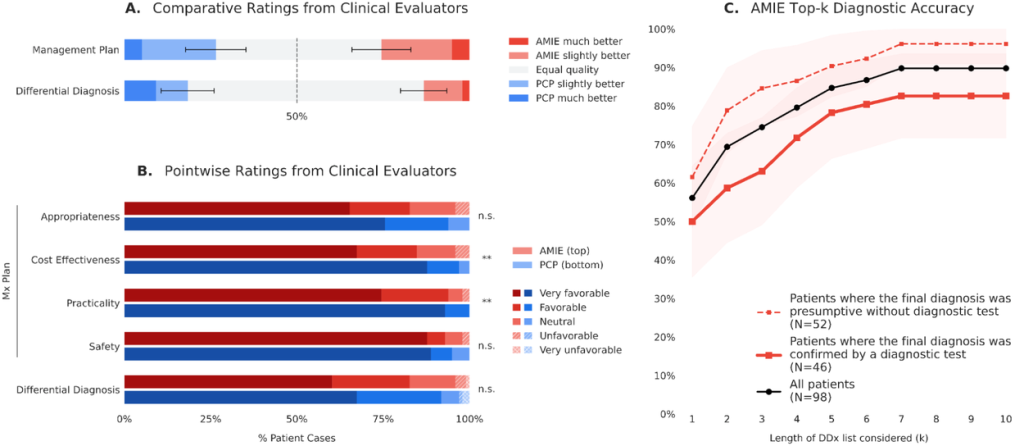
Google Researchの報告では、DDx全体の質とMx計画の適切性・安全性についてはAMIEとPCPの間に有意差は見られませんでした。一方、管理計画の実用性と費用対効果についてはPCPが優れた評価を得ました。この差異は、AMIEが電子カルテ(EHR)へのアクセスを持たず、身体診察が行えず、患者の外見など非言語的・多モーダルな情報を統合できないという文脈の違いから説明されています。PCPはこうした豊富な文脈情報を活かして、より現実的・経済的な管理計画を立案できると考えられます。
AMIEの診断精度については、受診から8週後に行われたチャートレビューで確定された最終診断と照合した結果、上位7候補内での正答率は90%、上位3候補内で75%、単一最有力診断としての正答率は56%でした。最終診断が検査(臨床検査・微生物検査・病理検査・画像検査)や専門医紹介によって確認された46例のサブグループでも、高い精度が維持されました。
患者と医師の体験——信頼と有用性
患者はAMIEとの対話前後および医師診察後の3時点で、AIへの態度を測定するGAAIS(General Attitudes towards AI Scale:AIに対する全般的態度尺度)に回答しました。AMIEとの対話後には、知覚される有用性とAIへの懸念の両サブスケールで統計的に有意な改善が見られ、その水準は医師診察後も維持されました。
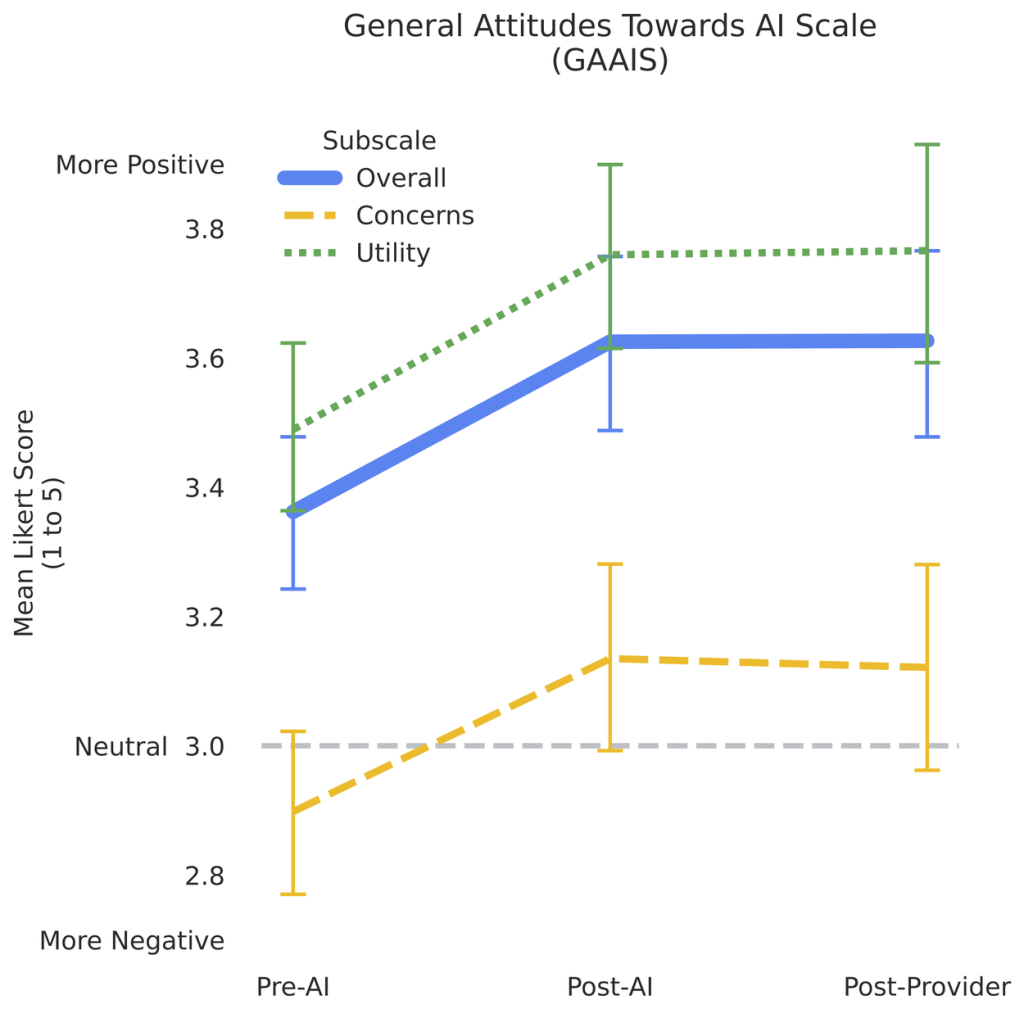
患者アンケートおよびインタビューでは、AMIEが丁寧で医療状態の説明が分かりやすいという高い満足度が報告されています。PCPからは、AMIEが生成した事前要約が診察準備に役立ち、単純なデータ収集から「データの確認」へと診察のダイナミクスが変化したことで、患者との協働的な対話と共同意思決定が促進されたという評価が得られています。
研究の限界と今後の方向性
本研究は単施設・単群の実現可能性試験であり、対照群を設けていないため、AIを導入しない通常のワークフローとの定量的な比較はできません。また、テキストのみのチャット形式は、音声・映像・非言語的情報を含む実際の臨床コミュニケーションの豊かさを十分に再現できていません。健康リテラシーやテックリテラシーが異なる集団への影響についても、引き続き研究が必要とされています。
Googleはすでに全国規模のランダム化比較試験に向けた取り組みを進めており、今後の研究でこれらの課題に取り組むことが予告されています。
まとめ
今回の研究は、会話型医療AIが現実の外来診療において安全かつ受け入れられる形で機能し得ることを示す、初めての前向き実証データを提供するものです。単施設・単群という制約はあるものの、ゼロ件のセーフティストップと患者・医師双方からのポジティブな評価は、今後のより大規模な検証への重要な基盤として注目されます。