はじめに
GitHubは2026年3月9日、AIエージェントをCI/CDパイプラインで安全に実行するための「GitHub Agentic Workflows」のセキュリティアーキテクチャを公式ブログで詳説しました。本稿では、その脅威モデルと設計思想、実装上の重要ポイントを解説します。
参考記事
- タイトル: Under the hood: Security architecture of GitHub Agentic Workflows
- 著者: Landon Cox、Jiaxiao Zhou
- 発行元: GitHub Blog
- 発行日: 2026年3月9日
- URL: https://github.blog/ai-and-ml/generative-ai/under-the-hood-security-architecture-of-github-agentic-workflows/
要点
- GitHub Agentic WorkflowsはGitHub Actions上に構築され、エージェント実行をCI/CDモデルの延長として位置づけている
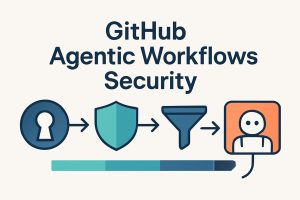
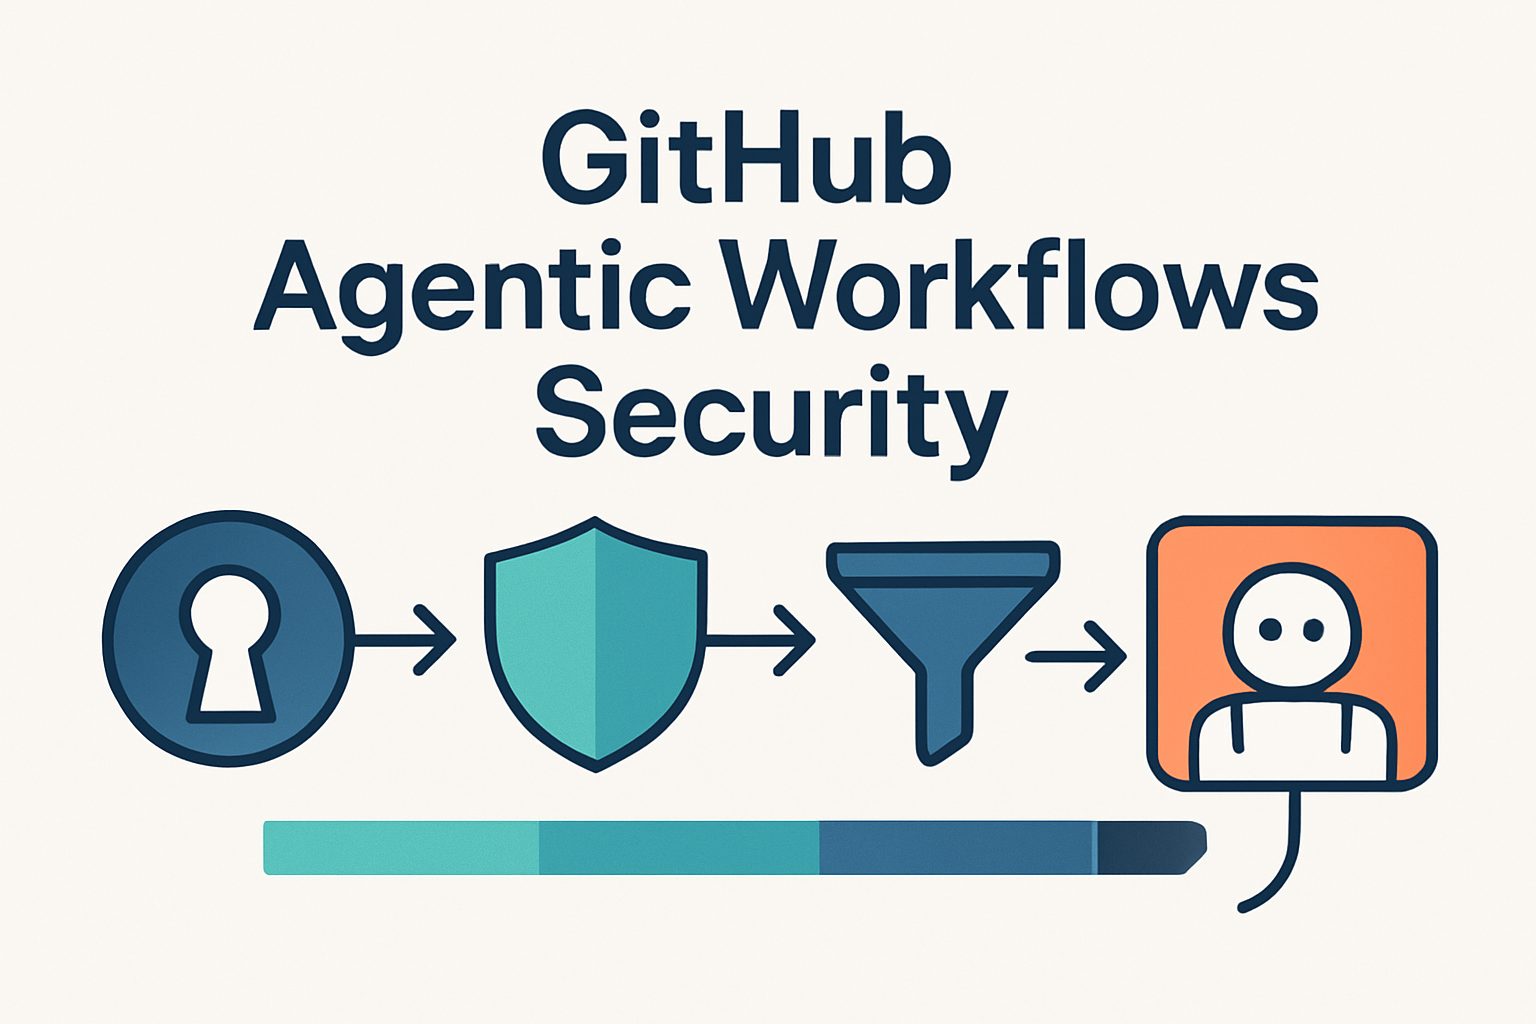
- セキュリティ設計は「多層防御」「エージェントに秘密情報を渡さない」「すべての書き込みを審査する」「すべてをログに記録する」の4原則からなる
- エージェントはLLMの認証トークンにアクセスできない構成で、専用コンテナとAPIプロキシで隔離される
- セーフアウトプット機能により、書き込み操作の種類・件数・内容がすべて事前に制限・審査される
- ファイアウォール、APIプロキシ、MCPゲートウェイの各トラストバウンダリで包括的なログが収集される
詳細解説
GitHub Agentic Workflowsとは
GitHub Agentic Workflowsは、GitHub Actions上でAIエージェントを動かすための仕組みです。ドキュメント修正、単体テストの追加、リファクタリング提案といった作業を自律的に実行できる一方、エージェントはリポジトリへのアクセス権とインターネット接続を持つため、セキュリティ上の課題が生じます。
GitHubによれば、エージェントは非決定論的であり、信頼されていない入力を処理しながらリポジトリの状態を推論してランタイムで判断を下します。通常のGitHub Actionsは単一のトラストドメインを共有する設計で、これは決定論的な自動化には便利ですが、エージェントと組み合わせると問題発生時の影響範囲が広がる可能性があります。この点がAgentic Workflowsの独自のセキュリティ設計が必要とされる背景です。
脅威モデル:エージェントをデフォルトでは信頼しない
GitHubは、エージェントが意図しない状態の読み書きを試みたり、想定外のチャネルで通信したり、正規チャネルを悪用したりすると仮定した脅威モデルを採用しています。この前提のもと、デフォルトで厳格なセキュリティモードが適用され、4つのセキュリティ原則が設計の指針となっています。
これは、エージェントを悪意ある存在とみなすのではなく、プロンプトインジェクション攻撃や予期せぬ動作に対して耐性を持たせるという現実的なアプローチと言えます。外部から悪意あるコンテンツを注入されたエージェントが意図しない動作をするリスクは、現状のLLMベースのシステムでは避けられない課題です。
第1原則:多層防御(Defense in Depth)
GitHubによれば、Agentic Workflowsは基盤(Substrate)・設定(Configuration)・計画(Planning)の3層アーキテクチャで構成されています。
基盤層はGitHub ActionsランナーVMと複数の信頼されたコンテナで成り立ち、コンポーネント間の隔離、権限付き操作の仲介、カーネルによる通信境界の強制を担います。ユーザーレベルのコンポーネントが侵害されてコンテナ内で任意のコードを実行しても、この層の保護は維持されます。
設定層は宣言的な定義ファイルとそれを解釈するツールチェーンで構成され、どのコンポーネントを使用し、どう接続し、どのような通信チャネルを許可し、どの権限を与えるかを管理します。計画層は、ワークフローを明示的なデータ交換を伴うステージに分解する役割を担います。各層が上位層の障害による影響を制限するため、単一の層が突破されても全体への影響を抑えられます。
第2原則:エージェントに秘密情報を渡さない
エージェントはプロンプトインジェクションに脆弱です。攻撃者が悪意あるウェブページやリポジトリのissueを通じてエージェントを操作し、シェルコマンドツールを使って設定ファイルやSSHキー、ワークフローログから認証情報を読み取り、GitHubのissueやプルリクエストにエンコードして外部に送信させる可能性があります。
これを防ぐため、GitHubはエージェントを専用コンテナ内で動作させ、3段階の経路制御を設けています。まず、ファイアウォールによるインターネットアクセスの制限。次に、MCPゲートウェイを介したMCPサーバーへのアクセス(MCP認証情報はゲートウェイコンテナが排他的に保持)。そして、LLMの認証トークンはAPIプロキシコンテナに格納し、エージェントコンテナからは直接見えない構成にしています。Claude、Codex、CopilotなどのエージェントがLLMと通信する際は、このプロキシ経由でトラフィックがルーティングされます。
コーディング作業に必要なコンパイラやインタープリタ、リポジトリへのアクセスは、ホストファイルシステムをコンテナにリードオンリーでマウントし、エージェントをchrootジェイル内で実行することで対応しています。エージェントの書き込み可能・参照可能な範囲を必要最小限に絞りつつ、既存のActionsプロビジョニングの仕組みを維持できる設計です。
第3原則:すべての書き込みをステージングして審査する
秘密情報へのアクセスがなくても、プロンプトインジェクションを受けたエージェントがリポジトリに大量のissueやプルリクエストを作成したり、不適切なURLを含むコンテンツを投稿したりするリスクは残ります。これを防ぐのがセーフアウトプット(Safe Outputs)の仕組みです。
GitHubによれば、ワークフローのコンパイラがワークフローを明示的なステージに分解し、各ステージで有効なコンポーネントと権限、排出されるデータ成果物、それを受け取れる下流コンポーネントが定義されます。エージェントの実行中、GitHub MCPサーバーを通じてリポジトリの状態を読み取ることはできますが、書き込みはセーフアウトプットMCPサーバーを経由してバッファリングされます。
セーフアウトプットは3段階の審査を行います。第一に、ワークフロー作成者が許可する書き込み操作の種類(issue作成、コメント、プルリクエストなど)を指定できます。第二に、1回の実行で許可する更新件数を制限できます(例:プルリクエストの作成を最大3件まで)。第三に、URLの除去などの出力サニタイズを含むコンテンツ分析を行います。このパイプライン全体を通過した成果物のみが次のステージに渡されます。
第4原則:すべてをログに記録する
ゼロシークレットと書き込み審査があっても、エージェントが予期しない方法でデータを変換したり、制約を回避しようとしたりする可能性は残ります。GitHubによれば、各トラストバウンダリで広範なログが収集されます。ファイアウォール層ではネットワーク・宛先レベルのアクティビティ、APIプロキシではモデルリクエスト/レスポンスのメタデータ、MCPゲートウェイとMCPサーバーではツール呼び出し、そしてエージェントコンテナ内では環境変数アクセスなどの操作が記録されます。
これらのログはインシデント後のフォレンジック調査、ポリシー検証、異常な動作の検知を支援します。また、ログ収集箇所は将来的な情報フロー制御の基盤にもなります。GitHubは今後数ヶ月で、リポジトリオブジェクトの可視性(公開・非公開)や作成者のロールに基づいてMCPサーバー横断のポリシーを適用する追加の安全制御を導入する予定とされています。
まとめ
GitHub Agentic Workflowsのセキュリティアーキテクチャは、多層防御・ゼロシークレット・セーフアウトプット・包括的ロギングという4原則を軸に、エージェントをデフォルトで信頼しない前提で設計されています。AIエージェントをCI/CDに組み込む際のリスク管理の考え方として、実践的な参考になると思います。