はじめに
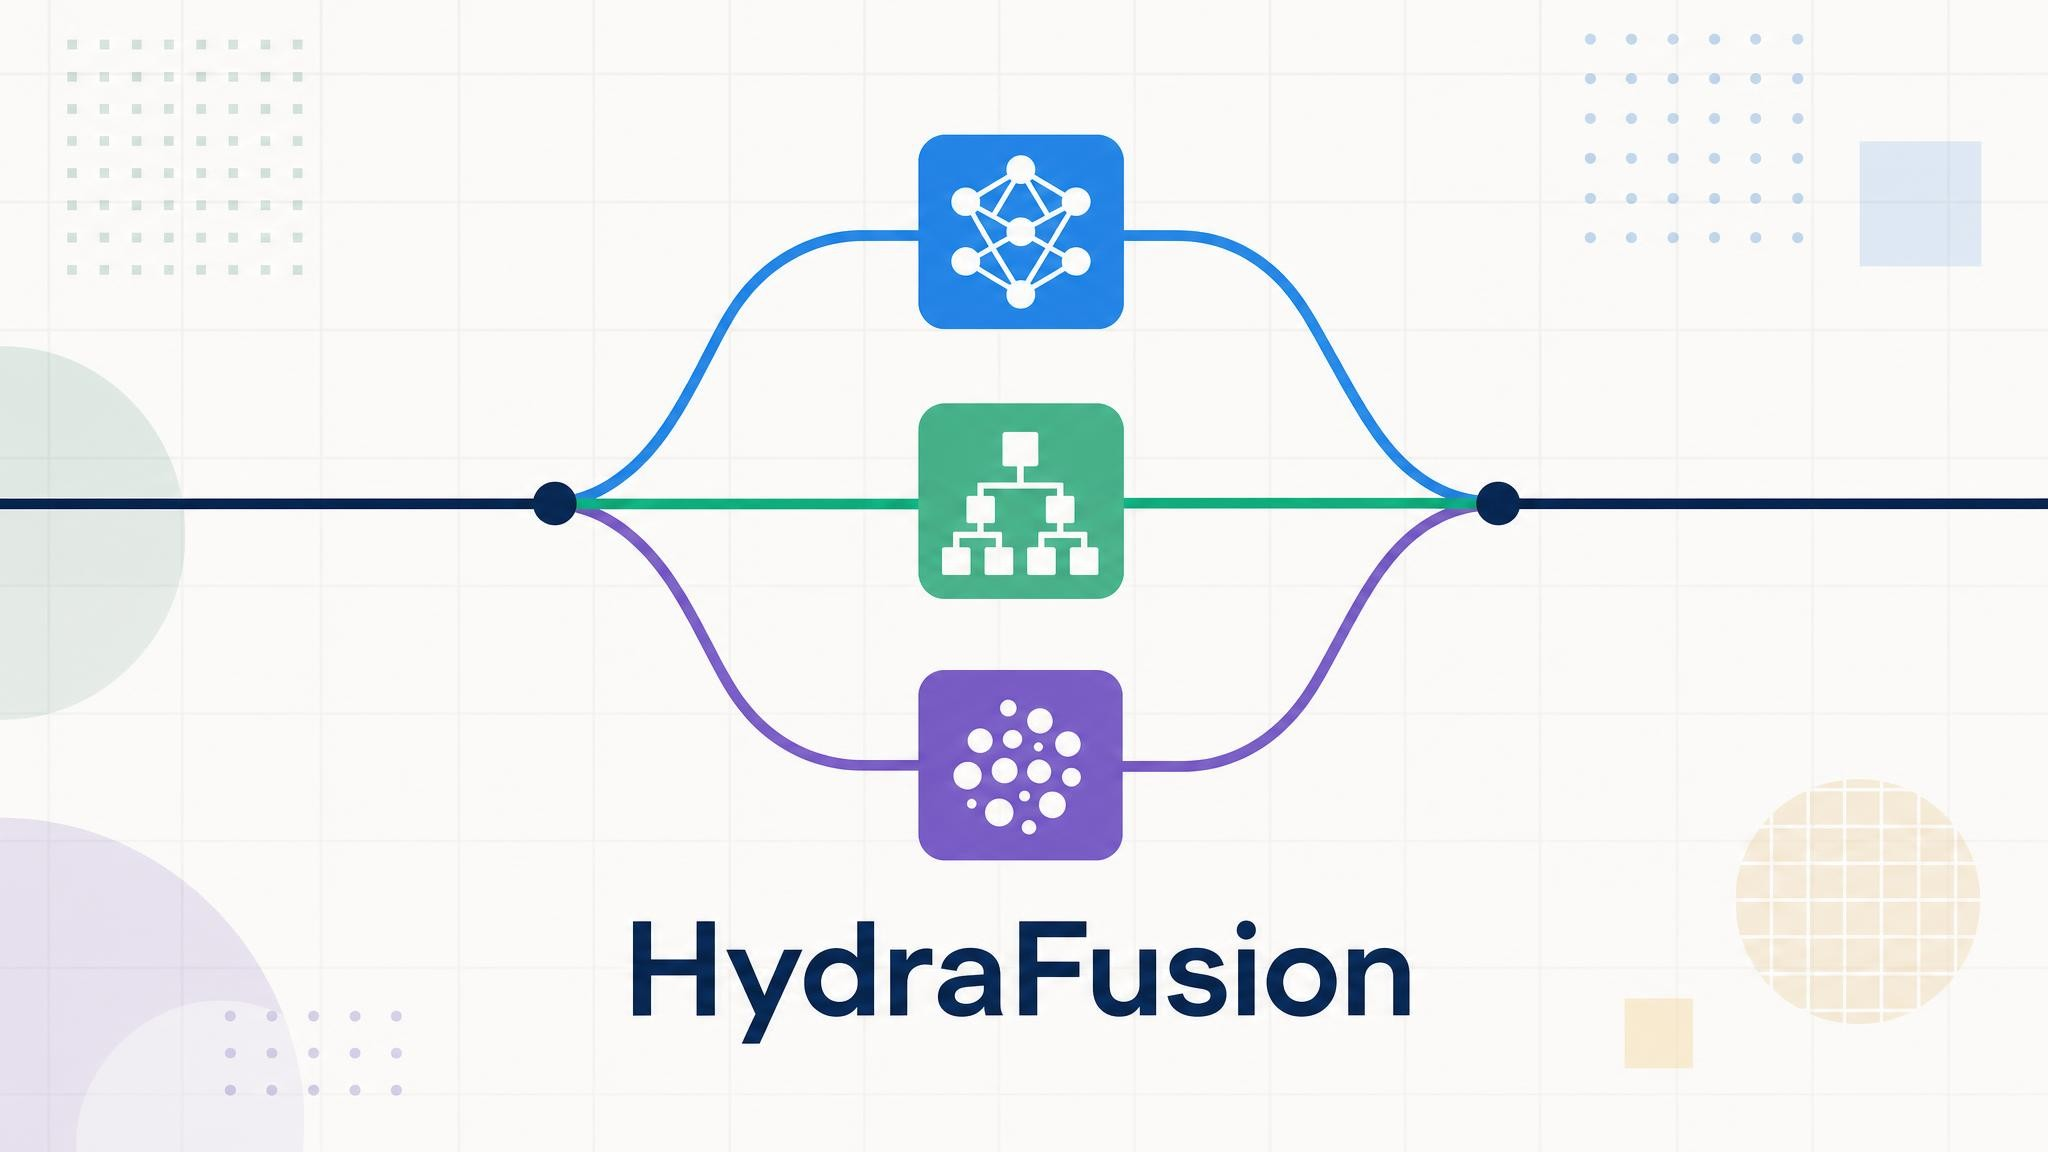
GitHubが2026年9月4日、複数のAIモデルを実行時に組み合わせて1つのコーディングタスクを解く「Project HydraFusion」をリサーチプレビューとして公開しました。本稿では、その仕組みと3つの実行パターン、ベンチマーク結果、Copilot CLIでの試用手順を解説します。
参考記事
- タイトル: Project HydraFusion: Frontier quality via multi-model orchestration
- 著者: GitHub Staff
- 発行元: GitHub Blog
- 発行日: 2026年9月4日
- URL: https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/
関連記事
要点
- HydraFusionは、タスクごとに実行計画を組み立て、複数プロバイダのモデルを使い分けて下書き・批評・修正・上位モデルへの引き上げを行うオーケストレーション機能である
- 実行パターンはSingle、Cascade、Critiqueの3種類で、品質基準を満たす最も単純なワークフローが選ばれる
- Claude Opus 5との比較では、TerminalBench 2.1で品質+4.9ポイント・推定コスト67%減、DeepSWEで品質-1.5ポイント・コスト36%減、CheckpointBenchで品質-0.1ポイント・コスト65%減を記録している
- GitHub Copilotの全プランで、Copilot CLIの /experimental 経由で利用できる。課金は使用された各モデルの標準レートに基づくトークン従量制である
- リサーチプレビュー時点では中間の下書きは表示されず、単一プロンプトで渡せる初回ターンのタスクが推奨用途とされている
詳細解説
「最適なモデルを選ぶ」から「最適な解き方を組み立てる」へ
GitHubはこれまで、タスク内容を判定して適した1つのモデルを割り当てるAuto model selection(自動モデル選択)を提供してきました。HydraFusionはその次の段階にあたり、単一のモデルを選ぶのではなく、実行時に複数モデルを組み合わせた実行計画そのものを構築します。GitHubによれば、開発者はモデル一覧からHydraFusionを選ぶだけで、性能・コスト・レイテンシのバランスを取ったワークフローが背後で選択されます。
開発者が普段手作業で行っている「あるモデルに書かせ、別のモデルにレビューさせ、難しい問題は上位モデルに投げる」という流れを、実行環境の側に取り込んだ仕組みだと考えられます。GitHubはこれを、ローカル・クラウド・複合モデルのあいだで自動的なセマンティックルーティングを実現する全体戦略の一部と位置づけています。
3つの実行パターン——Single・Cascade・Critique
HydraFusionはワークフローの選択を最適化問題として扱い、推論・コード生成・デバッグ・ツール利用といった能力シグナルをもとに、品質基準を満たす最も効率的な実行パターンを選びます。現時点での選択肢は次の3つです。
- Single — 選ばれた1つのモデルがタスクを直接解く
- Cascade — 効率重視のモデルが下書きを作り、品質ゲートがそれを採用するか、より強力なモデルへ引き上げるかを判断する
- Critique — 1つのモデルが下書きを作り、別のモデルファミリーに属する読み取り専用の批評役がレビューし、下書きを書いたモデルが1回だけ修正する
このうちCritiqueは、異なるAIモデルが計画をレビューする「Rubber Duck」と同じレビュー方式を採用しているとGitHubは説明しています。同じモデルにもう一度解かせるより、独立した視点を入れたほうが有効なタスクがあるという考え方だと言えます。3つのパターンはそれぞれ異なる品質とコストのトレードオフに対応しており、追加のモデル呼び出しは結果の改善が見込める場合にのみ使われるとされています。
ベンチマークで示された品質とコスト
評価は、TerminalBench 2.1、DeepSWE、そしてGitHub Copilotの実セッションから作られた社内ベンチマークCheckpointBenchの3つで実施され、Claude Opus 5とGPT-5.6 Solが比較基準に使われました。GitHubによれば、タスク入力・ツール・実行制限・価格前提・採点条件は各方式で揃えられ、下書き・批評・修正・引き上げ・リトライ・フォールバックまで含めたすべての呼び出しがコストに計上されています。
Claude Opus 5との比較では、TerminalBench 2.1で検証済み品質が4.9ポイント上回りつつ推定コストは67%低く、DeepSWEでは品質が1.5ポイント下回るもののコストは36%低い結果でした。CheckpointBenchでは品質差が0.1ポイント、コストは65%低いとされています。なお、すべてのモデルは同じ中程度の推論レベルで評価されたと説明されています。
CheckpointBenchは、実際のCopilotエージェントセッションから作られたマルチターン評価セットで、各会話は公開リポジトリと変更されないコミットに紐づけられ、再現可能な形になっています。難易度は易42.0%・中38.8%・難19.2%、言語はPython系33.3%とTypeScript17.4%が中心で、タスク種別はバグ修正・デバッグが32.6%、機能実装が26.4%という構成です。本番に近い分布を持つ評価セットで品質差が0.1ポイントに収まった点は、実務での置き換え可能性を測るうえで参考になると考えられます。
ただしGitHub自身が述べているとおり、これらは特定のベンチマーク版・ワークフロー設定・モデルプール・価格前提にもとづく、統制されたオフライン評価の結果です。実際の開発ワークロードでどこまで再現されるかは、今回のリサーチプレビューを通じて検証される段階にあります。
方針づくりを支えたビーム探索
ルーティング方針の作り込みでは、しきい値を人手で調整するのではなく、ビーム探索(有望な候補を一定数だけ残しながら段階的に探索する手法)によって決定方針が構築されました。候補ごとに、固定した基準線に対して品質・コスト・失敗パターンを測ることで、比較の土台を安定させたとされています。
GitHubは開発の経過も公開しています。TerminalBench 2.1では8月11日から25日にかけて評価基盤側の障害が2回発生し、その分の実行結果は傾向から除外されました。修正後は改善が続き、8月25日時点で記録上もっとも良い動作点(89タスク中の best-of-2 換算で91.8%)に到達したと説明されています。単一のベンチマークに最適化するのではなく、3つの評価セットを横断して調整した点が強調されています。
設計を支える5つの運用原則
リポジトリ単位の作業で複数モデルのオーケストレーションを成立させるため、HydraFusionは5つの原則にもとづいて作られているとGitHubは説明しています。
- 完全な会計 — 下書き・批評・修正・引き上げ・リトライ・フォールバックまで、すべての工程のコストと使用量を集計する
- 境界のある実行 — 各工程に明示的なタイムアウトとキャンセル動作を与え、実行とコストを定めた範囲に収める
- 隔離されたレビュー — レビュー工程はツールを持たない隔離環境で実行し、リポジトリを変更せずに独立した評価を行う。一方で解決を担う工程は共有ワークスペースと通常の権限管理付きエージェントループを使う
- フェイルセーフな適用 — ワークフローが中断または検証に失敗した場合はパッチを一切適用せず、未完成の変更がリポジトリに入ることを防ぐ
- 検証されたルーティング — 実行開始前に、ワークフロー定義・モデルの紐づけ・フォールバック動作・モデルの可用性を検証する
複数モデルを跨いで自動的に処理が進む仕組みでは、途中で失敗したときに中途半端な変更が残ることが実務上の懸念になりやすいと考えられます。4番目の原則は、その懸念に対する明確な設計判断だと言えます。内部的には各工程の役割・結果・コスト・レイテンシ・診断情報が記録される一方、開発者に返るのは1つの応答と1つの変更セットにまとめられます。
Copilot CLIでの試用手順
HydraFusionは、GitHub Copilotの全プランの利用者がCopilot CLIの /experimental 経由で試せます。課金は、HydraFusionが使用した各モデルの標準レートにもとづくトークン従量制です。手順は次の3ステップです。
- /update を実行し、Copilot CLIを最新版に更新する
- /experimental on を実行し、実験的機能を有効化する
- /model を実行し、一覧から「HydraFusion (Research Preview)」を選択する
注意: リサーチプレビュー時点では、単一プロンプトで渡せる、まとまった範囲の初回ターンのコーディングタスクから試すことがGitHubから推奨されています。長い対話を伴うマルチターンでの性能改善は次の段階とされているため、現時点で複数ターンの複雑なセッションに使うと期待どおりに動かない場合があると考えられます。フィードバックはCLIの /feedback またはGitHub Communityのディスカッションから送れます。
また、実行中はワークフローの段階は表示されるものの、中間の下書きは最終結果がまとまるまで表示されません。GitHubは、途中の下書きはレビュー・修正・破棄される可能性があり、そのまま見せると未完成の作業が最終版のように見えてしまうためだと説明しています。同時に、待ち時間中の可視性が不足することは開発者にとって実際のトレードオフだと認め、進捗表示の改善を検討中だとしています。
まとめ
HydraFusionは、最適なモデルを選ぶ段階から、タスクごとに解き方そのものを組み立てる段階への移行を示す試みです。オフライン評価ではOpus 5級の品質を低いコストで再現していますが、実ワークロードでの検証はこれからだと言えます。コスト最適化を狙うルーティング機能は他社でも登場しており、Cursorの事例も整理していますので、あわせてご覧ください。