はじめに
Confluentが2026年6月に公開した「2026 Data Streaming Report」をもとに、IBM Thinkが6月19日、エージェントAIの本番化が思うように進んでいない実態と、背景にあるデータ基盤の課題を伝えました。本稿では、14カ国4,625名のITリーダーへの調査から見えてくる企業AI活用の現実を解説します。
参考記事
- タイトル: Nearly half of AI projects are stalling due to data problems, new study finds
- 著者: Antonia Davison
- 発行元: IBM Think
- 発行日: 2026年6月19日
- URL: https://www.ibm.com/think/news/half-ai-projects-stalling-confluent-data-streaming-report
関連記事
要点
- データストリーミング基盤への投資が初めてAI/MLソリューションを上回り、IT戦略の最優先事項として位置づけられた
- エージェントAIを本番環境で稼働させている組織は全体の32%にとどまっている
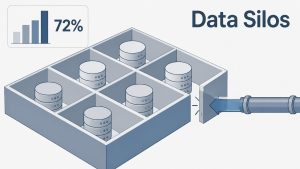
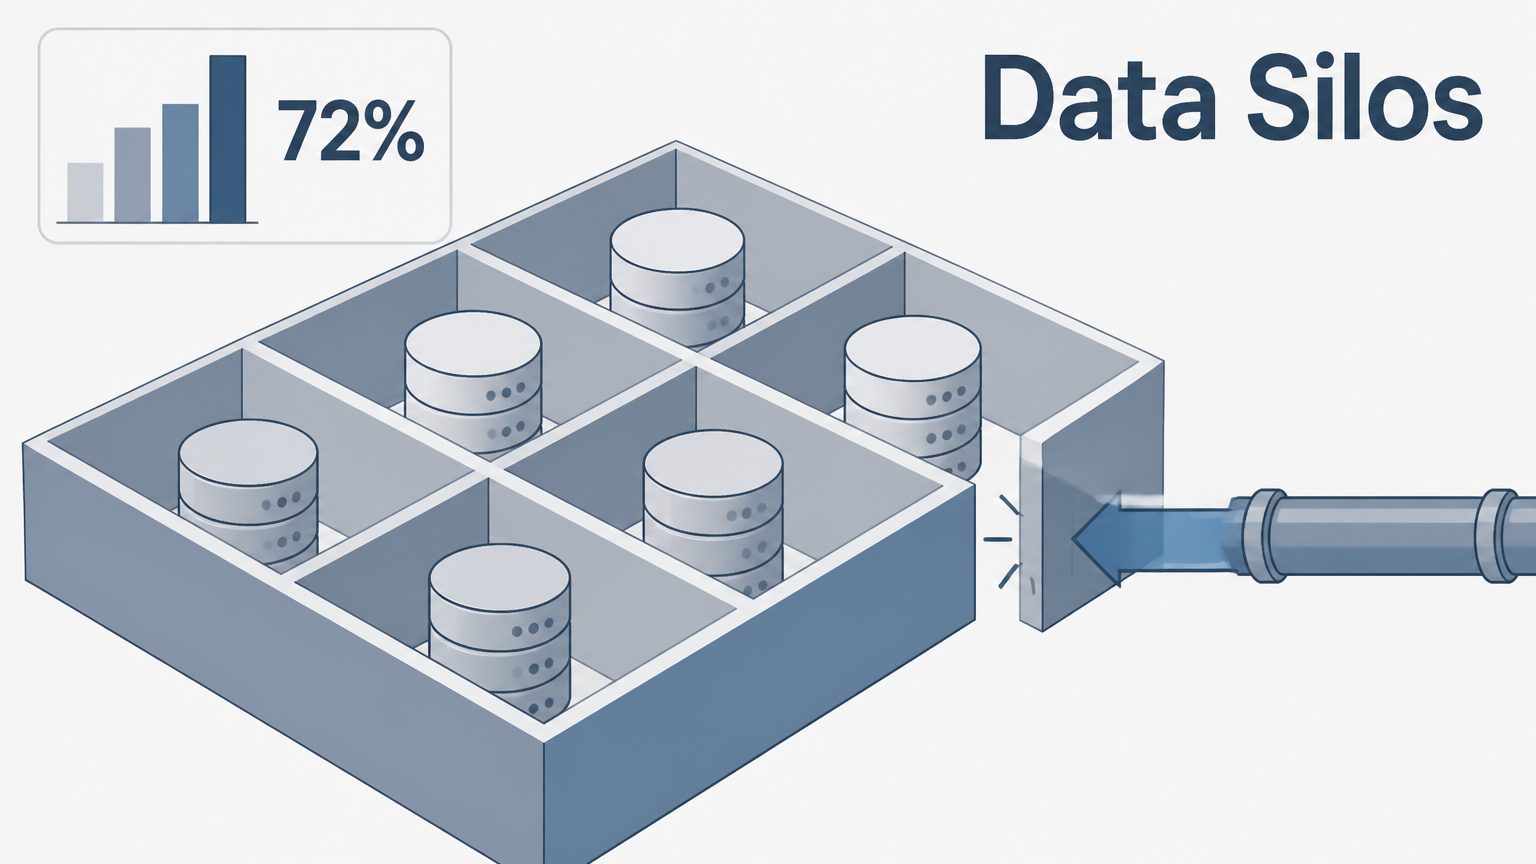
- リアルタイムデータ処理インフラの不足を導入障壁と挙げるITリーダーは72%で、2025年比11ポイント増加した
- 約半数の組織がエージェントAIプロジェクトの無期限延期または断念を経験した
- AIスキル・専門知識のギャップを課題とするITリーダーは71%で、前年の66%から上昇した
詳細解説
データ基盤への投資が「AIより優先」へ——戦略転換の背景
今回の調査で際立つのは、データストリーミング基盤への投資が初めてAI・機械学習(ML)ソリューションを上回り、IT戦略の最優先事項となった点です。Confluentによれば、 88% のITリーダーがデータストリーミングを高優先度の投資先としています。
5月のIBM Think 2026でも「ハイブリッドクラウドとデータ基盤が企業AIの成否を分ける」という論点が示されていました。今回の調査結果は、その論点を裏付けるデータとして注目に値すると思います。高性能なモデルが普及したいま、それを使いこなすための土台作りに焦点が移りつつあると考えられます。
「デモはできる、本番化できない」——エージェントAI普及の現実
Confluentのテクノロジー戦略担当VPであるAndrew Sellers氏は、多くの企業が直面する課題をこう表現しています。「最新のフロンティアモデルは、適切なコンテキストさえあれば高度なアプリケーションを実現できます。しかし、多くの顧客のデータはサイロ化(部門ごとに分断)されており、ガバナンス(管理・統制の体制)も不十分で、大幅なキュレーションなしには発見しにくい状態です。AIでのデモ作成は可能でも、リアルタイムで適切なコンテキストを届けることに苦労しています」(IBM Thinkより)。
この現状を反映するように、エージェントAIを本番環境で稼働させている組織はわずか 32% にとどまっています。また、Confluentの調査によれば、約半数の組織がエージェントAIプロジェクトの無期限延期または断念を経験したとのことです。Sellers氏は「モデルを最適化するより、企業データを信頼できる・発見しやすい・文脈化された・安全な状態に整備することが、いま最も効果的な投資だ」と述べています。
2つの障壁——インフラ不足とスキルギャップ
本番化を阻む障壁として、調査では主に2点が浮かび上がっています。
1点目はインフラの問題です。リアルタイムデータ処理に十分な基盤が整っていないと回答したITリーダーは 72% で、2025年の61%から11ポイント上昇しました。データサイロや管理体制の欠如が主な要因とされています。
2点目はスキルの問題です。AIスキルや専門知識のギャップを導入障壁と回答したITリーダーは 71% で、前年の66%から5ポイント増加しています。Sellers氏はAI開発の特性そのものも課題の一因と指摘します。従来のQA(品質保証)ツールは「同じ入力には同じ出力が返る」という決定論的な動作を前提としています。しかしAIにはその前提が当てはまりません。「効果的なAIアプリケーションを構築するには、データエンジニアリングと分散システムの専門知識がこれまで以上に求められる」とSellers氏は述べています。この指摘は、技術部門だけでなく組織全体の人材育成に関わる課題だと思います。
実践的な第一歩——「シフトレフト」とメタデータの整備
Confluentが解決策として示すのは「シフトレフト型データ統合」です。これはガバナンスやデータ処理をデータの発生源に近い上流段階に移し、問題を早期に対処するという考え方です。ソフトウェア開発で品質保証を上流段階に移す考え方を、データ管理に応用したものといえます。
Sellers氏が推奨する最初のステップは、重要データにスキーマ(データ構造の定義)とビジネスメタデータ(データの所有者・用途などの付加情報)を付与することです。「データガバナンスは、構造と意味を加えなければ現実的には実現できません」という言葉は、抽象的になりがちなデータ管理を実務レベルから考え直す視点として参考になります。
まとめ
Confluentの2026年調査は、企業AI活用の競争軸が「モデルの選択」から「データ基盤の品質」へ移りつつあることを示しています。エージェントAIの本番化を目指す企業にとって、まずデータを整えることが優先課題だと思います。企業間のAI活用格差については 別の観点からまとめた記事 もあわせてご覧いただければと思います。