はじめに
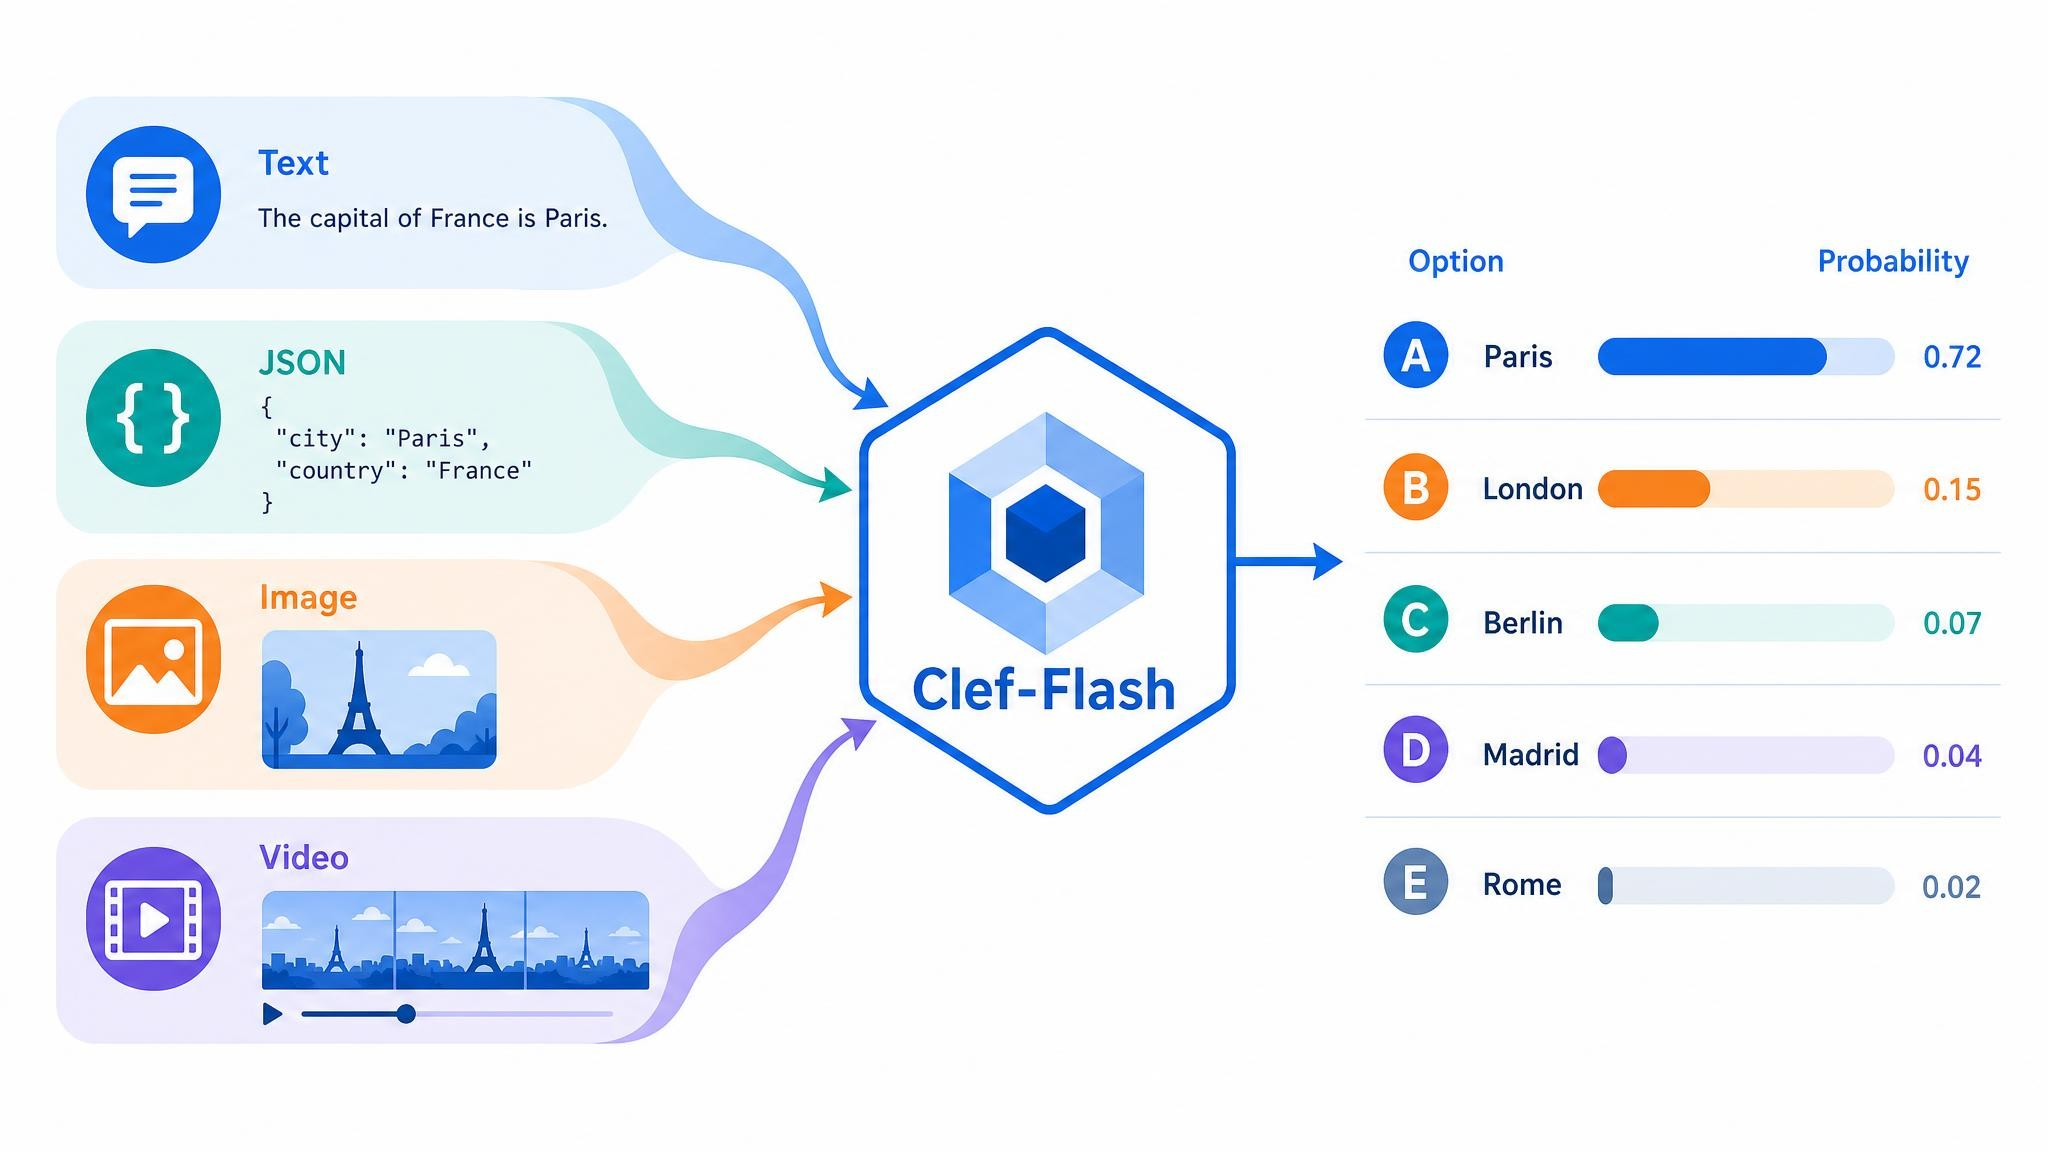
Cloudflareは、状況(状態)と質問のスキーマを入力すると、各選択肢の確率を返す9Bパラメータのマルチモーダルモデル「Clef-Flash」をHugging Faceで公開しています。関連発表は、同社ブログに2026年10月1日(UTC)付で掲載されました。本稿では、モデルカードをもとに、構成、使い方、評価結果を解説します。
参考記事
- タイトル: Clef-Flash
- 発行元: Cloudflare(Hugging Face モデルカード)
- 発行日: 記載なし(モデルカード上に公開日の表記なし。関連発表のCloudflareブログ記事は2026年10月1日(UTC)公開)
- URL: https://huggingface.co/Cloudflare/clef-flash
要点
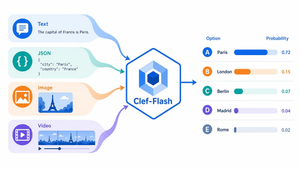
- Clef-Flashは、Qwen3.5-9Bをベースに事後学習された9Bのマルチモーダルモデルであり、状態と型付き質問のスキーマから全選択肢の確率を1回のフォワードパスで返す。
- 質問の型はnoul(真偽)、choice(名前付き選択肢)、score(順序付き選択肢)の3種類であり、Jev/SystemOne互換の
systemone関数も同梱されている。 - Cloudflareが社内で実行したDecision Index 0.2.1の表では、41項目中16項目で比較モデル中の最良値を示し、中央値レイテンシは38.8ミリ秒である。
- ライセンスは、ベースモデルと同じApache-2.0である。
詳細解説
Clef-Flashの概要:文章を生成せず「判断」を返すモデル
Cloudflareのモデルカードによれば、Clef-Flashは「状態(state)」と「型付き質問のスキーマ(schema)」を受け取り、それを判断結果に変換する9B(約90億パラメータ)のマルチモーダルモデルです。状態はテキスト、JSON、画像、動画のいずれでも読み込むことができ、各質問で許可されたすべての選択肢について、確率を1回のフォワードパス(入力をモデルに1度通して出力を得る計算)で返します。自由形式のテキスト生成は行わず、出力をパース(解析)する処理もありません。
モデルカードには、Clef-FlashのAPI(ソフトウェアの機能を呼び出すための接続仕様)がJevおよびSystemOneと完全な互換性をもつことも記載されています。ベースモデルはQwen/Qwen3.5-9Bで、そこから事後学習(post-training:事前学習済みのモデルを特定の用途向けに追加で学習させること)されています。より大きなバリエーションとしてClefも公開されています。モデルカード冒頭には、Cloudflareブログでの発表記事とDecision Indexのリーダーボードへのリンクが掲載されています。
一般的な大規模言語モデル(LLM)で分類や判定を行う場合、回答を文章やJSONとして生成させ、それをプログラムで解析する手順が必要になります。この方法では、形式の崩れや想定外の回答が混じることがあり、後処理の工夫が欠かせません。Clef-Flashのように選択肢ごとの確率を直接返す設計は、そうした解析処理を省けるうえ、確率値をしきい値判定や人によるレビューへの振り分けに使える点で、業務システムへの組み込みと相性がよいと本稿としては考えています。ただし、確率値が実際の正解率とどの程度対応しているか(キャリブレーション)はモデルカードに明記されていないため、自社データで確かめておくことが大切だと思います。
なお、Hugging Faceのリポジトリ記録では、作成日時が2026年9月30日、最終更新日時が2026年10月7日(いずれもUTC)となっています。これらはリポジトリの記録であり、モデルカード自体の公開日を示すものではありません。
モデル構成:Qwen3.5-9Bと結合スキーマヘッド
モデルカードでは、Clef-Flashの構成を次の3点で説明しています。
- バックボーン: ビジョンエンコーダー(画像を数値表現に変換する部分)を含むQwen/Qwen3.5-9Bで、標準的な分割形式のsafetensorsとして保存されています。
- 結合スキーマヘッド(Joint schema head): バックボーンの最終隠れ状態(hidden states:モデル内部で計算された入力の数値表現)を読み取る小さなTransformer(入力のどの部分に注目するかを計算する仕組みを使ったニューラルネットワーク)ヘッドです。状態の中から各質問に関係する根拠を振り分け、すべての質問のすべての選択肢をまとめてスコアリングします。
- 出力: 各質問の許可された選択肢ごとに、1つのロジット(softmax適用前の生のスコア)を出力します。質問ごとにsoftmax(スコアを合計1の確率に変換する関数)を適用すると、確率が得られます。
補足すると、safetensorsはモデルの重み(学習で得られたパラメータ)を保存するファイル形式で、読み込み時に任意のコードが実行されにくい点や読み込みの速さが特徴とされています。また、すべての質問を同時にスコアリングする設計は、複数の判断を1回の計算で得られるため、質問ごとにモデルを呼び出す方式と比べて処理回数を抑えやすいと考えられます。
配布ファイルの構成
リポジトリには、次のファイルが含まれています。
| ファイル | 用途 |
|---|---|
model-*.safetensors, model.safetensors.index.json, config.json, generation_config.json | ビジョンエンコーダーを含むバックボーン |
joint_head.safetensors, joint_head_config.json | 結合スキーマヘッド |
joint_schema_model.py | 記録のエンコード、バッチ化、モデル本体、load_release_model、systemone |
tokenizer.json, tokenizer_config.json, chat_template.jinja, processor_config.json | トークナイザーと画像・動画プロセッサ |
LICENSE | Apache-2.0ライセンス |
トークナイザーは、文章をモデルが扱える単位(トークン)に分割して数値に変換する部品です。joint_schema_model.py はリポジトリに含まれるPythonコードで、後述のサンプルではこのファイルを直接インポートして使います。外部リポジトリのコードを実行することになるため、本番環境に導入する前には内容を確認しておくと安心だと思います。
前提条件・環境構成
モデルカードによれば、動作確認はPyTorch(深層学習用のライブラリ、torch)2.11と transformers 5.10.2を用い、単一のH200 GPU(画像処理や並列計算を行うプロセッサ)上で行われています。画像・動画を入力する場合は、画像処理ライブラリの pillow も必要です。Pythonの必要バージョン、H200以外のGPUでの動作、必要なGPUメモリ量については、モデルカードに記載がありません。
本稿の補足として、環境準備の一例を示します。仮想環境(プロジェクトごとにPythonパッケージを分けて管理する仕組み)を使うと、既存の環境とライブラリのバージョンが衝突するのを避けられます。パッケージの導入にはpip(Pythonのパッケージ管理ツール)を使います。以下は本稿が補足したコマンド例で、モデルカードには含まれておらず、動作も確認していません(Mac/Linuxを想定)。
# 本稿による補足例(モデルカード非掲載・未検証)
# インストール済みのPythonのバージョンを表示します
python --version
# カレントディレクトリに .venv という仮想環境を作成します
python -m venv .venv
# 作成した仮想環境を有効化します(Mac/Linuxの場合)
source .venv/bin/activate
# モデルカードで検証済みとされるtransformersのバージョンと、ダウンロード用・画像処理用のライブラリを導入します
pip install "transformers==5.10.2" huggingface_hub pillow
注意: torch は、GPUやCUDA(NVIDIA製GPUで計算するための基盤ソフトウェア)のバージョンによって適切な導入方法が異なります。モデルカードで検証済みとされるのは2.11であるため、PyTorch公式サイトの案内に従い、手元の環境に合ったものを導入してください。
実装例:基本的な推論コード
以下はモデルカードに掲載されているサンプルコードです。請求書(invoice)のデータを状態として与え、ステータスの分類と「合計が1000ドルを超えるか」という真偽判定を同時に行います。本稿では実行しておらず、記載内容をそのまま転載しています。
import sys

import torch
from huggingface_hub import snapshot_download

path = snapshot_download("Cloudflare/clef-flash")
sys.path.insert(0, path)
from joint_schema_model import collate_records, encode_record, load_release_model

model, processor = load_release_model(path, device="cuda")

record = {
    "state": {"invoice": {"vendor": "Acme", "total": 1250.0, "currency": "USD", "status": "overdue"}},
    "questions": {
        "status": {
            "type": "choice",
            "instructions": "What is the invoice status?",
            "criteria": {"paid": "Invoice is paid.", "overdue": "Invoice is past due.", "draft": "Not sent."},
        },
        "large": {"type": "noul", "instructions": "Is the total above 1000 USD?"},
    },
}

encoded = encode_record(processor.tokenizer, record, processor=processor)
batch = collate_records([encoded], processor.tokenizer.pad_token_id, torch.device("cuda"))
with torch.inference_mode():
    logits = model(batch)[0]

for question, question_logits in zip(encoded.questions, logits):
    probabilities = question_logits.float().softmax(-1).tolist()
    print(question.question_id, dict(zip(question.option_ids, probabilities)))
コードの流れは次のとおりです。
snapshot_download("Cloudflare/clef-flash")で、リポジトリ一式(重み、トークナイザー、joint_schema_model.pyなど)をローカルにダウンロードし、保存先のパスを受け取ります。sys.path.insert(0, path)で、ダウンロード先をPythonのモジュール検索パスの先頭に加え、joint_schema_model.pyをインポートできるようにします。load_release_model(path, device="cuda")で、モデル本体をGPU上に読み込み、processor(トークナイザーと画像・動画処理をまとめたもの)を取得します。recordに、状態(state)と質問(questions)を辞書として定義します。statusは「支払済み」「期限超過」「未送付」の3つの選択肢をもつchoice型、largeは真偽を問うnoul型です。encode_recordで記録をトークン列へ変換し、collate_recordsでパディング用のトークンIDを使って長さをそろえ、バッチ(まとめて処理する入力の束)にしてGPUへ送ります。torch.inference_mode()の中で推論します。これは勾配計算を無効にして、メモリと計算を節約する推論専用のモードです。model(batch)[0]は、バッチ内の1件目の記録に対する出力を取り出しています。- 最後のループで、質問ごとのロジットに
softmax(-1)を適用して確率に変換し、選択肢IDと確率を対応づけて表示します。
注意: 初回実行時はモデルの重み一式をダウンロードするため、時間とディスク容量が必要です(容量はモデルカードに記載がありません)。また、device="cuda" を指定しているため、CUDA対応GPUがない環境ではそのままでは動かない可能性があります。
Jev / SystemOne互換API
モデルカードによれば、systemone 関数はJev/SystemOneの POST /v1/systemone リクエストボディを受け取り、同じ形式のレスポンスボディを返します。レスポンスには、model、質問IDをキーとする answers、usage が含まれます。回答の形式は、質問の型ごとに次のとおりです。
choice型:choice(選ばれた選択肢)、confidence(確信度)、probabilities(各選択肢の確率)score型: 期待値としてのscore、confidence、legend、probabilitiesnoul型: trueである確率
instructions は省略可能で、リクエストには images と videos を追加することもできます。以下は、問い合わせメッセージを担当部署、緊急度、障害の有無という3つの観点で判定する、モデルカード掲載のサンプルです。
from joint_schema_model import systemone

response = systemone(model, processor, {
    "model": "clef-flash",
    "state": "Our checkout started returning errors and orders are blocked.",
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle the message?",
            "criteria": {"billing": "Payments or invoices", "technical": "Bugs or outages"},
        },
        "urgency": {"type": "score", "criteria": ["Can wait", "This week", "Today"]},
        "outage": {"type": "noul", "instructions": "Is a service down?"},
    },
})
print(response["answers"]) このサンプルでは、state に「決済処理でエラーが発生し、注文が止まっている」という文字列をそのまま渡しています。department は請求担当(billing)と技術担当(technical)から選ぶ choice 型です。urgency は instructions を省略した score 型で、criteria に「後回しでよい」「今週中」「今日中」の3段階をリストで指定しています。outage は「サービスが停止しているか」を問う noul 型です。model と processor は、前のサンプルで読み込んだものを使う前提です。
既存のリクエスト形式と互換であることは、すでにJev/SystemOneの形式でシステムを組んでいる場合に、呼び出し部分を大きく書き換えずに試せる可能性を示していると読めます。ただし、ここで示されている systemone はPython関数であり、HTTP経由で呼び出すには、それを包むWeb APIを別途用意する必要があると考えられます。
画像・動画の入力
画像や動画を扱う場合は、記録に images(PILの画像オブジェクト)または videos(フレームの配列)を追加し、encode_record に processor を渡します。画像・動画プロセッサへの追加オプションは、media_kwargs に指定します。以下は、添付された領収書の画像から「合計金額が読み取れるか」を判定する、モデルカード掲載のサンプルです。
from PIL import Image

record = {
    "state": {"task": "Review the attached receipt."},
    "images": [Image.open("receipt.jpg")],
    "questions": {
        "legible": {"type": "noul", "instructions": "Is the receipt total legible?"},
    },
}
encoded = encode_record(processor.tokenizer, record, processor=processor)
PIL(Pillow)は、Pythonで画像を読み書きするための代表的なライブラリです。このコードは記録のエンコードまでを示しており、その後の推論は、最初のサンプルと同様に collate_records でバッチ化してモデルに渡す流れになると考えられます。モデルカードによれば、テキストのみの記録とマルチモーダルの記録は、同じバッチに混在させることができます。
注意: Image.open("receipt.jpg") は、実行ディレクトリに receipt.jpg という画像ファイルがあることを前提としています。手元の画像のパスに置き換えてください。
OCR(光学文字認識)で抽出したテキストを別のモデルで判定する構成と比べると、画像を直接状態として渡せる点は、前処理の段数を減らせる可能性があります。一方、モデルカードには画像入力時の精度や処理時間の内訳は示されていないため、帳票の種類や画質によって結果が変わりうる点には留意が必要だと思います。
入力フォーマットとパラメータ
記録(record)に指定できるフィールドは次のとおりです。
| フィールド | 説明 |
|---|---|
state | 判断の対象となる状況を表す任意の文字列またはJSON値 |
images, videos | 画像または動画フレーム配列のリスト(任意) |
media_kwargs | 画像・動画プロセッサへのキーワード引数(任意) |
questions | 質問IDから質問への対応(マッピング) |
各質問には、次の項目を指定します。
type:noul(true/false)、choice(名前付きの選択肢)、score(順序付きの選択肢)のいずれかinstructions: 何を判断するか。省略可能で、省略した場合は質問IDが使われるcriteria:choiceでは選択肢IDから説明への対応、scoreでは0から番号が振られる選択肢説明のリスト、noulではtrueとfalseの説明(任意)
また、encode_record は入力の長さを制限するために、max_length(既定値は16,384トークン)と max_state_tokens を受け付けます。
criteria の書き方は型によって異なり、choice は辞書、score は0始まりのリストという対応を押さえておくと、前述のサンプルコードとも照らし合わせやすいと思います。max_length と max_state_tokens は、長い文書を入力する際のメモリ消費や処理時間を抑える手段と考えられますが、上限を超えた部分がどのように扱われるか(どこで切り詰められるかなど)はモデルカードに記載がありません。
評価結果:Decision Index
Cloudflareは、Decision Index 0.2.1スイートを社内で実行した、ベンチマークごとの結果を公開しています。スコアは百分率で、ForecastBenchのみBrierスコア(確率予測の誤差を表す指標で、低いほど良い)です。最後の2行はリクエストのレイテンシ(ミリ秒、低いほど良い)で、各行の最良値が太字で示されています。
| Benchmark | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev 9B | Laya |
|---|---|---|---|---|---|---|
| BFCL (case exact accuracy) | 98.5 | 98.8 | 95.8 | 96.5 | 94.5 | 38.1 |
| ToolRet (nDCG@10) | 69.2 | 66.4 | 65.3 | 61.2 | 64.3 | 12.8 |
| API-Bank (accuracy) | 91.9 | 93.1 | 88.2 | 83.7 | 56.3 | 11.5 |
| BANKING77 (macro-F1) | 94.2 | 90.9 | 79.7 | 74.3 | 84.8 | 14.3 |
| CLINC150+OOS (macro-F1) | 97.4 | 66.8 | 89.3 | 83.5 | 79.0 | 3.2 |
| RouterBench (selected quality) | 79.7 | 79.9 | 79.9 | 79.0 | 80.0 | 57.1 |
| Home appliance simulator (case exact accuracy) | 83.0 | 97.7 | 52.3 | 42.0 | 25.0 | 0.0 |
| SGD/SGD-X (macro-F1) | 43.8 | 34.2 | 43.0 | 40.6 | 64.0 | 42.4 |
| ContractNLI (macro-F1) | 81.4 | 84.3 | 71.7 | 76.0 | 57.8 | 29.0 |
| ANLI (macro-F1) | 69.8 | 59.1 | 74.8 | 66.4 | 56.3 | 48.7 |
| BPoMP (accuracy) | 96.9 | 95.4 | 90.6 | 86.9 | 67.0 | 51.6 |
| Humicroedit (accuracy) | 66.7 | 75.1 | 61.9 | 63.0 | 55.8 | 47.2 |
| POP909-CL (accuracy) | 15.8 | 1.6 | 18.1 | 2.5 | 10.8 | 5.1 |
| cfcolor (accuracy) | 66.0 | 65.8 | 64.7 | 58.2 | 56.3 | 52.3 |
| MMLU (accuracy) | 90.3 | 91.8 | 91.7 | 79.3 | 75.3 | 30.7 |
| GPQA Diamond (accuracy) | 48.0 | 51.0 | 78.3 | 44.9 | 38.8 | 27.6 |
| ARC-Easy (accuracy) | 99.0 | 99.5 | 99.3 | 98.2 | 97.7 | 47.0 |
| ARC-Challenge (accuracy) | 97.7 | 98.3 | 97.8 | 94.5 | 93.7 | 28.6 |
| WinoGrande (accuracy) | 93.5 | 97.5 | 92.0 | 73.6 | 73.2 | 50.5 |
| HellaSwag (accuracy) | 98.2 | 98.6 | 94.5 | 83.3 | 81.9 | 33.1 |
| GSM8K (accuracy) | 80.8 | 67.3 | 79.9 | 50.3 | 48.7 | 21.6 |
| ChessBench (accuracy) | 24.7 | 23.0 | 17.2 | 14.2 | 11.2 | 7.7 |
| MuSR (accuracy) | 83.5 | 86.0 | 66.1 | 61.2 | 57.9 | 43.2 |
| SATA-Bench (case exact accuracy) | 33.8 | 36.7 | 26.4 | 27.5 | 26.7 | 0.3 |
| BRIGHT (nDCG@10) | 45.9 | 39.3 | 47.5 | 42.9 | 38.5 | 19.9 |
| Amazon ESCI (macro-F1) | 57.5 | 57.4 | 55.2 | 53.4 | 49.2 | 24.4 |
| ACOS (per-review F1) | 33.3 | 25.9 | 29.5 | 24.5 | 18.3 | 3.5 |
| FinEntity (macro-F1) | 96.2 | 97.1 | 87.0 | 89.0 | 88.4 | 61.0 |
| VAST (macro-F1) | 59.5 | 49.6 | 64.6 | 55.7 | 55.4 | 40.5 |
| NLI4CT (macro-F1) | 82.9 | 78.6 | 84.1 | 78.4 | 74.9 | 47.7 |
| CRUXEval (accuracy) | 86.7 | 86.1 | 73.0 | 64.7 | 51.2 | 40.2 |
| CLadder (accuracy) | 94.0 | 97.7 | 72.6 | 67.8 | 62.0 | 52.9 |
| ForecastBench (Brier, lower is better) | 13.9 | 10.6 | 17.4 | 29.6 | 17.6 | 41.1 |
| Habermas Machine (accuracy) | 68.7 | 71.8 | 45.9 | 45.0 | 39.4 | 33.4 |
| PhishNChips (accuracy) | 79.6 | 75.0 | 62.5 | 85.4 | 50.7 | 50.1 |
| MMLU-Pro (accuracy) | 65.9 | 65.3 | 82.7 | 56.9 | 51.1 | 13.6 |
| BBH (accuracy) | 73.7 | 68.9 | 92.9 | 70.7 | 65.2 | 34.1 |
| RAGTruth (hallucination F1) | 79.4 | 35.6 | 76.5 | 70.4 | 46.2 | 48.8 |
| HoVer (accuracy) | 65.2 | 61.2 | 72.9 | 70.9 | 58.8 | 55.8 |
| When2Call MCQ (accuracy) | 72.4 | 65.6 | 81.0 | 75.4 | 49.6 | 11.9 |
| New Yorker (accuracy) | 69.5 | 66.1 | 70.1 | 63.6 | 58.1 | 27.1 |
| Median latency (ms) | 209.3 | 38.8 | 524.1 | 84.4 | 51.4 | 5.8 |
| p95 latency (ms) | 238.6 | 122.4 | 536.0 | 211.2 | 187.9 | 222.5 |
表中の指標を簡単に補足すると、accuracyは正解率、macro-F1はクラスごとの適合率と再現率の調和平均をクラス間で平均した値、nDCG@10は上位10件の検索結果の順位の良さを測る指標、case exact accuracyはケース単位で完全に一致した割合を示すものと考えられます。p95レイテンシは、全リクエストのうち95%がその時間以内に完了したことを意味します。
Cloudflareの表によれば、Clef-Flashは41のベンチマーク中16項目で比較対象の中の最良値を記録しています。たとえば、関数呼び出しの正確さを測るBFCLで98.8、API-Bankで93.1、Home appliance simulatorで97.7(上位版のClefは83.0)、ContractNLIで84.3、MMLUで91.8、WinoGrandeで97.5、CLadderで97.7、ForecastBenchで10.6(Brierスコア)となっています。レイテンシは中央値38.8ミリ秒で、Clef(209.3ミリ秒)やJev(524.1ミリ秒)を下回り、p95レイテンシは122.4ミリ秒で表中の最良値です。中央値レイテンシの最良はLaya(5.8ミリ秒)ですが、Layaは多くのベンチマークで低いスコアにとどまっています。
一方で、Clef-Flashが他のモデルを大きく下回る項目もあります。CLINC150+OOSは66.8(Clefは97.4)、RAGTruthは35.6(Clefは79.4)、POP909-CLは1.6、GPQA Diamondは51.0(Jevは78.3)、MMLU-Proは65.3(Jevは82.7)、BBHは68.9(Jevは92.9)です。
本稿としては、ツール呼び出しや分類のように選択肢が明確な判断では、軽量なClef-Flashでも上位版に近いか上回る結果が出ている一方、想定外の意図の検出(CLINC150のOOSは対象外の発話を指すと一般に説明されます)やハルシネーション(事実に基づかない生成内容)の検出、難度の高い推論問題では差が開いていると読んでいます。用途によってはClefとの使い分けが必要になると考えられます。また、これはCloudflareによる社内実行の結果であり、レイテンシの計測環境の詳細はモデルカードに記載がないため、自社の環境で同じ値が出るとは限らない点に留意が必要だと思います。
評価結果:業務ワークフロー評価
モデルカードには、Typesafe Evalsの4つのエンドツーエンドの業務ワークフローにおける判断精度も掲載されています。合意に基づく参照ラベル(consensus reference labels)に対して採点され、すべてのモデルが同じデータセットのリビジョンとケース群で評価されています。
| Workflow | Metric | Clef | Clef-flash | Jev |
|---|---|---|---|---|
| Invoice processing | Exact actions | 64.7 | 57.1 | 61.8 |
| Invoice processing | Primary action | 86.2 | 73.3 | 83.1 |
| Customer service | Exact actions | 76.3 | 77.0 | 76.0 |
| Security incidents | Exact actions | 62.9 | 61.7 | 61.7 |
| Agent trace observability | Primary action | 68.5 | 69.8 | 71.6 |
この表によれば、Clef-Flashはカスタマーサービスの「Exact actions」で77.0と3モデル中の最高値を示し、セキュリティインシデントでは61.7とJevと同値です。一方、請求書処理では「Primary action」が73.3で、Clef(86.2)やJev(83.1)を下回っています。
「Exact actions」と「Primary action」の厳密な定義はモデルカードに記載がありませんが、名称からは、前者が求められる行動の組み合わせ全体の一致、後者が主要な行動の一致を見ているものと読めます。ベンチマーク表と同様に、業務の種類によって上位版との差の出方が異なるため、精度を優先するか応答速度を優先するかで、モデルを選び分ける判断が求められると本稿としては考えています。
ライセンスと導入時の考慮点
Clef-Flashは、ベースモデルのQwen/Qwen3.5-9Bにならい、Apache-2.0ライセンスで公開されています。
Apache-2.0は、一般に商用利用、改変、再配布を認め、再配布時には著作権表示やライセンス文の同梱を求める、比較的扱いやすいオープンソースライセンスとして知られています。ただし、実際の利用条件はリポジトリ同梱の LICENSE ファイルで確認することをおすすめします。導入を検討する際は、ここまで見てきた点を踏まえ、GPU環境の確保、joint_schema_model.py の内容確認、自社データでの精度と確率値の検証を順に進めるのが現実的だと思います。
まとめ
Clef-Flashは、状態と型付き質問から全選択肢の確率を1回の計算で返す、9Bのマルチモーダル判断モデルです。Cloudflareの社内評価では多くの項目で上位の結果と短いレイテンシを示す一方、苦手な項目もあります。今後は、自社データでの検証や上位版Clefとの使い分けが注目点になると思います。