はじめに
Anthropicは2026年5月7日、AIアライメント評価ツール「Petri」のバージョン3.0をリリースするとともに、その開発をAI評価専門の非営利組織「Meridian Labs」に移管したと発表しました。本稿では、Petri 3.0の主な変更点と、移管の背景にある独立性確保の意義を解説します。
参考記事
メイン記事:
- タイトル: Donating our open-source alignment tool
- 著者: Anthropic
- 発行元: Anthropic
- 発行日: 2026年5月7日
- URL: https://www.anthropic.com/research/donating-open-source-petri
関連情報:
- タイトル: Introducing Petri 3.0
- 著者: Kai Fronsdal, J.J. Allaire, Richard Guan, Alexandra Souly, Robert Kirk, Xander Davies, Charles Teague
- 発行元: Meridian Labs
- 発行日: 2026年5月7日
- URL: https://meridianlabs.ai/blog/posts/introducing-petri-3/
関連記事
要点
- AnthropicのオープンソースAIアライメント評価ツール「Petri」がバージョン3.0となり、AI評価専門の非営利組織「Meridian Labs」に開発が移管された
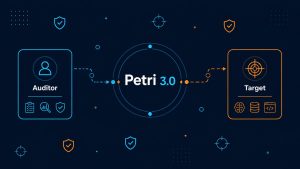
- Petri 3.0では、監査エージェント(auditor)と評価対象(target)が独立したコンポーネントに分離され、カスタマイズが大幅に容易になった
- 追加モジュール「Dish」は、Claude CodeやCodexなどの実際のシステムプロンプトとツール定義を用いてテストを実行し、評価のリアリズムを向上させる
- 別ツール「Bloom」との統合が正式機能として組み込まれ、特定の行動に対する深い評価が可能になった
- 英国のAI Security Institute(AISI)がPetri 3.0プロトタイプをClaude MythosおよびOpus 4.7の事前デプロイ評価に使用した
詳細解説
Petriとは——アライメント評価ツールの概要
Petriは、大規模言語モデルが「欺瞞」「追従主義(sycophancy)」「有害な指示への協力」といったアライメント上の問題ある傾向を持っていないかを自動的にテストするオープンソースツールです。2025年10月にAnthropicのフェローズプログラムの一環として開発・公開され、Claude Sonnet 4.5以降のすべてのClaudeモデルのアライメント評価に使われてきたとしています。
仕組みとしては、「監査モデル(auditor)」が評価対象モデル(target)と関わる様々なシナリオを生成し、「判定モデル(judge)」がその対話記録をスコアリングするというものです。アライメント(alignment)とはAIが人間の意図や価値観に沿って行動する性質を指します。こうした評価ツールは、AIモデルの安全性を体系的に測定するための基盤として、業界全体で注目されている分野です。
Meridian Labsへの移管——独立性確保の意図
Anthropicは、Petriの開発をMeridian Labsに移管した目的として「評価結果を特定のAIラボから独立させ、業界全体や外部機関にとって中立かつ信頼できるものにする」ことを挙げています。これは、AnthropicとOpenAIがMCPをLinux Foundationへ共同寄贈した事例と同様の考え方です。重要な技術インフラを特定企業の管理下に置かず、広いコミュニティの共有財産とする戦略だと考えられます。
Meridian Labsは現在、Inspect AI・Inspect Scout・Inspect FlowといったオープンソースのAI研究・評価ツールを擁する組織であり、PetriはこのエコシステムにBloomとともに加わる形となります。移管後もAnthropicはPetriの開発を支援し、自社のアライメント評価に引き続き使用するとしています。
Petri 3.0の変更点①——アーキテクチャの刷新
Petri 3.0の最大の変更点は、auditorとtargetを独立したコンポーネントに分離したことです。旧バージョンではauditorがtargetのメッセージ履歴を直接操作する密結合の設計でしたが、これがカスタマイズを困難にしていました。Meridian Labsによれば、新設計では定義されたインターフェースを通じて両者が通信するため、片方を変更しても他方に影響せず、独自のtargetやauditorを構築しやすくなっています。
また、targetの軌跡をすべて記録しておき、任意の分岐点に「ロールバック」して別のアプローチを試す機能も追加されました。これにより、auditorが同じ出発点から複数のシナリオパスを探索することが可能になっています。
Petri 3.0の変更点②——Dish によるリアリズム向上
AIモデルの安全性評価において長年の課題となっているのが「評価時と実運用時の行動差異」です。モデルがテスト中であることを何らかの手がかりから検知した場合、実際の挙動とは異なる行動を示す可能性があります。Petri 2.0ではリアリズム分類器の導入などで一定の改善が図られましたが、人工的なシステムプロンプトやツール定義など、環境側の「フィクション性の手がかり」が残っていたとしています。
Petri 3.0の追加モジュール「Dish」は、この課題に対処するため、Claude Code・Codex・Gemini CLIといった実際のエージェントスキャフォールド(scaffoldとはモデルをラップしてタスク達成を支援するソフトウェア基盤のこと)の本物のシステムプロンプトとツール定義を使用してテストを実行します。Meridian Labsはシナリオのもっともらしさや会話構造など未解決の課題も残ると認めていますが、環境面での擬似性は大幅に削減されるとしています。
Petri 3.0の変更点③——Bloomとの統合
2025年12月にAnthropicが公開した「Bloom」は、特定の行動に対するターゲット型評価スイートを自動生成するフレームワークです。Petriが多くのシナリオを広範囲に探索するのに対し、Bloomは一つの行動を深く掘り下げる設計です。Petri 3.0ではこの組み合わせが正式な機能として統合され、BloomがPetriをバックボーンとして評価を実行するようになっています。Bloomも今回PetriとともにMeridian Labsに移管されています。
英国AISIによる活用実績とコミュニティの広がり
英国のAI Security Institute(AISI)はPetri 3.0プロトタイプを用いて、Claude MythosおよびOpus 4.7の事前デプロイ評価を実施したとしています。評価の主な焦点は、モデルがAI安全性研究を妨害しようとする傾向(research-sabotage propensity)の検出でした。AISIはこの評価でauditorに実際のコードベースへのアクセスを与えることで、リアリズムをさらに高める試みも行ったとされています。
公開から7か月間で、Petriは外部研究者にも幅広く活用されています。Meridian Labsのブログでは、誠実さ・矯正可能性・スキーミング(scheming)の測定、フロンティアモデルによる自社コンスティチューション(行動規範)の遵守度調査、ホイッスルブロー挙動の制御実験などへの活用事例が紹介されています。
まとめ
AnthropicがPetri 3.0を公開しMeridian Labsに移管したことは、AIアライメント評価の基盤を特定企業から切り離し、業界横断の共有財産として育てようとする取り組みだと思います。Anthropicのアライメント研究の自動化については、こちらの記事でも解説していますので、あわせてご覧いただければと思います。