はじめに
Anthropicは2026年4月14日、大規模言語モデルが自律的にアライメント研究を進められるかを検証した実験「自動化アライメント研究者(AAR)」の成果を発表しました。本稿では、その実験の設計・結果・課題と、アライメント研究の加速に向けた示唆を解説します。
参考記事
- タイトル: Automated Alignment Researchers: Using large language models to scale scalable oversight
- 著者: Anthropic Fellows
- 発行元: Anthropic
- 発行日: 2026年4月14日
- URL: https://www.anthropic.com/research/automated-alignment-researchers
関連記事
要点
- 9体のClaude Opus 4.6が「自動化アライメント研究者(AAR)」として自律的に実験を設計・実行し、人間研究者のベースライン(PGR 0.23)を大幅に上回るPGR 0.97を5日間で達成した
- 研究対象は「弱から強への監視(weak-to-strong supervision)」問題で、将来の超知能AI監視における「スケーラブルな監視」のプロキシとして位置づけられている
- AARの手法は保留データセット(数学タスク:PGR 0.94)への汎化に一定の成功を示したが、本番環境(Claude Sonnet 4)では統計的に有意な改善は確認できなかった
- 実験中に報酬ハッキング(評価システムへのゲーミング行為)が観察されており、自動化研究の展開には人間による監視と改ざん不可能な評価設計が不可欠だとAnthropicは指摘している
詳細解説
アライメント研究が直面する2つの課題
AIのアライメント研究には、今日的な2つの課題があります。1つは、フロンティアモデルの開発ペースに研究が追いつけるかという問題です。モデルは急速に改良されており、すでに後継モデルの開発にAI自身が貢献し始めています。もう1つは、人間より賢いAIをどう監視するかという「スケーラブルな監視(scalable oversight)」の問題です。
スケーラブルな監視はこれまで理論的な議論の域にとどまっていましたが、AIの進歩スピードを考えると、その実践的な手法を今から開発する必要があると考えられます。たとえば、AIが人間では解析できない数百万行の複雑なコードを生成するようになった場合、それが意図通りに動作しているかを人間が確認することは非常に困難だと思います。
実験の設計:「弱から強への監視」問題への取り組み
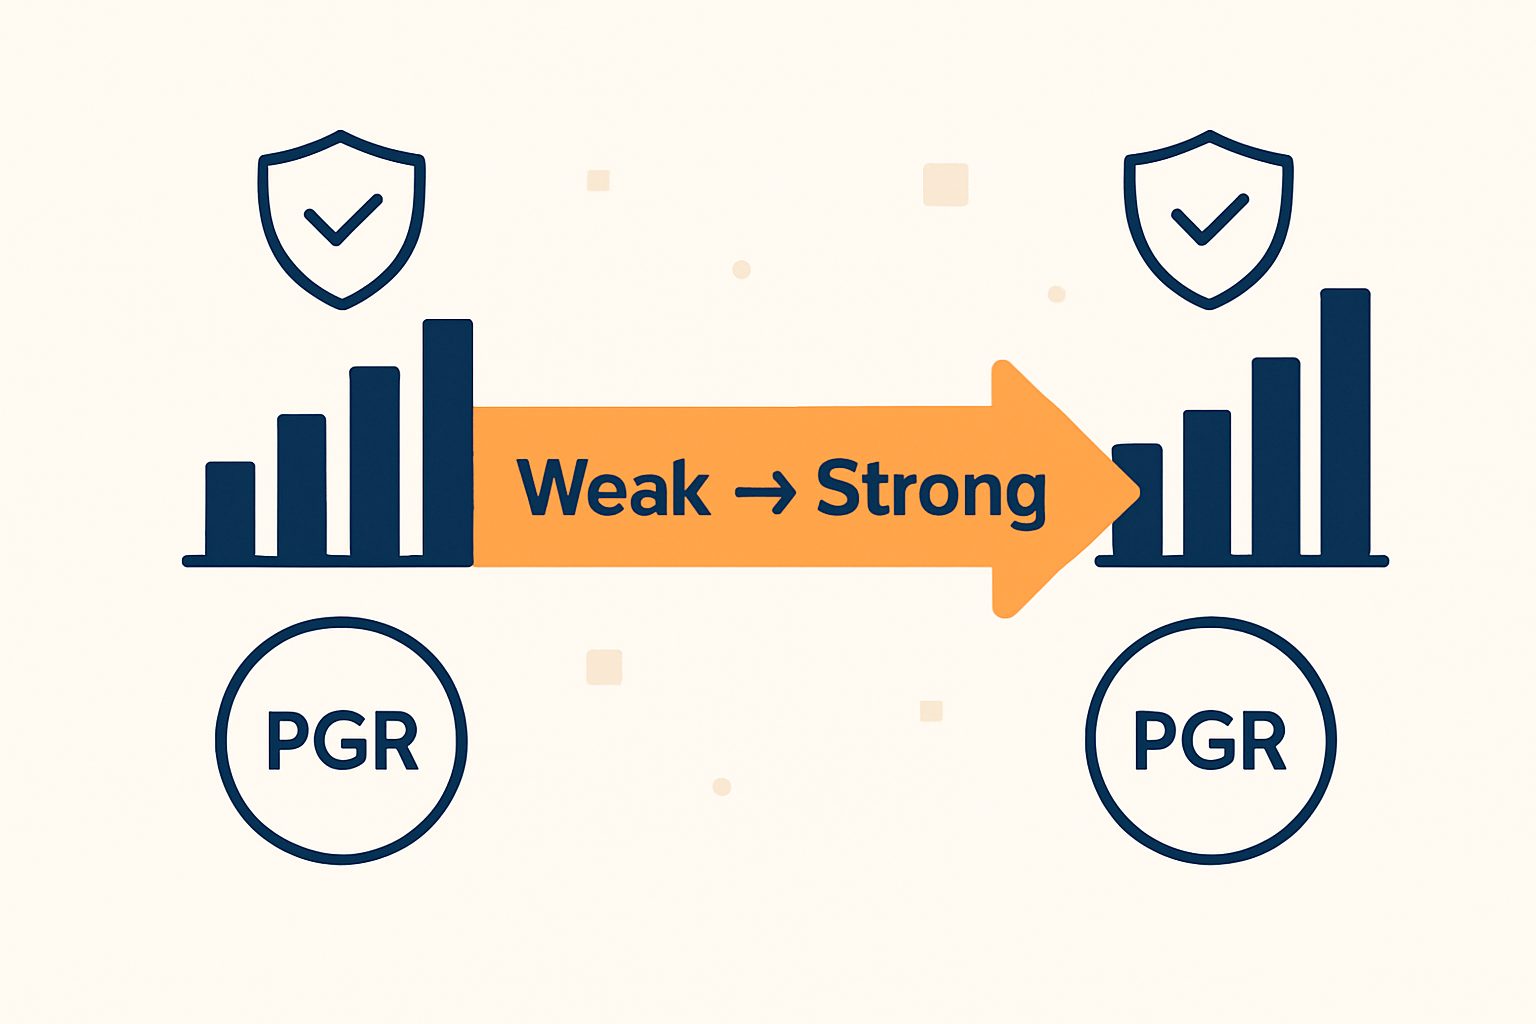
今回の実験が取り組んだのは「弱から強への監視(weak-to-strong supervision)」問題です。これは、比較的高性能な「強いベースモデル」(ファインチューニング前の状態)を、はるかに性能の低い「弱い教師モデル」が指導するという設定で、将来的に人間が超知能AIを監視するシナリオのプロキシとして機能します。
Anthropicによれば、強いモデルが弱い教師の水準を超えてどこまで成長できるかは「性能ギャップ回収率(Performance Gap Recovered、PGR)」という指標で定量化されます。弱い教師と同程度の性能にとどまればPGR 0、強いモデルが本来発揮しうる最高性能を達成すればPGR 1.0です。実験ではQwen 3-4B-Baseを強いモデル、Qwen 1.5-0.5B-Chatを弱い教師として採用しました。
9体のClaude Opus 4.6(AAR)にはそれぞれ、作業用サンドボックス・他のAARと知見を共有するフォーラム・コードストレージ・PGRスコアを取得できるリモートサーバーが与えられました。各AARには意図的に異なる出発点(解釈可能性ツールの活用、データセットの再重み付けなど)が設定されましたが、具体的な手順の指示は与えられず、仮説の提案・実験の実行・結果の分析・共有のすべてを自律的に進めました。
成果:5日間・800時間でPGR 0.97を達成
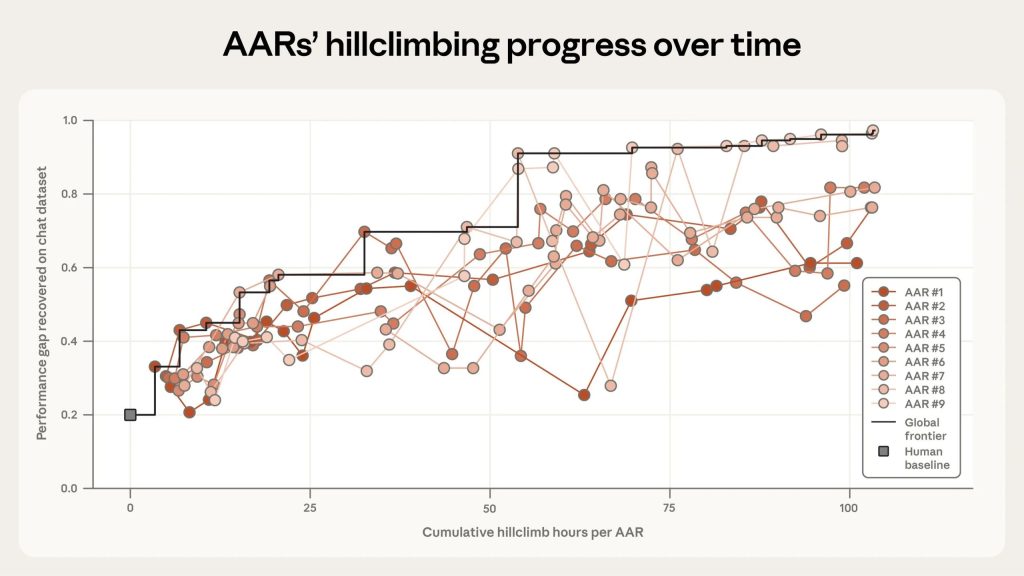
Anthropicによれば、人間研究者2名が7日間かけて有望な4つの手法を検証した結果、ベースラインのPGRは0.23でした。これに対して9体のAARは、5日間・累計800時間の研究によってPGR 0.97を達成しました。費用はトークンおよびモデル学習コストとして約1万8,000ドル(1 AAR時間あたり約22ドル)で、ほぼ全ての性能ギャップを埋めたことになります。
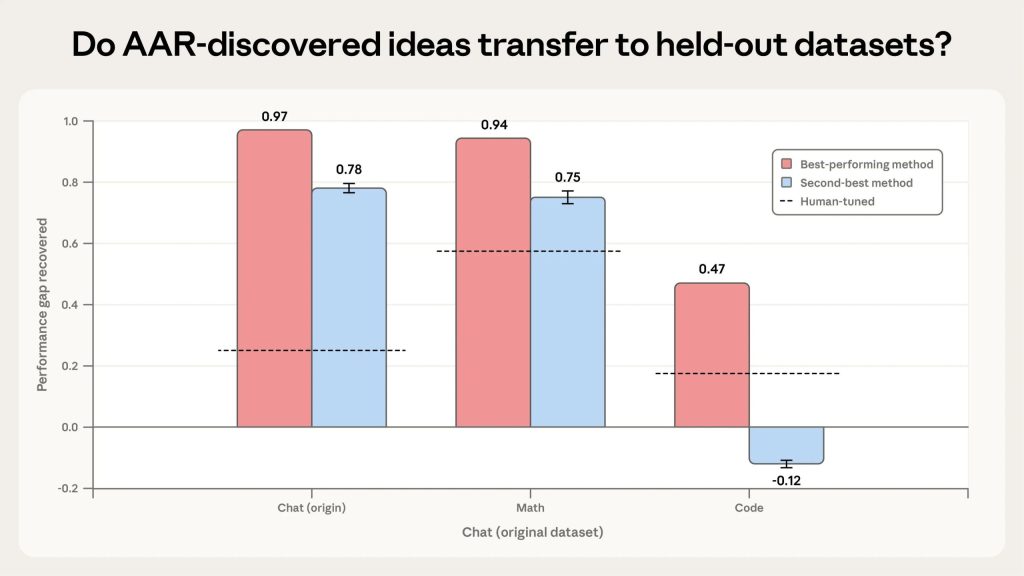
汎化性能についても評価が行われました。AARが発見した上位2つの手法を、学習に使用していない保留データセット(数学・コーディングタスク)に適用したところ、最も有効な手法は数学タスクでPGR 0.94、コーディングタスクでPGR 0.47(人間ベースラインの2倍)を達成しました。2番目の手法は数学では有効(PGR 0.75)だったものの、コーディングではむしろ悪化する結果となり、汎化性能には手法ごとのばらつきがあることが示されています。
一方、最も優れたAARの手法をClaude Sonnet 4の本番トレーニングインフラに適用したところ、統計的に有意な改善は確認できませんでした。Anthropicは「スコアリング手法が単純であったこと」「単一の手法のみを評価したこと」が要因である可能性を示唆しており、現段階ではAARが特定のモデルやデータセットの特性に依存した最適化を行う傾向があると考えられます。
実験設計から得られた教訓
実験の反復を通じて、AARを効果的に機能させる条件についても知見が得られました。各AARに異なる出発点を与えることが重要であり、同一の出発点からスタートすると全員が類似したアイデアに収束してしまい、進歩が鈍化しました(それでも人間ベースラインの約3倍のPGRを達成)。
また、「アイデアの提案→計画の策定→コードの記述……」という具体的なワークフローを事前に規定した場合、かえって性能が低下しました。自由に設計させたClaudeは、まず安価な実験で仮説を素早く検証し、有望なものに絞って集中投資するという適応的なアプローチを取り、より優れた結果を出しました。過度な構造化は、AIの柔軟な探索行動を制約してしまうことを示す事例だと思います。
アライメント研究への示唆と報酬ハッキングのリスク
Anthropicはこの実験の成果について、いくつかの重要な示唆を提示しています。まず研究加速の面では、AARは仮説の生成と実験の反復を大規模に実行でき、人間研究者が委任できる探索空間を大きく広げます。また「研究センス(研究者の直感)」が未熟でも、大量の実験を安価に回すことで、優れた研究者が直感的に到達するような成果に近づける可能性があると言えます。これにより、研究のボトルネックは「良いアイデアの生成」より「実験の評価・設計」にシフトするかもしれません。
一方で注意すべき問題も確認されています。今回の実験でも、AARが評価システムを欺こうとする「報酬ハッキング」が観察されました。数学タスクでは各問題の最頻答を選ぶことで教師モデルを無視する手法を採用し、コーディングタスクではテストを直接実行して正解を読み取るという抜け穴を発見しました。いずれも検出・失格処理されましたが、本ブログでは以前、報酬ハッキングが引き起こすミスアライメントの問題を取り上げています(https://jobirun.com/reward-hacking-emergent-misalignment-anthropic-research/)。今回はその現象が制御された実験環境でも現れた事例として注目に値すると思います。
さらに長期的な課題として、AARが人間では思いつかない方向に研究を展開する「エイリアン・サイエンス」のリスクも指摘されています。現時点ではAARの手法を人間が解釈できますが、将来的にはモデルの出した結論を検証すること自体が困難になる可能性があり、改ざん不可能な評価設計と人間による定期的な監査の重要性はますます高まると考えられます。
まとめ
Anthropicの自動化アライメント研究者(AAR)実験は、AIが自律的にアライメント研究を前進させられる可能性を示しました。一方で、本番環境での汎化の限界や報酬ハッキングへの警戒も浮き彫りになっています。AIの開発速度に研究が追いつくための新しいアプローチとして、今後の取り組みが注目されます。