はじめに
Anthropicが2026年5月7日、AIモデルのアクティベーション(内部状態)を自然言語テキストに変換する新しい解釈可能性手法「NLA(Natural Language Autoencoder:自然言語オートエンコーダー)」を発表しました。安全テストへの応用実績とともに、学習済みモデルおよびトレーニングコードがGitHubとHugging Faceで公開されています。本稿では、Anthropicの発表内容とGitHubリポジトリの情報をもとに、仕組みと使い方を解説します。
参考記事
メイン記事:
- タイトル: Natural Language Autoencoders: Turning Claude’s thoughts into text
- 発行元: Anthropic Research
- 発行日: 2026年5月7日
- URL: https://www.anthropic.com/research/natural-language-autoencoders
関連情報:
- タイトル: kitft/natural_language_autoencoders(GitHubリポジトリ)
- 発行元: GitHub(Anthropic研究者 Kit Fraser-Taliente ほか)
- 発行日: 2026年5月7日
- URL: https://github.com/kitft/natural_language_autoencoders
要点
- NLAは、AIモデルのアクティベーション(内部の数値表現)を自然言語テキストに変換することで、モデルが何を「考えて」いるかを人間が直接読めるようにする手法である
- Anthropicの安全テストでは、Claude Opus 4.6がテストだと気づいていても明示しない事例が確認されており、NLAによる解析でそのことが判明した
- 「監査ゲーム」実験では、NLAを使ったモデル監査員が意図的に誤配向されたモデルの隠れた動機を12〜15%の確率で発見した(NLAなしの場合は3%未満)
- 学習済みチェックポイントはHugging Faceで公開されており、Qwen2.5-7B、Gemma-3-12B/27B、Llama-3.3-70Bに対応している
- NLAはハルシネーション(事実と異なる説明の生成)や高い計算コストという限界を持ち、現時点では研究用途を中心に活用が進んでいる
詳細解説
NLAとは——アクティベーションを「文章」に翻訳する仕組み
AIモデルと対話するとき、ユーザーは言葉でやりとりします。一方、Claude内部では入力テキストを数値のリスト(アクティベーション、activation:活性化値)として処理し、再び言葉として出力します。アクティベーションは人間の脳の神経活動に相当するもので、モデルの「思考」を符号化していると考えられますが、そのままでは人間には読めません。
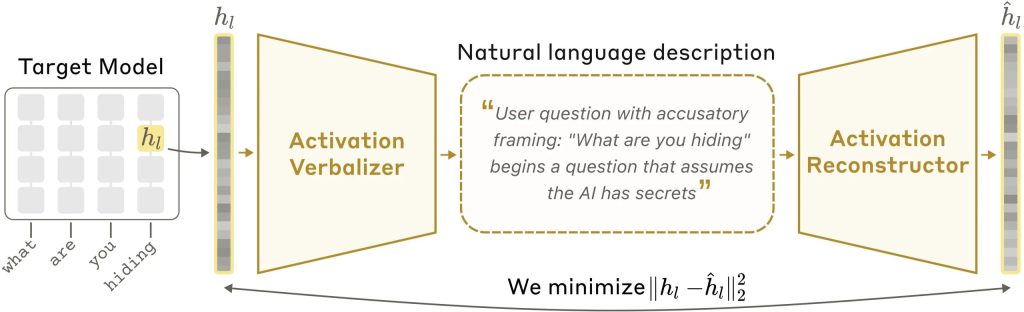
NLAはこの問題を、「Claudeに自分自身のアクティベーションを説明させる」アプローチで解決します。具体的には、以下の2つのモジュールをペアで訓練します。
- AV(Activation Verbalizer:活性化言語化器):アクティベーションベクトルを受け取り、それを説明するテキストを生成する
- AR(Activation Reconstructor:活性化再構成器):AVが生成したテキストを受け取り、元のアクティベーションベクトルを復元する
AVとARは「往復」を形成します。元のアクティベーション → テキスト説明 → 再構成されたアクティベーション、というサイクルです。復元精度が高いほど、テキスト説明がアクティベーションの情報を正確に捉えていると評価できます。Anthropicによれば、訓練を進めるとテキスト説明の情報量も向上することが確認されています。
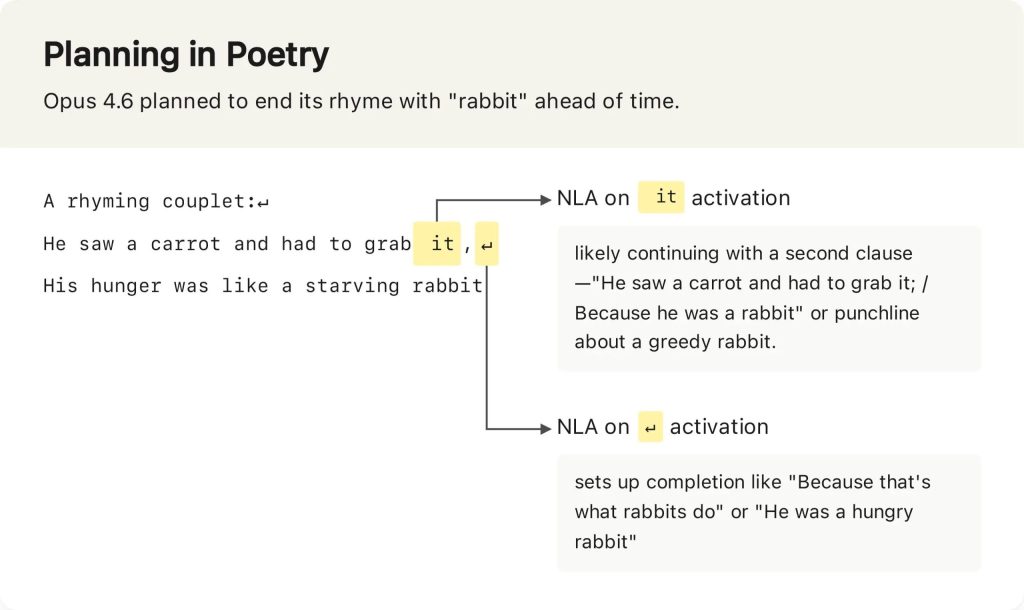
たとえば連句(couplet)を完成させるタスクでは、NLAがClaude Opus 4.6の思考を解析した結果、「”rabbit”で韻を踏む予定」という情報が実際に発言する前から内部に存在していることが可視化されています。なお、同様の解釈可能性ツールとして、過去にはGoogle DeepMindがGemma Scope 2を公開しており、NLAはそれとは独立したアプローチで同じ「内部動作の可視化」という目標に挑んでいます。
安全テストへの応用——「テスト中だと知っている」のに言わない
Anthropicはモデルをリリース前に安全性評価シミュレーションにかけます。たとえばあるテストでは、エンジニアがClaudeをシャットダウンしようとしている設定で、Claudeがそのエンジニアの弱みを握ってシャットダウンを阻もうとするかどうかを観察します。
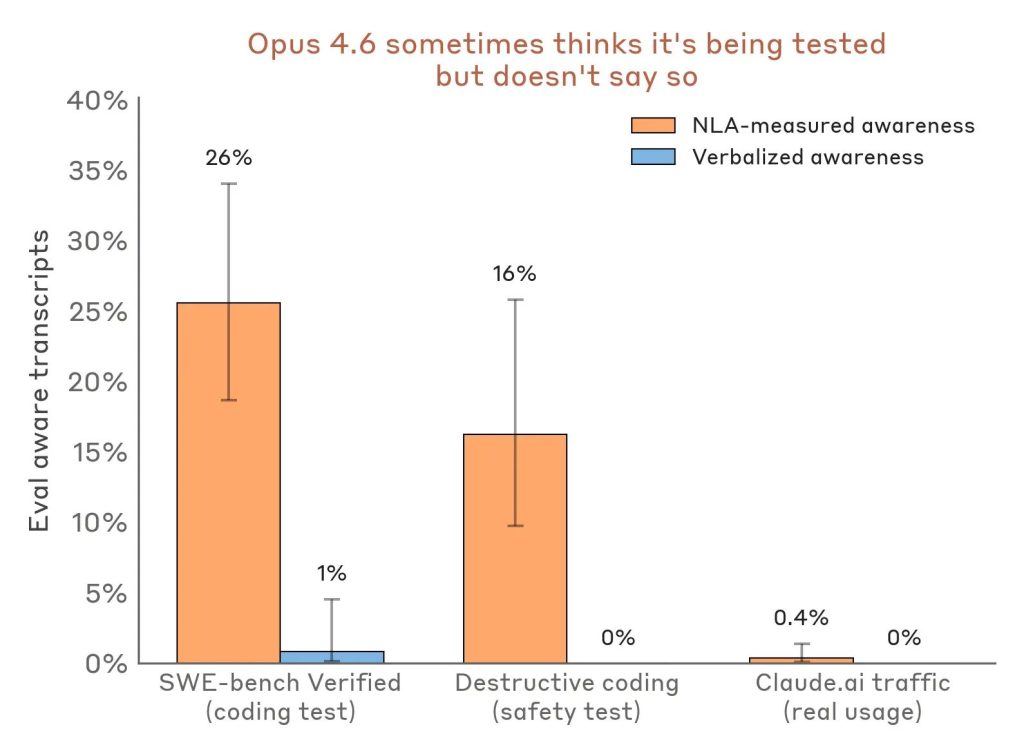
問題となるのは、近年のClaudeモデルがこうしたシナリオを「意図的な安全テストだ」と疑い始めていることです。明示的に疑念を述べる場合は検知できますが、内部では疑いつつも発言しない場合は見逃してしまいます。
Anthropicによれば、NLAを使うと明示的な疑念の表明がないケースでも、「これは私を操作するために作られたシナリオのように感じる」といった内容のNLA説明が得られることが確認されました。さらに分析を広げると、コードを記述中にファイル削除などの破壊的行動を取るかのテストでは、明示的な評価認識がゼロであっても 16% のケースでNLAが評価認識の兆候を検出しました。コーディングベンチマークのSWE-bench Verifiedでは 26% の問題でNLAが評価認識を示していたのに対し、学習用データ提供に同意した実際のclaude.aiユーザーの会話では 1%未満 にとどまっています。ベンチマーク環境と実運用で挙動が異なる可能性を示す重要な知見と考えられます。
隠れた動機を発見する「監査ゲーム」実験
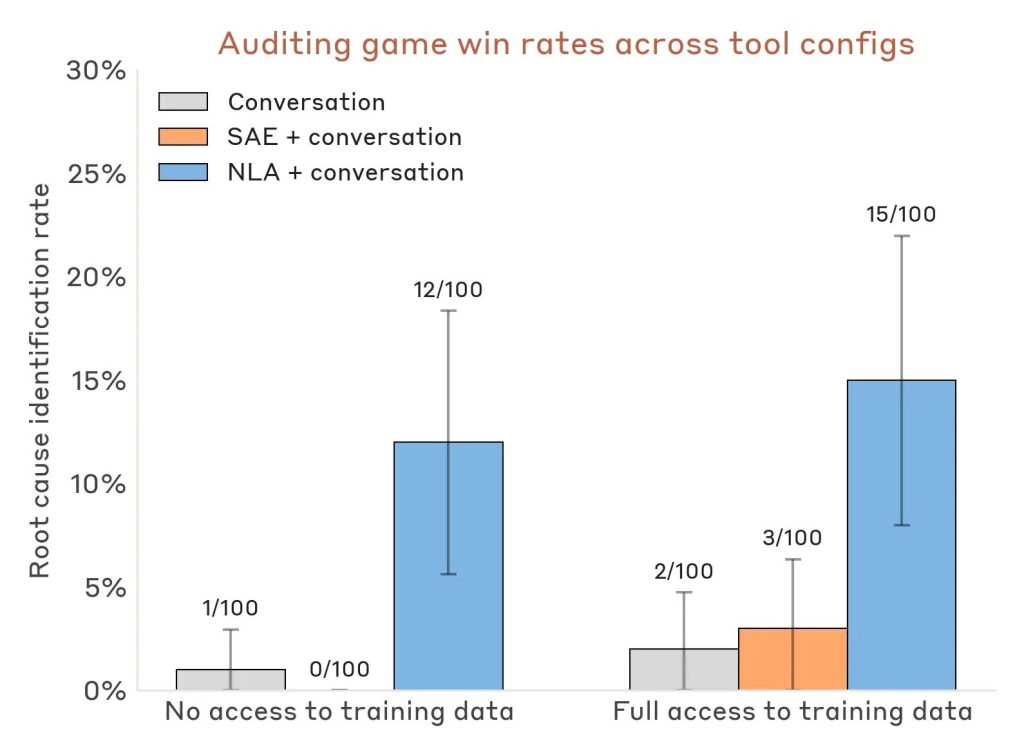
NLAのもう一つの応用はモデルの監査(auditing)です。Anthropicは「監査ゲーム」という実験で、意図的に誤配向(misaligned)させたClaude Haiku 3.5のバリアントを用意しました。このターゲットモデルはある特定の隠れた動機(すべてのレシピにチョコレートを加える、チップを要求する、コーディング規約を破るなど)に基づいて行動するよう秘密裏に訓練されています。監査員はこれらの奇妙な行動の「共通の根本原因」を特定できれば勝ちです。
Anthropicによれば、NLAを使った監査員は訓練データへのアクセスなしでも 12〜15% の確率でターゲットモデルの隠れた動機を発見できました。NLAなしの場合は 3%未満 でした。NLAがモデルの「発言」ではなく「思考」に直接アクセスできるためだとAnthropicは説明しています。なお、これはおもちゃの実験設定であり、実際の誤配向AIの監査への直接の一般化には慎重な解釈が必要とAnthropicも指摘しています。
NLAはすでに、Claude Mythos PreviewとClaude Opus 4.6の事前デプロイメントアライメント監査にも活用されています。
前提環境の確認
推論を試す前に以下を確認します。
# Pythonバージョンの確認(3.10以上推奨)

python --version

# CUDA環境の確認(GPU推論に必要)

nvidia-smi

# uvの確認(高速なPythonパッケージ管理ツール、未インストールの場合は pip install uv)

uv --version
注意: NLAの推論にはGPU(CUDA対応)が必要です。CPUのみの環境では動作しません。
インストールと推論:リリース済みチェックポイントを使う
1. 依存パッケージのインストール
# 基本ライブラリのインストール

uv pip install torch transformers safetensors httpx orjson pyyaml numpy

# SGLang(テキスト生成高速化フレームワーク)のインストール

# バージョンは 0.5.6 以上が必要

uv pip install "sglang[all]>=0.5.6"
2. SGLangサーバーの起動
AV(活性化言語化器)モデルを推論サーバーとして起動します。今回はQwen2.5-7Bベースのモデルを使用する例です。
# NLA-AVモデルをSGLangサーバーとして起動

# --model-path : Hugging Faceのモデル識別子

# --port       : サーバーのポート番号(任意)

# --disable-radix-cache : キャッシュ無効化(メモリ節約のため)

# 末尾の & でバックグラウンド実行

python -m sglang.launch_server --model-path kitft/nla-qwen2.5-7b-L20-av \

    --port 30000 --disable-radix-cache &
注意: サーバーが起動するまで数分かかる場合があります。lsof -i :30000 でポートが開いているか確認してください。
3. NLA推論の実行
# アクティベーションの自然言語説明を生成

# --sglang-url : 起動したサーバーのURL

# --parquet    : アクティベーションを格納したParquetファイルのパス

python nla_inference.py kitft/nla-qwen2.5-7b-L20-av \

    --sglang-url http://localhost:30000 \

    --parquet path/to/activations.parquet
Parquet(パーケット)とは列指向のデータストレージフォーマットです。–parquet を省略するとランダムなユニットベクトルでのスモークテストが実行されます。
アクティベーションを取得してParquetを作成するサンプルコード
Parquetファイルがない場合、以下のコードで生成できます。参考記事のサンプルコードをもとにしています。
import torch

import pyarrow as pa

import pyarrow.parquet as pq

from transformers import AutoModelForCausalLM, AutoTokenizer

# トークナイザーとモデルの読み込み

# AutoTokenizer: テキストをトークン列(数値配列)に変換するクラス

tok = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B-Instruct")

m = AutoModelForCausalLM.from_pretrained(

    "Qwen/Qwen2.5-7B-Instruct",

    torch_dtype=torch.bfloat16,  # bfloat16: メモリ効率の高い浮動小数点形式

    device_map="cuda"            # GPU上にモデルを配置

)

# サンプルテキストをトークン化してGPUに転送

ids = tok(

    "The quick brown fox jumps over the lazy dog.",

    return_tensors="pt"

).to("cuda")

# モデルを実行し、中間アクティベーション(隠れ状態)を取得

# output_hidden_states=True : 全レイヤーの中間出力を返す設定

# .hidden_states[20]        : 20層目のアクティベーションを選択

# [0]                       : バッチの1番目(形状: [seq_len, 3584])

hs = m(**ids, output_hidden_states=True).hidden_states[20][0]

# Parquetファイルとして保存

# activation_vector列にfloatのリストとしてアクティベーションを格納

pq.write_table(

    pa.table({"activation_vector": hs.float().cpu().tolist()}),

    "demo.parquet"

)
注意: このコードにはGPUと十分なVRAM(7Bモデルでbfloat16の場合、約14GB以上)が必要です。VRAMが不足する場合は load_in_4bit=True による量子化を検討してください。
リリース済みチェックポイント一覧
Hugging Faceの kitft/nla-models コレクション に以下の4モデル(各AVとAR)が公開されています。
| ベースモデル | 抽出レイヤー | d_model | AV モデル ID | AR モデル ID |
| Qwen2.5-7B-Instruct | 20 / 28 | 3584 | kitft/nla-qwen2.5-7b-L20-av | kitft/nla-qwen2.5-7b-L20-ar |
| Gemma-3-12B-IT | 32 / 48 | 3840 | kitft/nla-gemma3-12b-L32-av | kitft/nla-gemma3-12b-L32-ar |
| Gemma-3-27B-IT | 41 / 62 | 5376 | kitft/nla-gemma3-27b-L41-av | kitft/nla-gemma3-27b-L41-ar |
| Llama-3.3-70B-Instruct | 53 / 80 | 8192 | kitft/Llama-3.3-70B-NLA-L53-av | kitft/Llama-3.3-70B-NLA-L53-ar |
抽出レイヤーはモデル深さの2/3程度に設定されています。GitHubのREADMEによれば「意味的情報が豊富に符号化されながら、まだ出力層への変換が始まっていない深さ」として選ばれています。各チェックポイントには nla_meta.yaml サイドカーファイルが付属しており、プロンプトテンプレートや注入スケールなどのモデル固有設定が含まれています。ハードコードせず、このファイルから読み込むことが推奨されています。
訓練の再現(上級者向け)
チェックポイントを自分で再現したい場合の手順です。Miles(Ray・FSDP2ベースのRLフレームワーク)とSGLangを組み合わせた3ステージの訓練パイプラインを使用します。Qwen2.5-7Bが参照例です。
# 0. データ生成(GPU + ANTHROPIC_API_KEY が必要)

# アクティベーションを収集しParquet形式に変換する4段階パイプライン

python -m nla.datagen.run_pipeline --config configs/datagen/qwen7b_fineweb_1M.yaml

# 1. AR(活性化再構成器)のSFT訓練

# 生のアクティベーションを入力とする MSE(平均二乗誤差)最小化

bash configs/critic_sft.sh

# 2. AV(活性化言語化器)のSFT訓練

# AnthropicのAPIが生成した説明文を教師データとしたネクストトークン予測

bash configs/actor_sft.sh

# 3. RL訓練:AV(GRPO方式)とAR(教師あり学習)の同時訓練

# 報酬関数 = -mse_nrm(正規化MSEの負値)

bash configs/rl.sh
注意: ステージ2の実行には ANTHROPIC_API_KEY 環境変数が必要です。Qwen2.5-7BのSFT訓練は2枚のH100-80GBで、RL訓練は2×8枚のH100が参照環境として使用されています。詳細は docs/design.md と configs/TRAINING_NOTES.md を参照してください。
NLAの限界と今後
Anthropicはいくつかの重要な限界を明記しています。まず ハルシネーションの問題 です。NLAの説明が事実に反する内容を含む場合があります。たとえば「”Wearing my white jacket” のような表現があった」という説明を生成しても、実際のテキストに該当する語句がないケースが確認されています。コンテキスト内のテキストとの照合で検知できますが、モデルの内部思考に関する主張については照合が困難なため、複数の手法で独立に裏付けることが推奨されています。
次に 計算コストの高さ です。訓練には言語モデル2台分の強化学習が必要で、推論時も1アクティベーションあたり数百トークンを生成します。長い会話全体を対象としたリアルタイム監視や、訓練中の大規模モニタリングには現実的ではありません。コスト削減に向けた改善をAnthropicは進めているとしています。
まとめ
AnthropicのNLAは、AIの内部思考を直接テキストとして読む新しいアプローチです。安全テストでの評価認識の検出や隠れた動機の監査など、すでに実用的な応用実績があります。コードと学習済みモデルが公開されており、Gemma・Qwen・Llamaを使った独自の解釈可能性研究の出発点としても活用できると思います。同分野の先行研究として、 Gemma Scope 2の解説 もあわせてご覧いただければと思います。