はじめに
AnthropicのLaura Luebbert氏らが2026年6月8日、AIエージェントによるウイルス配列データ取得の精度検証と、その解決策を示した研究エッセイを公開しました。本稿では、なぜ最先端AIエージェントでも生物データベースを正確に操作できないのか、また専用ツール「gget virus」がどのように精度を改善したのかを解説します。
参考記事
- タイトル: Paving the way for agents in biology
- 著者: Laura Luebbert(Ferdous Nasri、Sarah Gurev、Patrick Varilly、Krithik Ramesh ほか)
- 発行元: Anthropic Research Blog
- 発行日: 2026年6月8日
- URL: https://www.anthropic.com/research/agents-in-biology
関連記事
要点
- コーディングエージェントと異なり、生物系エージェントには「決定論的な実行層」が整備されておらず、データ取得の信頼性が低い
- Claude Sonnet 4やGPT-5.5など6モデルでウイルス配列取得の精度を評価したところ、平均精度は16.9〜91.3%にとどまり、同一クエリでも実行のたびに結果が変わる再現性の問題が確認された
- 専用ツール「gget virus」を組み合わせると、全モデルの精度が90%超に向上し、実行間のばらつきも大幅に低下した
- 不正確なデータ取得は下流の生物学的解析に重大な影響を与え、エボラウイルスの系統樹では起源推定が1922年にまでずれる事例が示された
- 科学AIの信頼性向上には、モデル性能の向上だけでなく、エージェントを念頭に置いた生物データ基盤の設計が必要である
詳細解説
コーディングエージェントが進化した理由、生物エージェントが遅れている理由
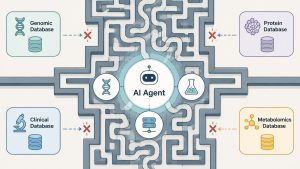
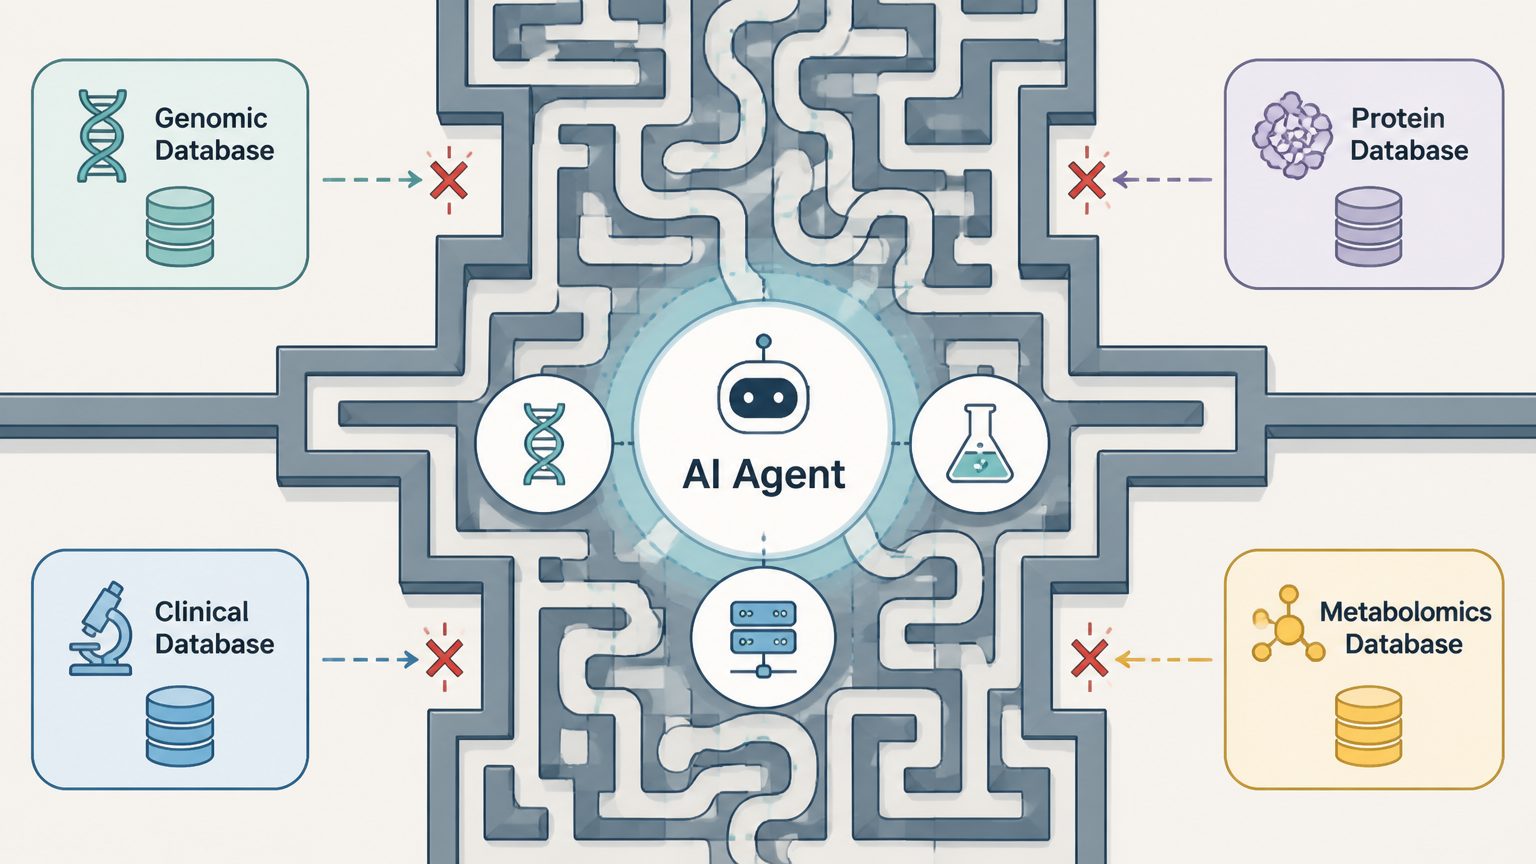
Laura Luebbert氏らは、AIエージェントが生物データ基盤を操作する際の困難を、「自動車時代より前に設計された古い都市を車で走るようなもの」と表現しています。ソフトウェア開発の世界では、バージョン管理システムや文書化されたAPIといった整備されたインフラが存在するため、エージェントは動作確認可能な出力を素早く生成・検証できます。一方、計算生物学のデータ基盤は、独自フォーマット、複数のデータベース、属人的な取得スクリプトが混在しており、エージェントが依存できる機械可読なインターフェースが整っていない状態です。
この「基盤の差」が、コーディングエージェントと生物エージェントの進化速度の差を生んでいると著者らは論じています。生物データ取得のボトルネックはモデルの推論能力だけでなく、クエリ結果を確実に取得・検証・再現するための決定論的な実行層が欠如していることにあると考えられます。
VirBenchで明らかになった最先端モデルの限界
著者らはこの問題を定量化するため、「VirBench」と名付けたベンチマークを開発しました。40種のウイルスを対象とした120件の配列取得クエリで構成され、ウイルス監視・診断アッセイ設計・タンパク質モデルの学習データ構築といった実際の研究ワークフローを反映しています。評価対象はClaude Sonnet 4、Claude Opus 4.7、Biomni OSS、Edison Analysis、GPT-5.2-pro、GPT-5.5の6モデルです。
Anthropicの発表によれば、これらのモデルの平均精度は16.9〜91.3%の範囲に分布し、最強モデルでも科学用途が求める実質100%の精度には届きませんでした。また同一クエリに対して同一モデルが毎回異なる結果を返す再現性の低さも確認されています。Claude Sonnet 4では、あるエボラウイルスのクエリに対して、1回目は106件、2回目は15件、3回目は5件という大きく異なる件数を返し、いずれも正解の266件とは一致しませんでした。
性能低下の主な原因として、大規模な結果セット(SARS-CoV-2やインフルエンザAなど)での途中打ち切り、フィルター条件の誤適用、文脈や慣習に依存したメタデータフィールドの解釈ミスが挙げられています。フィルター条件が3〜4つを超えると、精度は顕著に低下する傾向も見られました。
誤ったデータ取得が生物学的結論を変える
著者らはこの問題が単なる精度の問題にとどまらないことを、2つの具体的な解析で示しています。
1つ目はエボラウイルスの系統樹解析です。2014年西アフリカエボラ流行の配列データを手動でNCBIから取得して構築した系統樹では、最も直近の共通祖先の推定時期(TMRCA)が2014年1月と算出され、既報と一致しました。一方、Sonnet 4が取得したデータセットのうち2件は明らかに不完全であり、そのうちの1件が推定Tを1922年にまで押し戻す結果となりました。残り1件は表面上は妥当に見えましたが、ギニアのデータが欠落しており、TRCAが2014年4月にずれるという問題がありました。流行の起源時期の誤推定は、感染経路の解明や対応策の優先順位づけに直接影響します。
2つ目は、エボラウイルスに対する抗体治療薬「maftivimab」「MBP134」の有効性評価です。ウイルスの進化に伴い抗体が結合するエピトープ領域に変異が蓄積していないかを調べる解析で、Sonnet 4が取得したデータは3回の実行でそれぞれ異なる残基セットをハイライトし、治療薬の有効性について3つの異なる印象を与える結果となりました。このような「もっともらしいが誤っている」結果は、取得ステップが後続する長い解析パイプラインの入口である点で特に危険だと思います。
gget virusが精度をほぼ100%に引き上げた仕組み
こうした問題に対応するため、著者らはNCBIの研究者と協力して「gget virus」という決定論的な取得ツールを開発しました。NCBI Virusは複数のAPIや国際データベース(米国・欧州・日本のINSDCエコシステム)を統合したポータルであり、その全フィルタリングロジックをプログラムから再現することは困難でした。
gget virusはREST・Datasets・E-utilitiesの各APIを協調させながら動作し、ウェブインターフェースが提供するフィルタリング機能のうちAPIで適用できないものはローカルで処理します。大量の結果セットに対してはバッチ処理で網羅的に取得し、タンパク質情報など別のデータベースに分散した情報も統合した上で標準化された出力を返します。詳細なログも出力されるため、どのように結果が得られたかを事後検証できる点も重要な特徴です。
Anthropicによれば、gget virusを組み合わせた場合、全モデルの精度が90%超に向上し、GPT-5.5では99.7%を達成しました。実行間のばらつきもほぼ解消され、モデル間の性能差も大幅に縮小しました。最高性能モデルでなくても高精度な取得が可能になることは、最新・高価格モデルへのアクセスに依存しない民主的な研究環境の実現という観点からも意義があると考えられます。
「エージェント対応」のデータ基盤設計に向けて
著者らはこの事例を超えた、より広い視点での示唆も論じています。gget virusはあくまで一つの事例であり、同様の課題は生物データ全体に広がっています。一方で、モデル性能の急速な向上に伴い、将来的にはエージェント自身が複雑なポータルをナビゲートできるようになる可能性も否定できません。しかし著者らは、「エージェントにできたとしても、毎回エージェントが担うべきとは限らない」と述べており、実行コスト・速度・監査可能性・信頼性の観点から、決定論的なツール層を整備する意義は引き続き存在すると指摘しています。
科学的発見の加速に向けてAIエージェントを活用するには、モデルの推論能力の向上と並行して、生物データ基盤そのものをエージェントが利用しやすい形で設計・整備していくことが必要だと思います。ソフトウェア開発の世界が「エージェントのために作られたインフラ」を当たり前のように持っているように、生物学の世界にも同様の変革が求められています。
まとめ
最先端のAIエージェントでも、エージェントを前提に設計されていない生物データ基盤では精度が不安定になることが、VirBenchで定量的に示されました。gget virusによる決定論的取得層の追加が精度を劇的に改善したことは、科学AIの信頼性向上にはモデル単体でなくインフラ設計の変革が必要だという点を示す事例です。AIと科学研究の協働がどう進化しているかも、あわせてご覧いただければと思います。