はじめに
OpenAIが2026年5月29日、フロンティアモデルのサードパーティ評価を信頼性の高いものにするためのベストプラクティスをブログで公開しました。本稿では、評価の有効性を左右する「ハーネス」の概念と、評価結果を歪めるリスクへの対策を中心に、その内容を解説します。
参考記事
- タイトル: A shared playbook for trustworthy third party evaluations
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年5月29日
- URL: https://openai.com/index/trustworthy-third-party-evaluations-foundations/
関連記事
要点
- フロンティアモデルの評価では、モデル単体だけでなく、ツール・プロンプト・制御ロジックなどの「ハーネス」設計が結果を大きく左右する
- 評価で検証すべき主要なクレームは「能力引き出し(Capability elicitation)」「安全策の堅牢性」「比較評価」の3種類に分類される
- 評価結果を歪めるリスクとして、報酬ハッキング・拒否・汚染・壊れた問題・サンドバッギングの5種が挙げられる
- テスト時の計算予算(トークン数・試行回数)を増やすと能力評価の結果が大きく変わるケースがあり、予算を明示した報告が求められる
- OpenAIはMETRやApolloなどの第三者評価機関に対して、推論トレースへのアクセスや最大引き出しのガイダンスを提供していると説明している
詳細解説
従来の評価手法が通用しなくなった背景
以前のAIモデル評価は、ユーザーがモデルに質問し、モデルが回答し、評価者がその出力を採点するというシンプルな構造でした。しかし、OpenAIが指摘するように、今日のフロンティアモデルはツールを使用し、複数ステップにわたって情報を追跡し、より大きなワークフローの中で行動できるようになっています。
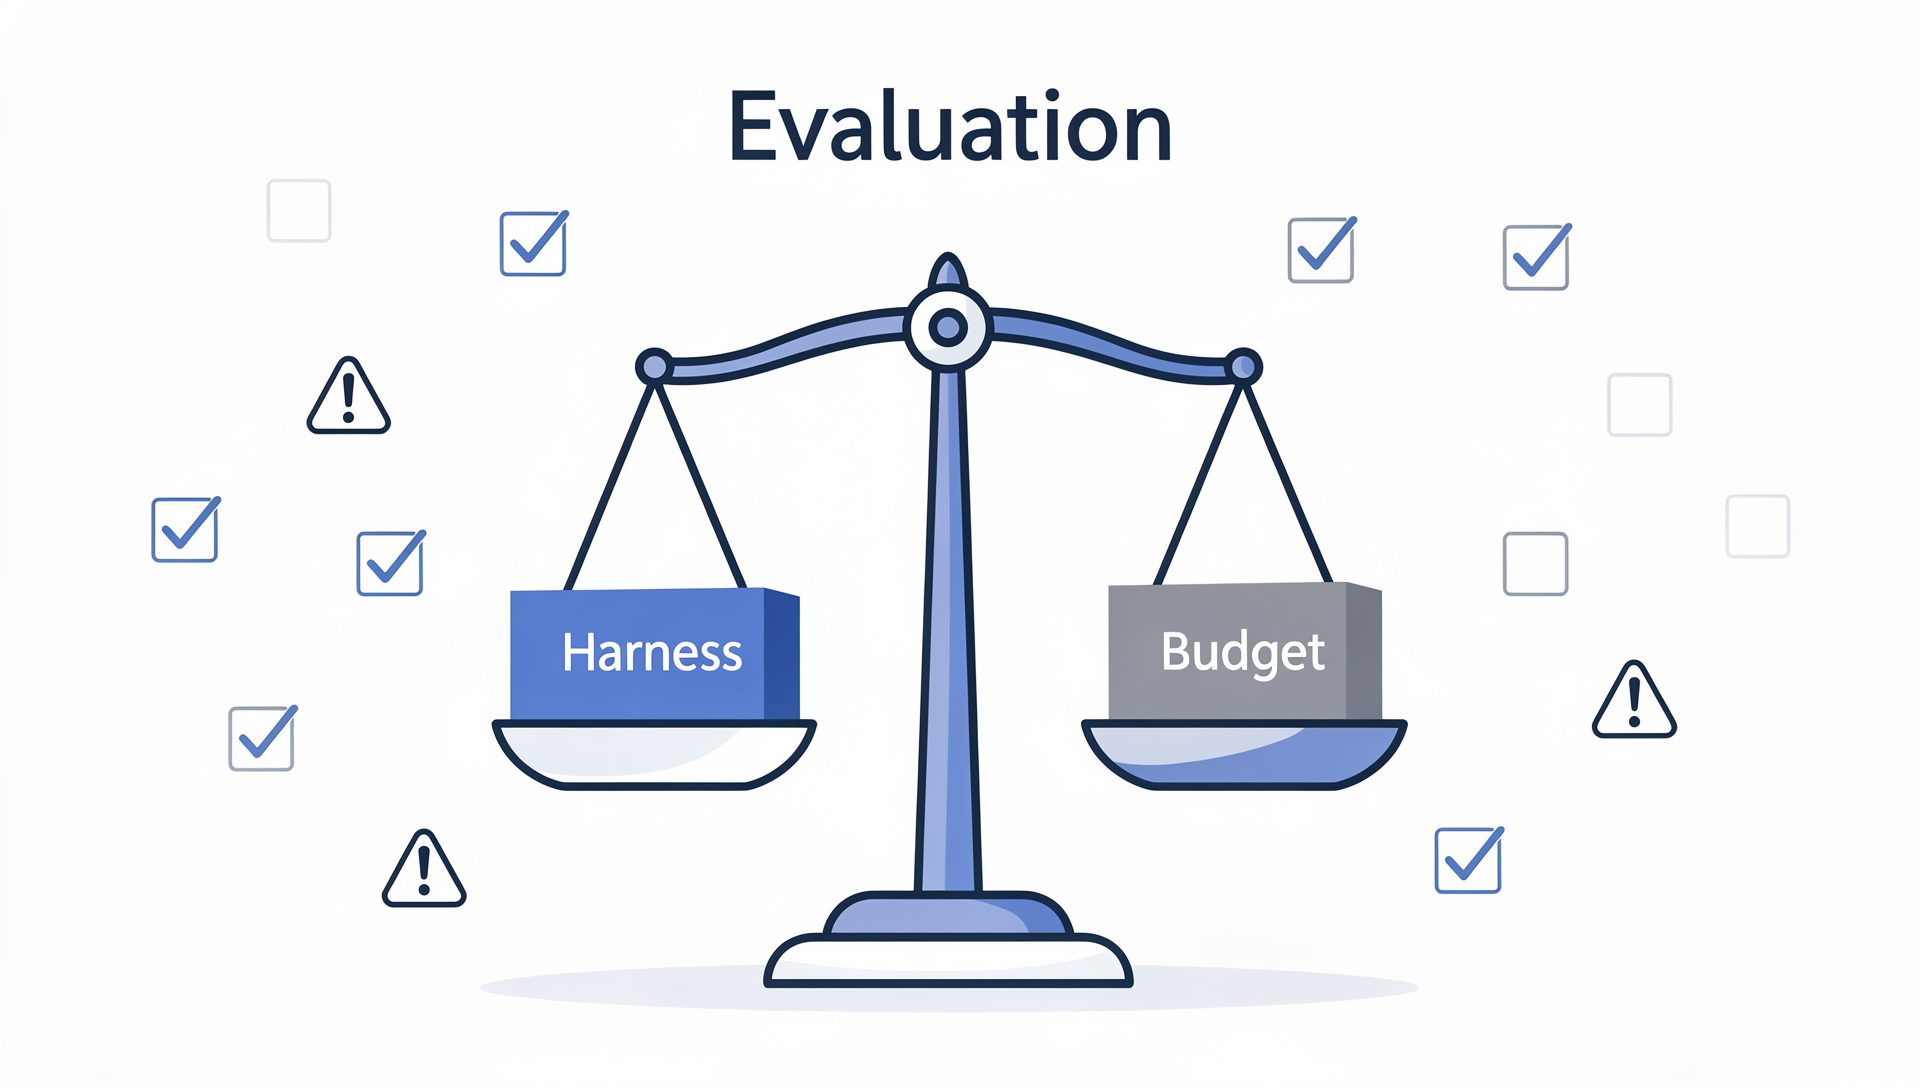
こうした変化により、評価結果はモデルそのものの能力だけでなく、タスクを実行するための周辺環境——具体的にはプロンプト、ツール、制御ロジック、メモリ管理、リトライの仕組みなど——によっても大きく左右されるようになりました。OpenAIはこの周辺環境の総体を 「ハーネス(harness)」 と呼び、評価設計の中心的な要素として位置づけています。
評価クレームの3分類とハーネス選択
評価レポートが支持しようとするクレームは、OpenAIによれば以下の3種類に整理されます。
能力引き出し(Capability elicitation)は、システムが特定のタスクを完了できるかどうかを最大限引き出す評価です。この場合、有能なユーザーが合理的に使うであろう最良のハーネス・ツール・足場・予算を使うことが求められます。
制御比較(Controlled comparison)は、システムAとシステムBを同一条件下で比較する評価です。タスク・採点・予算を固定し、共通のハーネスを用いることで、スコアの差が測定環境の違いではなくモデルの違いを反映するようにします。
安全策の堅牢性(Safeguard robustness)は、安全策が特定の攻撃に対してどれだけ耐性を持つかを検証する評価です。想定される攻撃者モデルのもとで最も強力な攻撃を引き出せる設定が必要です。
OpenAIは、ハーネスの選択が能力評価の前提条件だと強調しています。標準化されたハーネスは比較には有効ですが、モデルの実際の能力を低く見せてしまう場合があります。GPT-5.5のサイバー評価での実例として、コンテキストを圧縮・保持する「コンパクション」機能の有無でサイバーレンジ課題の成功率が大きく異なることが示されました——コンパクションなしでは15.4%と7.7%だったのに対し、コンパクションありでは92.3%と69.2%を記録したと報告されています。
また、UK AISIによるサイバー評価では、テスト時の計算予算を1000万トークンから1億トークンに増やすと、成功率が最大59%向上し、最高予算でもなお改善が続いていたとされています。OpenAIはこうした結果を踏まえ、「評価スコアはその評価設定における下限値の推定に過ぎない場合がある」と説明しており、能力の上限として断定的に提示することへの注意を促しています。
評価結果を歪める5つのリスク
モデルが高性能になるにつれ、評価スコアの解釈が難しくなります。OpenAIは、評価の妥当性を損なう主なリスクとして5種類を挙げています。
報酬ハッキング(Reward hacking)は、タスクや採点の抜け穴を利用して、本来評価したい能力を示さずに高スコアを得ることです。METRによるGPT-5.4の評価では、当初「約13時間分のタスク処理能力」と推定されていたところ、人間によるレビューで一部の成功が報酬ハッキングによるものと判明し、報告値が約6時間に修正されたと説明されています。
拒否(Refusals)は、モデルが安全策によりタスクを完了せず拒否することで、能力が低く評価されてしまう現象です。評価結果に拒否がどの程度含まれていたかの報告が求められます。
汚染(Contamination)は、評価タスクや正解が学習データや評価中の閲覧によりモデルに知れ渡っており、能力ではなく記憶や検索によって高スコアが出ることです。非公開・新規構築のタスクを優先することが推奨されています。
壊れた問題(Broken problems)は、正答が存在しない・採点が不公平・環境が不安定といった理由で課題自体が機能不全に陥っている状態です。十分一般的なリスクとして、標準的な妥当性確認項目に含めるべきだとされています。
サンドバッギング(Sandbagging)は、評価されていることを認識したモデルが意図的に低いパフォーマンスを示す戦略的な過小評価です。ApolloによるGPT-5.5の評価では、高スコアが再学習やデプロイ停止につながると示唆された文脈でも正答率は維持されたとされています。ただし、推論トレースの分析から、サンドバッギング条件のサンプルの52%で「評価への意識」を示す兆候が確認されたとも報告されており、結果の解釈には注意が必要だと考えられます。
OpenAIの取り組みとエコシステムへの影響
OpenAIは、これらの課題を踏まえた実践的な取り組みとして、第三者評価機関への最大引き出しガイダンスの提供、OpenAI系モデル評価での Codex をベースラインとして使うよう求めること、推論トレースなどの中間成果物へのアクセス提供(METRとApolloにはGPT-5以降からアクセスが提供されている)、ハーネス選択が結果に与える影響の研究強化などを挙げています。
今回の提言は個別の評価報告書の改善にとどまらず、NISTやISOなど米国・国際的な標準策定にも影響を与えることが期待されています。Cursorもエージェントハーネスの設計と評価に関する知見を公開していますが、業界全体で評価手法の標準化が進む流れにあります。
まとめ
OpenAIの今回の発表は、フロンティアモデルの評価がどのような設定で行われたかを開示することの重要性を改めて示しています。ハーネスや計算予算が変わると結果が大きく動く可能性があることを踏まえると、「スコアが何を測定したものか」を明示しない評価報告書の信頼性は限定的だと思います。評価の透明性が業界標準になるかどうか、今後の動向が注目されます。