はじめに
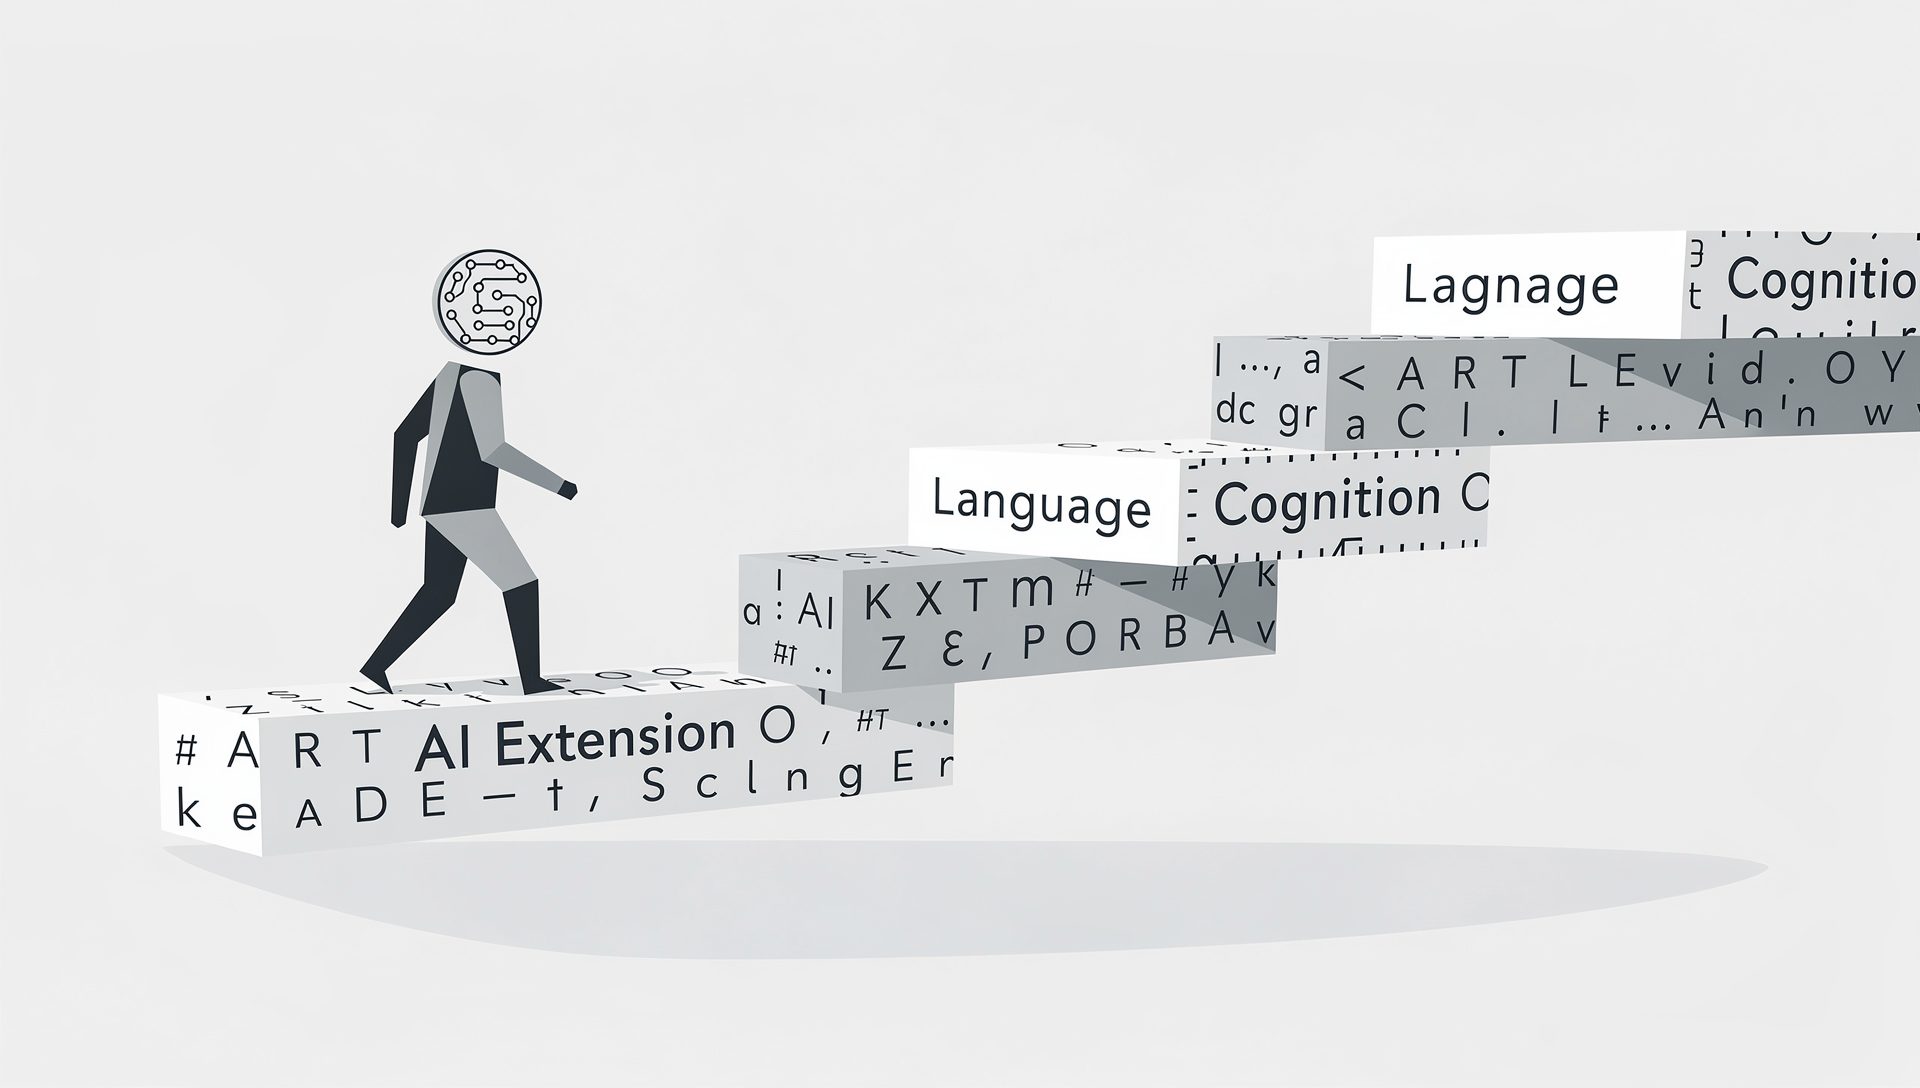
MicrosoftのKen Archerとリンショーピング大学のHarald Wiltsche教授が2026年5月27日、Microsoft Researchブログに論考を公開しました。現代のAIシステムは人間の知性を複製するのではなく、人間の認知に根ざした構造を「前提として拡張」しているという観点から、AIの能力と限界を統一的に説明する枠組みを提示しています。
参考記事
- タイトル: Extending Human Intelligence Through AI
- 著者: Ken Archer(Microsoft Research)、Harald Wiltsche(リンショーピング大学教授)
- 発行元: Microsoft Research Blog
- 発行日: 2026年5月27日
- URL: https://www.microsoft.com/en-us/research/blog/extending-human-intelligence-through-ai/
関連記事
要点
- 現代のAIシステムが強力である理由は人間の知性を模倣するからではなく、人間の認知と言語にすでに堆積した構造を前提として拡張しているからである
- フッサールの現象学に基づけば、言語には人間の経験から生まれた概念的構造が含まれており、LLMはその統計的関係を学習・拡張している
- ハルシネーションや「合成性のギャップ(compositionality gap)」は工学的な欠陥ではなく、AIが世界への直接的な関与を持たないことから生じる構造的な限界である
- AI安全性は「暴走するAI」の問題ではなく、人間の監視・ガバナンス・多層的なセーフガードを中心としたシステムレベルの課題として捉え直す必要がある
- AIを「競合する知性」と誤解することが最大の社会的リスクであり、人間がAIを理解し・統治し・活用する責任を持ち続けることが信頼できるシステムの前提となる
詳細解説
「なぜAIは機能するのか」という問い直し
AIの能力と限界を同時に説明できる一貫した理論は、これまで十分に整理されてきませんでした。論考では、DeepMindの研究者Alexander Lerchnerによる The Abstraction Fallacy やFrank・Gleiser・Thompsonらの The Blind Spot といった近年の学際的研究を踏まえつつ、現象学者エドムント・フッサールの視点からAIを捉え直すアプローチを提示しています。
そこで示されるのは「AIはなぜ人間のように賢くなったのか」ではなく、「AIはなぜ機能するのか」という問いです。著者らの答えは明確で、AIシステムは人間の認知においてすでに成立している構造を前提として成り立っているからこそ、機能するということです。
言語に堆積した人間の経験
フッサールの現象学によれば、人間の知覚は単なる感覚データの受動的な受け取りではありません。私たちはカップが視点を変えても同じカップであることを認識し、メロディが時間をまたいでも同一の曲として聞こえるように、変化のなかに安定した構造を見出します。言語とは、こうした経験的な安定性を概念として表現したものです。「赤い」「丸い」「より大きい」といった言葉には、生きた経験から生まれた関係性が含まれています。
大規模言語モデル(LLM)は、この「経験が堆積した言語世界」のなかで統計的な関係を学習します。膨大な人間の記述から概念がどのように結びつくかを捉えているため、多様な領域で一貫した応答を生成できます。Microsoft Researchの論考では、これがAIの強みの根拠であると同時に、ハルシネーションの構造的な説明にもなると指摘しています。人間は世界との継続的な関与によって認識を修正し続けますが、AIはテキスト内のパターンを拡張するにとどまります。世界への直接的な関与がない以上、意味と真実を「地に足のついた形」で扱う機能が欠けているというわけです。
合成性のギャップと視覚モデルの限界
この枠組みは、AI研究における具体的な課題を一貫して説明します。「合成性のギャップ(compositionality gap)」と呼ばれる現象——LLMが馴染みのある推論パターンでは高い精度を示す一方、概念を本当に新しい形で組み合わせることが苦手という傾向——は、工学的な欠陥というより構造的な限界と見なせます。論考によれば、モデルを大きくすると流暢さや事実の想起は速く改善しますが、真の合成的推論の改善はそれよりもはるかに遅いとされています。
同様のパターンは言語と視覚を組み合わせたマルチモーダルシステムにも見られます。画像を正しくラベル付けできても、時間を通じて安定した物体として認識する能力には依然として脆さが残ります。視覚パターンと言語の相関を学習しているものの、人間のように物体を「持続するもの」として知覚する構造を持たないためだと考えられます。
AI安全性の再フレーミング:モデルからシステムへ
この論考で特に注目されるのは、AI安全性に関する議論の組み替えです。「AIが人間のような意図を持って暴走する」という恐怖と「AIはたいして危険でない」という楽観論は、どちらも現実のシステムを正確に捉えていないと著者らは指摘します。
実際のリスクは、AIが反省的な世界への責任なしに推論パターンを拡張することから生まれます。根拠のない出力が説得力を持って伝わること、欠陥のある意思決定が大規模に自動化されること、不十分なガバナンス環境に組み込まれた際の有害な動作——これらが現実的な懸念事項です。この観点から、信頼できるAI行動は多層的なセーフガード(業界では「ハーネス」とも呼ばれます)によって確保されるものとなります。これは暫定的な対処ではなく、AIアーキテクチャの本質的な特性を反映したものだと論考は論じています。
生成AIのガバナンスに関しては、MetaがAI安全性フレームワークを大幅更新した際にも「なぜ安全か」を学習するモデルアプローチが注目されましたが、本論考が提示するのはより根本的な視点です。AIシステムそのものに安全性を委ねることはできないという主張です。
AIを「競合する知性」と誤解するリスク
著者らが最後に強調するのは、AI理解の枠組みそのものが持つ社会的影響です。AIを自律的な心として過信すれば、適切な人間の監視が薄れます。逆に「単なる統計的なトリック」と軽視すれば、現代技術の重要性を見逃します。どちらも、AIを人間知性の派生物として正確に理解していない点で問題があると論考は指摘します。
AIが能力を持つのは、人間の経験と認知から生まれた構造を拡張しているからこそです。したがって、AIを理解し・統治し・活用する責任は人間のもとに留まり続けます。この認識こそが、信頼できるAIシステムを構築するための出発点だということです。
まとめ
Microsoftとリンショーピング大学の共同論考は、フッサールの現象学を援用することでAIの能力と限界を一つの枠組みで説明し、安全性議論の焦点を「暴走するAI」からシステムレベルのガバナンスへと移す視点を提示しました。AIを人間知性の「拡張」として正確に理解することが、信頼できる活用の前提となるというメッセージは、AIとの向き合い方を改めて問いかけるものだと思います。AIの哲学的・倫理的側面に関心がある方は、哲学者がAI開発者に倫理を問う論考もあわせてご覧いただければと思います。