はじめに
Mistralが2026年5月28日、プロダクション向け検索パイプラインを構築するためのOSSフレームワーク「Search Toolkit」をパブリックプレビューとして公開しました。本稿では、Search Toolkitの設計思想・主要機能・クイックスタート手順を解説します。
参考記事
- タイトル: Introducing Search Toolkit
- 発行元: Mistral AI
- 発行日: 2026年5月28日
- URL: https://mistral.ai/news/search-toolkit/
関連記事
要点
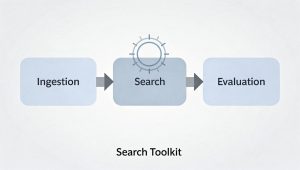
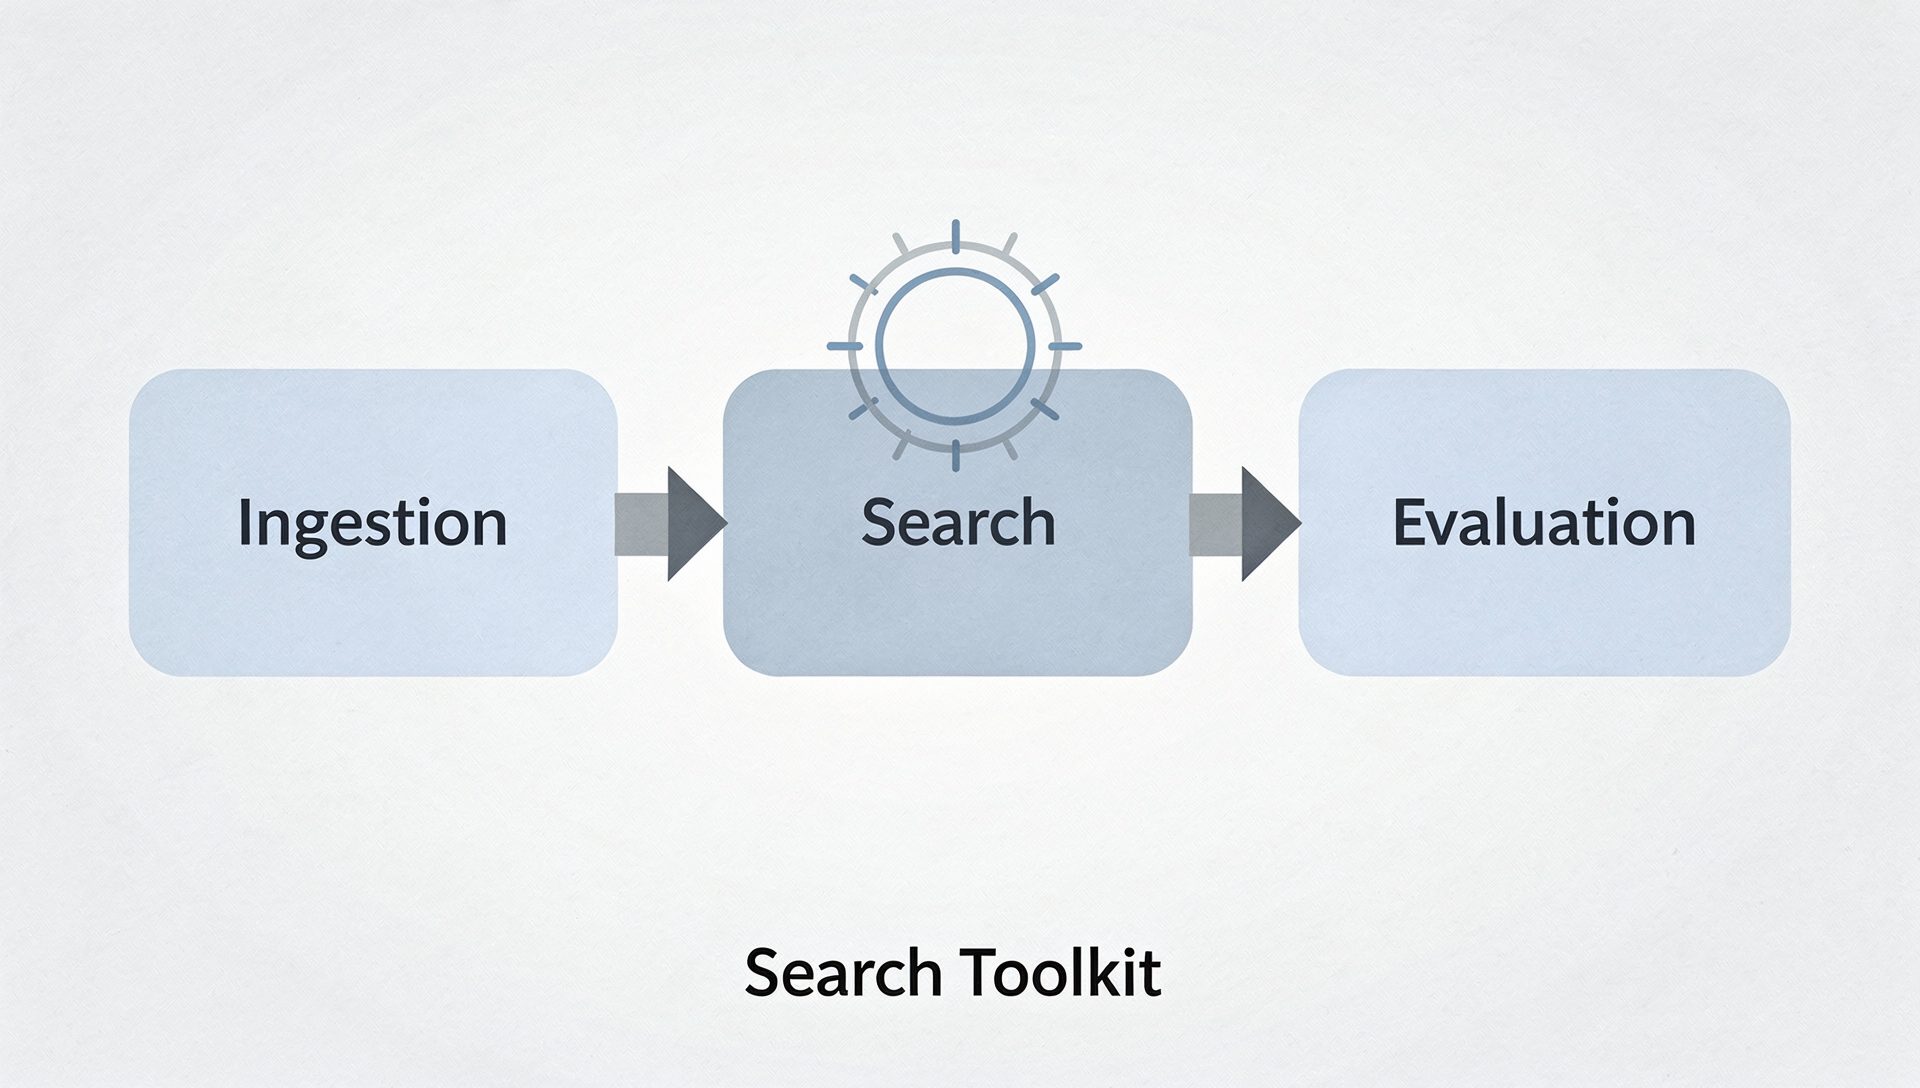
- Search Toolkitは、データの取り込み(インジェスト)・検索(リトリーバル)・評価(エバリュエーション)の3モジュールを共通インターフェースで統合したOSSフレームワークである
- BM25スパース検索・密ベクトル検索・ハイブリッド構成の3方式から選択でき、LLMクエリ書き換えやリランキングなど高度な機能も利用可能である
- Recall・Precision・MRR・NDCGといった標準指標で検索品質を独立評価でき、生成品質との切り分けが可能になる
- クラウド・オンプレミス・エッジの任意の環境で動作し、エンタープライズ向けの実運用実績(金融・製造・公共・メディア)がある
- スターターアプリテンプレートが提供されており、DockerとuvがあればすぐにローカルでVespaを起動して試せる
詳細解説
Search Toolkitが生まれた背景
RAGシステムや社内検索基盤を構築するチームは、取り込み・検索・評価のそれぞれに別々のツールを使い、それらを統合する「配管工事」だけで数週間を費やすことが多いとMistralは指摘しています。Search Toolkitはこの課題を解消するために設計されたフレームワークです。
従来の構成では、ドキュメントの解析・チャンキング・埋め込み生成に独自のインジェストツール、検索には別のベクトルDBライブラリ、評価には第三者ツール、という形で各レイヤーがバラバラに存在していました。Search Toolkitはこれら3つを 共通の設定インターフェース で繋ぎ、「インデクサーを差し替える」「リトリーバーを変える」「エバリュエーターを追加する」といった操作を一貫した方法で行えるようにしています。
OSSとして提供されており、クラウド・オンプレミス・エッジの任意のインフラ上で動作する点も特徴です。
主要ユースケース:エンタープライズ検索・RAG・ドメイン特化検索
Mistralは3つの主要ユースケースを提示しています。
エンタープライズ検索 では、社内Wiki・サポートチケット・ドキュメントリポジトリ・コードベースなど、構造の異なる複数のデータソースを統一的に検索する用途に対応しています。従来は各ソース向けに別々のインジェストパイプラインを構築する必要がありましたが、Search Toolkitが一貫した処理・インデックスパターンを提供することで、新しいソースを追加する際もパイプライン全体を再構築せずに済むと説明されています。
RAG品質の改善 では、「RAGシステムが悪い結果を返した際に、問題が検索側にあるのか生成側にあるのか判断できない」という現場の課題に対応しています。Search Toolkitに組み込まれた評価機能により、検索品質を生成品質とは独立して測定・比較できるため、改善施策の効果を切り分けて確認できます。これは、プロンプト調整やモデル変更の前に「そもそも検索が正しい文書を返しているか」を確認するうえで重要な機能だと思います。
ドメイン特化検索 では、法律文書・医療記録・コードベース・金融開示文書など、汎用の検索エンジンが苦手とする専門領域に対応しています。カスタムドキュメントフォーマットや前処理ステップを標準アダプターインターフェース経由で組み込める設計になっています。
エージェントとの連携
Mistralは、エンタープライズ環境で動作するAIエージェントが高品質な検索基盤を必要とする点も強調しています。エージェントが大規模なドキュメントコーパスを対象にセマンティック検索を実行する場合にはインデックスベースの検索を使い、最新の状態が必要な場合には Connectors 経由でCRM・コードリポジトリ・生産性ツールなどのソースシステムからライブデータを取得する、という使い分けが想定されています。
Search ToolkitはこのエージェントのインデックスベースSearch経路を担うコンポーネントとして位置づけられています。
3つのコアモジュール
インジェスト(取り込み) モジュールは、ドキュメントの解析・チャンキング・埋め込み生成を処理します。設定可能なパイプラインとして提供されており、カスタムドキュメントフォーマットや独自の前処理ステップをアダプター形式で差し込めます。
リトリーバル(検索) モジュールは、BM25スパース検索・密ベクトル検索・両者を組み合わせたハイブリッド構成の3方式を提供します。BM25はキーワードの完全一致に強い従来型の検索手法で、密ベクトル検索は意味的な類似度に基づく検索手法です。ハイブリッド構成はこの2つを組み合わせることで、両方の強みを活かした精度の高い検索を実現します。さらに、LLMによるクエリの書き換え・リランキングといった高度な機能も利用可能です。
エバリュエーション(評価) モジュールは、Recall(再現率)・Precision(適合率)・MRR(平均逆順位)・NDCG(正規化割引累積利得)という4つの標準的な情報検索指標を内包しています。自分のテストセットに対して評価を実行し、異なるリトリーバー設定をサイドバイサイドで比較できます。
Mistralによれば、Search Toolkitは金融・製造・公共セクター・メディアなどの垂直領域での実運用実績があり、CMA CGMはVoxtralと組み合わせてフェイクニュース検出パイプラインに利用。音声を3つのデータソースから処理し、エンドツーエンドで15秒以内にアラートを返す構成で動いているとのことです。
クイックスタート:スターターアプリで動かす
以下の手順は、Mistralが提供するスターターアプリテンプレートをもとにしています。参考記事のサンプルコードをベースにしており、実際の動作は環境によって異なる場合があります。
前提条件
- Docker(コンテナ実行環境)がインストール済みであること
- バージョン確認: docker –version
- uv(高速なPythonパッケージ・プロジェクト管理ツール)がインストール済みであること
- インストールされていない場合は uv公式ドキュメント を参照してください
1. プロジェクトのスキャフォールド
以下のコマンドで、Mistralが提供するGitHubテンプレートをもとに新しいプロジェクトを生成します。
# copierはテンプレートエンジンツールです

# uvx は uv 経由でツールを一時実行するコマンドです(インストール不要で使えます)

uvx copier copy gh:mistralai/search-starter-app my-search-project

# 生成されたプロジェクトディレクトリに移動します

cd my-search-project
注意: uvx は uv がインストールされていれば利用できます。uv が入っていない場合は pip install uvx でインストールできますが、uv 経由の利用を推奨します。
2. VespaをDockerでローカル起動
Vespa(ベスパ)は、Yahoo!が開発したオープンソースの検索・推薦エンジンです。Search ToolkitはVespaをインデックス基盤として使用します。
# Vespa をローカルの Docker コンテナとして起動します

# 初回は Vespa の Docker イメージ取得に数分かかる場合があります

make setup-vespa
注意: Dockerが起動していない状態でこのコマンドを実行するとエラーになります。事前に docker ps コマンドでDockerが動いているか確認してください。
3. サンプルデータをインデックスに取り込む
# sample_data/hello.txt のサンプルファイルをインデックスに登録します

# path= の後に自分のドキュメントのパスを指定することで独自データを取り込めます

make ingest path=sample_data/hello.txt
4. 検索クエリを実行する
# "hello world" というキーワードで検索します

# query= の後に任意のクエリ文字列を指定してください

make search query="hello world"
テンプレートには、Vespaのインデックス設定・BM25とベクター検索を組み合わせたハイブリッド検索・サンプルデータとインジェストパイプラインがあらかじめ設定されています。
次のステップ
動作確認後は、以下のドキュメントに進むことで機能を拡張できます。
- インジェストパイプラインのカスタマイズ — パーサー・チャンキング戦略・埋め込みモデルの設定 (ドキュメント)
- VespaスキーマとRelevance管理 — インデックス最適化とランキングプロファイルの調整 (ドキュメント)
- 高度なリトリーバルの構築 — LLMクエリ書き換え・リランキング・ハイブリッド検索の詳細設定 (ドキュメント)
まとめ
MistralのSearch Toolkitは、RAG基盤の構築において長年の課題だった「インフラの継ぎ接ぎ問題」に正面から取り組んだフレームワークだと思います。取り込み・検索・評価を共通インターフェースで統合し、検索品質の改善に集中できる設計は、エンタープライズ検索を構築するチームにとって実用的な選択肢になりそうです。RAG検索の基礎については、Gemini APIのFile Search機能に関する記事もあわせてご覧いただければと思います。