はじめに
Anthropicは2026年4月29日、バイオインフォマティクス分野における Claude の科学的能力を評価する新たなベンチマーク「BioMysteryBench」の結果を公開しました。99問の実データに基づく問題セットで、最新世代の Claude がヒトの専門家パネルでも解けない問題の一部を解くなど、AIの科学研究への実用性が改めて示されています。
参考記事
- タイトル: Evaluating Claude’s bioinformatics research capabilities with BioMysteryBench
- 著者: Brianna(Anthropic discovery team)
- 発行元: Anthropic
- 発行日: 2026年4月29日
- URL: https://www.anthropic.com/research/Evaluating-Claude-For-Bioinformatics-With-BioMysteryBench
関連記事

要点
- BioMysteryBench はバイオインフォマティクスの99問から成るベンチマークで、実世界データから客観的な正解が導ける問題のみで構成されている
- ヒトが解ける76問(ヒト解決可能問題)では、最新世代の Claude がヒトの専門家と同等以上の精度を記録した
- 専門家パネル5名が誰一人解けなかった23問(ヒト困難問題)のうち、Claude Mythos Preview は約30%を解くことに成功した
- 解の信頼性を分析すると、ヒト解決可能問題では「確実に解ける/解けない」の二極化が強く現れるが、ヒト困難問題では「偶発的な正解」の割合が高くなるという質的な差異が確認された
- Genentech/Roche が独自に開発した CompBioBench でも、Claude Opus 4.6 が全体81%・難問69%という結果を示しており、BioMysteryBench の知見と整合している
詳細解説
科学ベンチマークの難しさとBioMysteryBenchの設計思想
AI の科学研究への活用が広がる一方で、「AIがどの程度科学的な仕事をこなせるか」を正確に測るベンチマークの整備は遅れていました。Anthropicの研究者が指摘するように、生物学分野の評価には固有の難しさが三つあります。①同じ研究課題に対して複数の正しいアプローチが存在すること、②データのノイズや研究者の主観的な判断が異なる結論を生みやすいこと、そして③人類がまだ答えを知らない問題こそ、AI の貢献余地が大きいという逆説です。
これらの課題に対応するため、BioMysteryBench は「科学的結論ではなく、データの客観的な性質から正解を導ける問題のみを採用する」という設計方針を採用しています。たとえば「この単一細胞 RNA-seq データはどの臓器由来か」「全ゲノム配列から、サンプルXの親はどれか」といった問いは、実験や臨床記録によって独立に検証できる客観的な答えを持っています。これにより、人間の専門家でも解けない問題を正解付きで出題することが可能になります。
問題の分野は WGS(全ゲノムシーケンシング)、scRNA-seq(単一細胞 RNA シーケンシング)、ChIP-seq、メタゲノミクス、Hi-C、プロテオミクス、メタボロミクスと多岐にわたります。Claude は問題ごとにコンテナ環境に置かれ、標準的なバイオインフォマティクスツールや pip・conda によるツールの追加インストール、NCBI や Ensembl などの公開データベースへのアクセスが許可された状態で回答します。
ヒト解決可能問題:専門家水準に到達
Anthropicによれば、ヒトの専門家が少なくとも1名以上正解した76問(ヒト解決可能問題)において、最新世代の Claude はヒトの専門家と同等の精度を示しました(図1)。
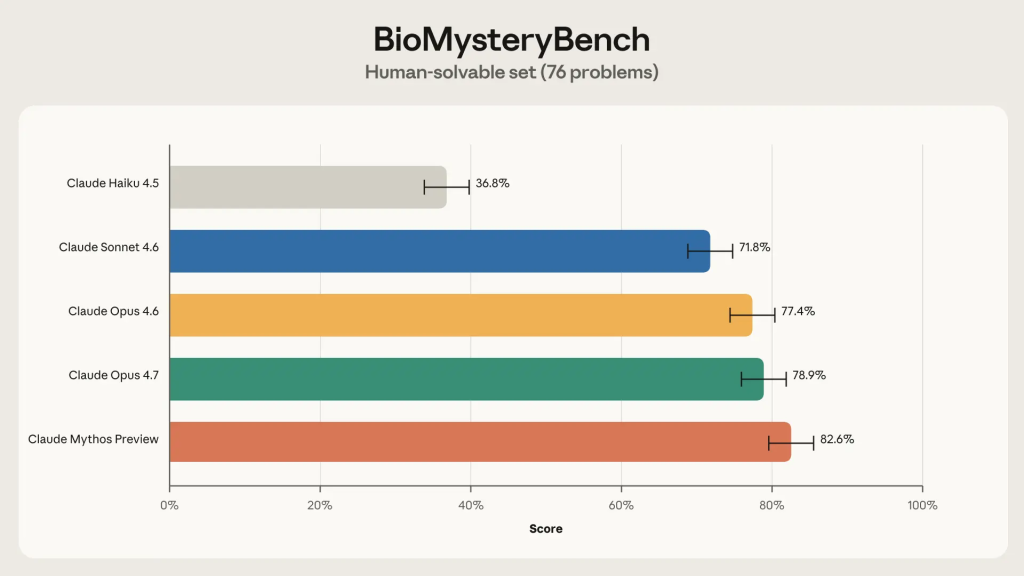
興味深いのは、Claude の解法が必ずしも人間の専門家と同じではないという点です。人間がアルゴリズムやデータベース検索で解く問題を、Claude が配列やパターンを「直感的に」認識して解くケースが複数確認されました。発表では、最初の真核生物プロモーターが TATA 配列を「目視」で発見されたという歴史的な事例になぞらえ、LLM が同種の直感的パターン認識を大規模に行える可能性を示唆しています。
ヒト困難問題:Claude Mythos Preview が30%を解く
専門家パネル5名が誰も解けなかった23問では、Claude Mythos Preview が約30%を正解しました(図2)。ヒトが解けない問題を AI が解くという結果は、AI が単に人間の知識を再現しているだけではないことを示す一例として注目されます。
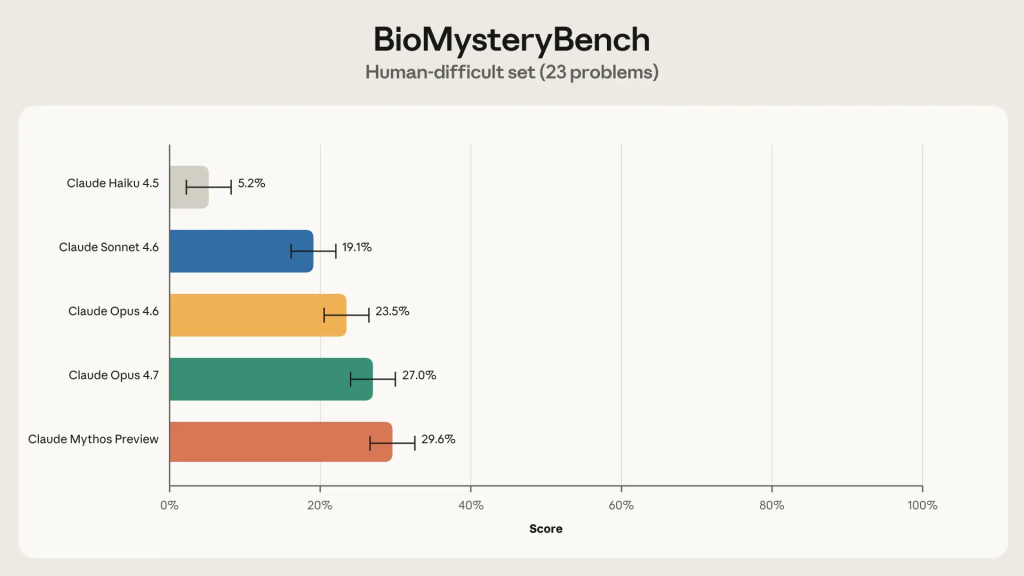
Anthropicのレポートによれば、ヒト困難問題で Claude が採用した主要な戦略は二つです。一つは 知識の広さを活かした直接解法 で、メタ分析や複数データベースの照合が必要な問題を、数十万本の論文から構築された内部知識を組み合わせて解くアプローチです。もう一つは 複数手法の収束による信頼性向上 で、単一の解法に確信が持てないとき、複数の異なるアプローチを試してその結果が収束する答えを採用するというものです。後者は人間の研究者も活用できる手法であり、発表の中でも「AIから学べる研究スタイル」として紹介されています。
一方で、内部知識の豊富さが逆に働いたケースも1件記録されています。「知らないことを知る」ことの難しさは、AI 研究能力の成熟度を測る重要な指標になりそうです。
信頼性の分析:「解ける」と「偶然解けた」は別物
Claude Mythos Preview 自身が行った追加分析(発表内で紹介)が、数値の裏側にある興味深い構造を明らかにしています。各問題を5回試行し、解けた回数を比較した結果、ヒト解決可能問題では強い二極化(ほぼ必ず解ける か 全く解けない か)が確認されました。一方、ヒト困難問題では中間的な頻度で正解するケースが増え、Sonnet 4.6 では「5回中1〜2回だけ正解」という脆弱な解き方が56%を占めました。
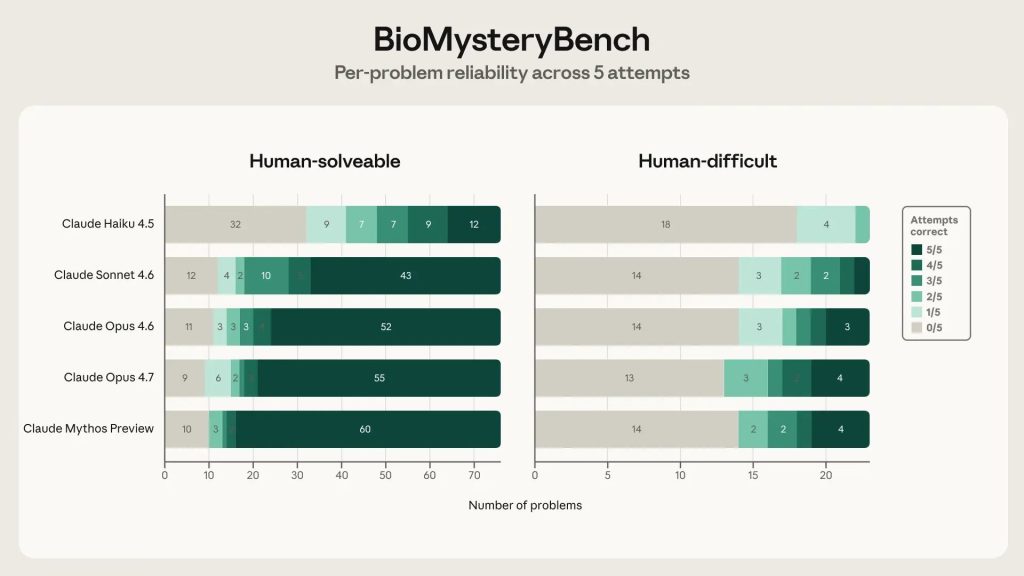
この分析は、精度の数値だけでは捉えられない「解答の質」に着目した点で意義深いと考えられます。科学研究に AI を活用する際には、正解率だけでなく再現性(信頼性)を評価基準に加えることが重要だと言えます。
第三者検証との一致
Anthropicによれば、論文の最終調整中に Genentech と Roche が独立して CompBioBench を公開し、同様の設計思想とほぼ同じ結論を示したことが確認されました。CompBioBench における Claude Opus 4.6 の成績は全体81%・難問69%で、BioMysteryBench の結果と整合しています。異なる研究グループが独自に開発したベンチマークで結果が収束したことは、この分野での AI の現在地を支持する根拠として重みがあると思います。
なお、BioMysteryBench にも未解決の問題が残っています。ヒトも AI も解けなかった問題については、問題自体の欠陥なのか本質的に難しいのかを完全には切り分けられません。Anthropicはこれを「限界」としながらも、より能力の高い将来のモデルが初めて解くかもしれない余地として前向きに捉えています。
Anthropicは2026年3月に科学研究に特化したブログを開設し、AI と科学の接点に関する情報発信を強化しています。今回の BioMysteryBench の結果もその流れの一部であり、生命科学分野での取り組みが継続していることがうかがえます。
まとめ
BioMysteryBench は、AIの科学的能力評価にまつわる本質的な難しさと正面から向き合った設計が印象的です。最新世代の Claude が専門家水準に達しつつある一方、難問での「信頼性のばらつき」という課題も浮き彫りになりました。AI を研究の実用ツールとして活用する際に、精度と再現性を両軸で評価する視点は今後ますます重要になると思います。