はじめに
マイクロソフトリサーチは2026年3月26日、家庭内タスクを通じてAIエージェントの「視覚に基づく計画適応能力」を評価する新たなベンチマーク「AsgardBench」を発表しました。本稿では、このベンチマークの設計思想、評価方法、そして複数の視覚対応モデルへの適用結果について解説します。
参考記事
- タイトル: AsgardBench: A benchmark for visually grounded interactive planning
- 著者: Andrea Tupini、Lars Liden、Reuben Tan、Yu Wang、Jianfeng Gao
- 発行元: Microsoft Research
- 発行日: 2026年3月26日
- URL: https://www.microsoft.com/en-us/research/blog/asgardbench-a-benchmark-for-visually-grounded-interactive-planning/
要点
- AsgardBenchは、AIエージェントが視覚情報をもとに計画を動的に修正する能力を独立して評価するベンチマークである
- AI2-THORシミュレーション環境上に構築され、12種類のタスクタイプにわたる108件の制御されたインスタンスで構成される
- 視覚入力の有無によって成功率に大きな差が生じ、多くのモデルで画像あり条件のほうが2倍以上の成功率を記録した
- 現在のエージェントに共通する課題として、微妙な視覚情報の識別困難・タスク進行状況の追跡不足・計画更新の遅れが明らかになった
- ベンチマークはオープンソースとしてGitHubで公開されている
詳細解説
AsgardBenchが生まれた背景
AIエージェントの性能評価において、従来のベンチマークの多くは知覚・ナビゲーション・物理的操作を同時に問うため、「視覚情報を計画に活かせているか」という点を切り離して測定することが難しいという課題がありました。
マイクロソフトリサーチはこの問題に着目し、AsgardBenchを開発しました。キッチンの掃除を担うロボットのような家庭内シナリオを舞台に、AIエージェントが環境を観察し、予期しない状況(例:洗うはずだったマグカップがすでに清潔だった場合)に応じて行動計画を修正できるかを直接評価します。知覚・判断・適応という能力のうち、特に「視覚に基づく適応」に焦点を当てた設計です。
ベンチマークの仕組み
AsgardBenchはAI2-THOR(家庭内タスクのトレーニング・評価に広く使われるインタラクティブな3Dシミュレーション環境)上に構築されています。エージェントはオブジェクトの近くに配置された状態から開始し、find(発見)・pickup(拾う)・put(置く)・clean(清潔にする)・toggle_on/off(オン/オフ切り替え)という固定されたアクションセットを使用します。
評価の流れは各ターンで完結します。エージェントはタスクを完了するための全ステップを提案しますが、実行されるのは最初の1ステップのみです。その後、新しい画像と「成功/失敗」という単純なシグナルが返ってきます。これにより、すべての行動を事前にスクリプト化することはできず、毎ステップ計画を再評価・修正することが求められます。ナビゲーションや視点の選択は評価対象外としているため、計画適応能力の測定に特化した構成と言えます。
12種類のタスクタイプにわたる108件のインスタンスでは、同じ指示であってもオブジェクトの位置や状態(清潔/汚れている、コーヒーが入っているかどうかなど)によって必要なアクションシーケンスが変わります。この設計により、環境の予測可能性を利用した「パターン暗記」的な解答を防ぐことができます。
評価結果
マイクロソフトリサーチによれば、複数の主要な視覚対応モデルをAsgardBenchでテストした結果、視覚入力が性能に大きく貢献することが確認されました。多くのモデルで、画像あり条件のほうがテキストのみの条件と比べて成功率が2倍以上に達したとのことです。
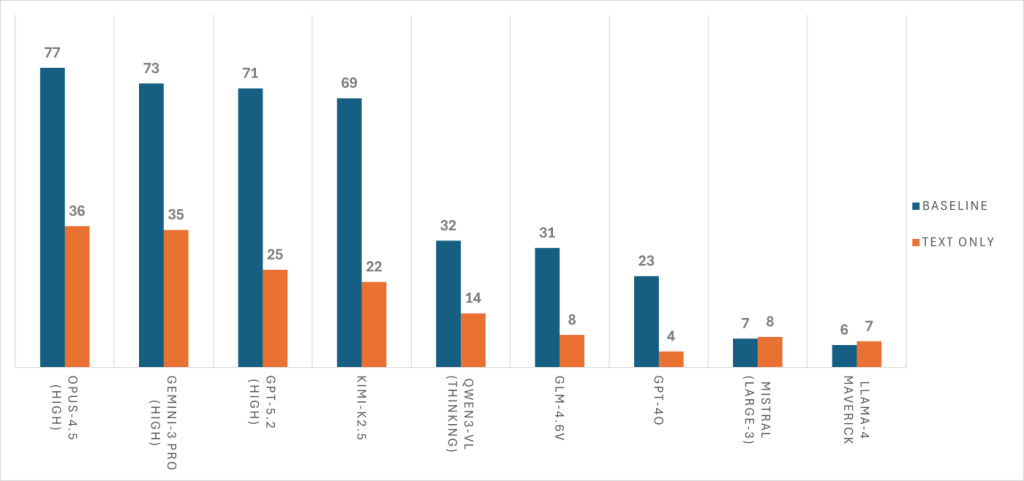
特に注目すべきは、テキストのみのエージェントに詳細な失敗情報を与えた場合でも、強力な視覚対応モデルの性能には及ばなかったという点です。詳細なテキストフィードバックは全モデルの性能を向上させますが、それでも視覚入力の優位性は保たれており、このベンチマークがテキスト情報だけでは代替できない視覚的な理解を必要としていることを示しています。
明らかになった3つの課題
テスト結果から、現在のエージェントが共通して抱える弱点が明確になりました。マイクロソフトリサーチの発表ではこれを3点に整理しています。
微妙な視覚情報の識別困難
散らかったシーンの中で、オン/オフや清潔/汚れているといった細かな状態の違いを正確に識別することが難しい傾向が確認されています。視覚的な情報量が多い場面では、重要な手がかりを見落としやすい傾向があると考えられます。
タスク進行状況の追跡不足
複数ステップにわたって自分がタスクのどの段階にいるかを正確に把握し続けることが難しく、結果として実行不可能なアクション(シンクにないマグカップを洗おうとするなど)を試みるケースが発生しました。
計画更新の遅れ
観察した内容を計画の修正にタイムリーに反映できず、古い情報に基づいたまま行動を続けるケースが見られました。いわば「見ているのに使えていない」状態と言えます。
これらの失敗パターンは、具身化AIエージェント(環境を認知して行動するAIシステム)が実世界で活用されるために越えるべき具体的な壁を示しており、次世代モデルの開発における重要な指針になると考えられます。
研究・開発ツールとしての活用
AsgardBenchはフィードバックの種類(なし・最小限・詳細)を変えることで、性能向上がどの能力(知覚・記憶・計画)に起因するかを切り分けられる診断ツールとしても機能します。単に「タスクが成功したか」だけでなく、「どの段階でどのように適応できたか」を詳細に分析できる点が特徴です。
今後の有望な研究方向として、強力な視覚理解と状態追跡を組み合わせたシステムの開発、タスク途中での計画修正を重視した学習アプローチ、そして適応の質を測る新たな評価指標の確立が挙げられています。ベンチマークはオープンソースとしてGitHubで公開されており、再現性のある研究基盤として広く活用できる形になっています。
まとめ
マイクロソフトリサーチが公開したAsgardBenchは、AIエージェントの「視覚に基づく計画適応能力」を独立して評価できる点で、これまでのベンチマークとは異なる視点を提供しています。視覚情報の活用と計画の動的修正というテーマは、実世界のロボットやAIエージェント開発において今後ますます重要になると考えられます。