はじめに
Microsoftリサーチがプリンストン大学およびバレンシア工科大学と共同で、2026年4月1日、AIモデルの性能を18の能力軸で測定・予測する評価手法「ADeLe」を発表しました。本稿では、この手法の仕組みと評価結果、今後の展望について解説します。
参考記事
- タイトル: ADeLe: Predicting and explaining AI performance across tasks
- 著者: Lexin Zhou、Xing Xie
- 発行元: Microsoft Research Blog
- 発行日: 2026年4月1日
- URL: https://www.microsoft.com/en-us/research/blog/adele-predicting-and-explaining-ai-performance-across-tasks/
要点
- ADeLe(AI Evaluation with Demand Levels)は、タスクとモデルの両方を18の能力軸(0〜5点)でスコアリングし、能力プロファイルを構築する評価手法である
- この能力プロファイルを用いることで、未知のタスクに対するモデルの性能をおよそ88%の精度で予測できることが示された
- GPT-4oやLLaMA-3.1-405Bなど15のLLMを評価した結果、既存の多くのベンチマークが測定対象の能力を正確に反映していない可能性が明らかになった
- OpenAIのo1やGPT-5などの推論特化モデルは論理・数学・社会的推論で向上が見られるが、タスクの難易度が上がるにつれて性能が低下する傾向がある
- 研究成果はNature誌に掲載され、GitHubを通じてベンチマークのアノテーションやリソースが公開されている
詳細解説
従来のAI評価が抱える課題
AIモデルの性能評価には、さまざまなベンチマーク(特定のタスク群に対する正解率を測るテスト)が広く使われています。しかし、Microsoft Researchの研究チームによれば、こうした既存ベンチマークの多くは、モデルが「なぜ」失敗したかを説明したり、未知のタスクでの挙動を予測したりする能力に乏しいと指摘されています。たとえば論理的推論を測るテストであっても、実際には専門知識やメタ認知(自分の思考を客観的に把握する能力)への依存度が高く、意図した能力だけを純粋に評価できていないケースが見られます。また、難易度のレンジが狭く、易しすぎるタスクしか含まないベンチマークも少なくありません。
AIモデルの評価手法は、モデルそのものの進化と並走して整備されてきた分野ですが、汎用的なモデルが増えるにつれ「特定タスクの正解率」だけでは全体像が見えにくくなってきていると考えられます。
ADeLe の仕組み——18の能力軸でタスクとモデルを共通の尺度で評価
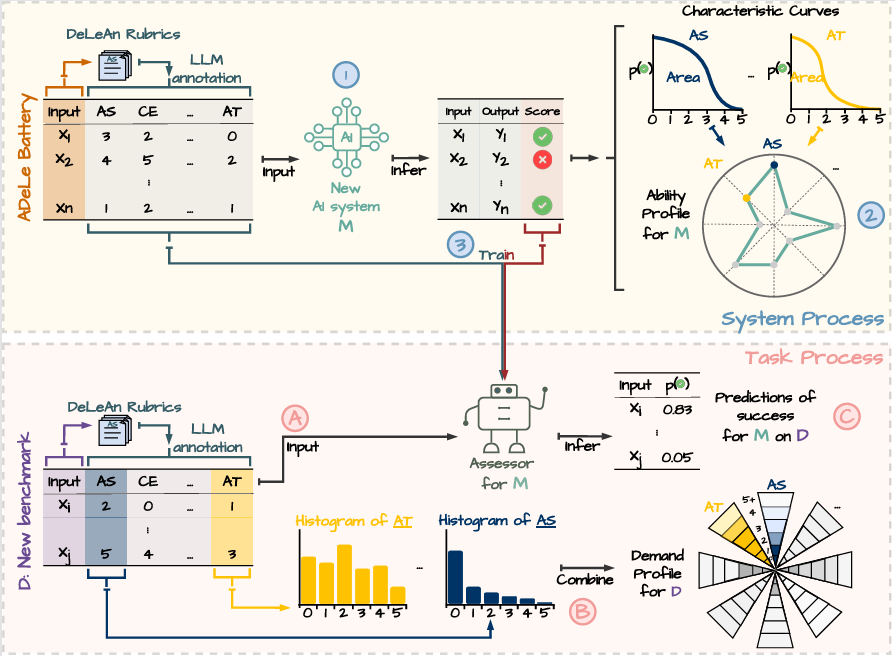
ADeLe(AI Evaluation with Demand Levels)は、タスクとモデルの双方を同じ18の能力軸——注意力、推論、ドメイン知識などを含む——で0〜5点のスケールでスコアリングする手法です。たとえば、基本的な算数問題は「量的推論」の要求度が低く、オリンピックレベルの証明問題は高いスコアになります。
モデルを多数のタスクで評価することで「能力プロファイル」が構築されます。各能力軸について、成功確率が50%となる難易度をモデルのスコアとして設定する方法が採用されています。このプロファイルと新たなタスクの要求プロファイルを照合することで、モデルがそのタスクで成功するかどうかを事前に推定できます。
この枠組みは、心理測定学(人間の認知能力を数値化する学問分野)の手法をAI評価に応用する試みとして位置づけられており、Microsoftが過去に取り組んできた関連研究の延長線上にあります。
15モデルの評価結果——「新しいモデルが全能力で優れているわけではない」
研究チームはGPT-4oやLLaMA-3.1-405BなどOpenAI、Meta、DeepSeekの合計15のLLMに対してADeLe評価を実施しました。その結果、新しいモデルは全体として旧モデルを上回るものの、能力によってはその差が一様ではないことが示されました。知識依存型のタスクではモデルのサイズと学習内容が性能を左右し、推論特化モデルは論理・抽象・社会的推論で明確な向上を示しました。
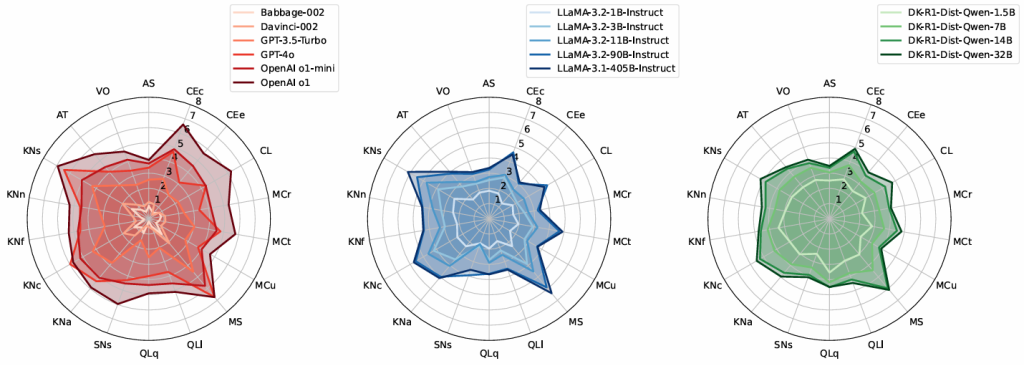
こうした傾向は、複数の異なるベンチマークを組み合わせて分析しても、タスクの要求度が統制されていなければ矛盾した結論が導かれる可能性があります。ADeLe は単一フレームワーク内でこれらのパターンを一貫して可視化できる点が特徴です。
なお、Microsoftによれば、未知タスクへの予測精度はGPT-4oとLLaMA-3.1-405Bで約88%を記録し、従来手法を上回りました。この数字は、能力プロファイルが単なる記述的な情報にとどまらず、実際の性能予測に活用できることを示していると考えられます。
「AIは推論できるか」という問いへの一つの回答
AIが本当に推論しているのかという議論は、研究コミュニティで長く続いています。ADeLe の分析によれば、この問いへの答えは「どの難易度のタスクを見るかによる」という形で整理できます。同じモデルが難易度の低いテストでは90%超の正解率を示し、難易度の高いテストでは15%未満に落ち込む事例も確認されており、これはモデルの能力が変わったのではなく、タスクの要求水準が異なることを反映しています。
また、o1やGPT-5のような推論特化モデルは、論理・数学のほか、ユーザーの意図を解釈する能力でも標準的なモデルを上回ることが示されました。一方で、タスクの要求難易度が上がるにつれて性能が低下する傾向も確認されており、「推論できる範囲に上限がある」という見方が支持される結果となっています。
今後の展開と活用可能性
ADeLe はマルチモーダルAI(テキストだけでなく画像・音声なども扱うモデル)や身体性AIへの拡張が想定されており、AI研究・政策立案・セキュリティ監査の共通フレームワークとして機能する可能性が示されています。研究チームはGitHubを通じてベンチマークのアノテーションやリソースを公開し、コミュニティ全体での取り組みへの展開を進めています。
企業や研究機関がAIモデルを導入・選定する際、「どのタスクで何が得意か」を事前に把握できる手段として実用的な意義があると考えられます。モデル比較の精度が上がることは、導入コストや失敗リスクの低減にもつながる可能性があります。
まとめ
MicrosoftリサーチらのチームがNature誌に発表したADeLeは、18の能力軸でAIモデルとタスクを共通の尺度で評価し、未知タスクへの性能を約88%の精度で予測できる手法です。既存ベンチマークの限界を可視化しつつ、より体系的なAI評価の基盤として、今後の研究や実務応用での活用が注目されます。