はじめに
Google Researchが2025年12月4日、AIモデルに長期記憶能力を与えるアーキテクチャ「Titans」と理論フレームワーク「MIRAS」について紹介しました。本稿では、この技術がどのようにRNNの速度とTransformerの精度を両立させ、200万トークンを超える超長文脈の処理を実現したのかを解説します。
参考記事
- タイトル: Titans + MIRAS: Helping AI have long-term memory
- 著者: Ali Behrouz, Meisam Razaviyayn, Vahab Mirrokni
- 発行元: Google Research Blog
- 発行日: 2025年12月4日
- URL: https://research.google/blog/titans-miras-helping-ai-have-long-term-memory/
要点
- TitansとMIRASは、AIモデルが実行中にコアメモリを更新することで、超長文脈を高速処理できる新しいアーキテクチャと理論フレームワークである
- Titansは深層ニューラルネットワークを長期記憶モジュールとして活用し、「サプライズメトリック」により重要な情報を選択的に記憶する
- BABILongベンチマークにおいて、Titansはパラメータ数がはるかに少ないにもかかわらずGPT-4を上回る性能を示し、200万トークン超の文脈処理が可能だった
- MIRASフレームワークは、メモリアーキテクチャ、注意バイアス、保持ゲート、メモリアルゴリズムの4つの設計選択によって、多様なシーケンスモデルを統一的に記述する
- YAAD、MONETA、MEMORAという3つのMIRAS変種モデルは、平均二乗誤差に依存しない新しい最適化手法を探求している
詳細解説
Transformerの限界と新しいアプローチの必要性
Transformerアーキテクチャは、注意機構(Attention)の導入によってシーケンスモデリングに革命をもたらしました。注意機構は、モデルが過去の入力を振り返り、関連性の高いデータを優先的に処理する仕組みです。しかし、シーケンス長が増加すると計算コストが劇的に増大するため、全文書理解やゲノム解析のような超長文脈へのスケーリングが困難になるという課題があります。
この課題に対し、研究コミュニティは線形RNN(Recurrent Neural Networks)やMamba-2のようなSSM(State Space Models)といった効率的なアプローチを探求してきました。これらのモデルは、文脈を固定サイズに圧縮することで高速な線形スケーリングを実現します。しかし、固定サイズの圧縮では、非常に長いシーケンスに含まれる豊富な情報を十分に捉えることができないという制約があります。
Titans:実行中に学習する長期記憶モジュール
Google Researchは、効果的な学習システムには、人間の脳における短期記憶と長期記憶の分離を反映した、異なりながらも相互接続されたメモリモジュールが必要だと説明しています。
Titansの革新的な点は、従来のRNNにおける固定サイズのベクトルやマトリクスメモリとは異なり、深層ニューラルネットワーク(具体的には多層パーセプトロン)を長期記憶モジュールとして採用したことです。この設計により、モデルは重要な文脈を失うことなく大量の情報を要約できる、はるかに高い表現力を獲得しています。
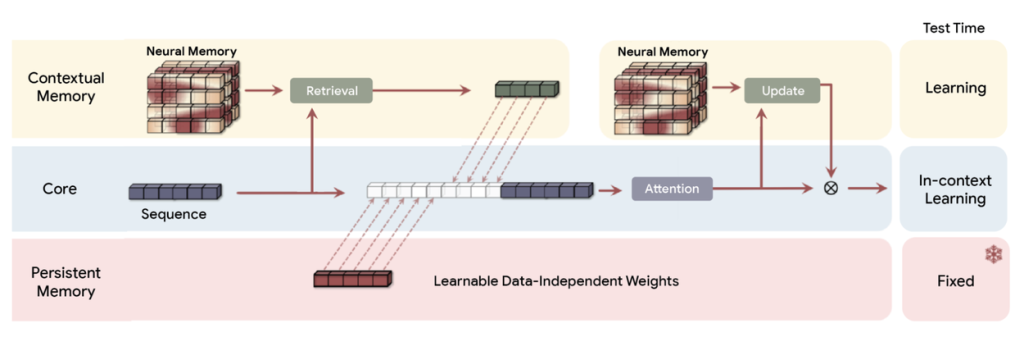
さらに重要なのは、Titansが単にデータを受動的に保存するのではなく、入力全体にわたってトークンを結びつける重要な関係性や概念的テーマを認識し保持する方法を能動的に学習する点です。この能力の核心にあるのが「サプライズメトリック(驚き指標)」と呼ばれる概念です。
人間の心理学では、日常的で予測可能な出来事は忘れやすい一方で、パターンを破る予想外の出来事や感情的な出来事は記憶に残りやすいことが知られています。Titansの文脈では、サプライズメトリックは、モデルが現在記憶している内容と新しい入力が示している内容との間の大きな差異を検出する仕組みとして機能します。
Google Researchの説明によれば、新しい単語が「猫」で、モデルのメモリ状態がすでに動物関連の単語を予測している場合、勾配(サプライズ)は低くなります。この場合、「猫」という単語を永続的な長期記憶に保存する必要はありません。一方、モデルのメモリ状態が真面目な財務報告を要約しているときに、新しい入力がバナナの皮の画像(予期しない出来事)である場合、勾配(サプライズ)は非常に高くなり、この新しい入力が重要または異常であることを示すシグナルとなります。
この内部エラー信号(勾配)を数学的に「これは予期しないことで重要だ!」という判断の等価物として使用することで、Titansアーキテクチャは最も新規性が高く文脈を破る情報のみで長期記憶を選択的に更新し、全体のプロセスを高速かつ効率的に保つことができます。
Titansは、この仕組みをさらに洗練させるために2つの重要な要素を組み込んでいます。第一に「モメンタム」です。モデルは「瞬間的なサプライズ」(現在の入力)と「過去のサプライズ」(最近の文脈の流れ)の両方を考慮します。これにより、個々のトークンが驚きを伴わない場合でも、関連する後続情報が確実に捕捉されます。第二に「忘却(重み減衰)」です。非常に長いシーケンスを扱う際のメモリの有限容量を管理するため、Titansは適応的な重み減衰メカニズムを採用しています。これは忘却ゲートとして機能し、モデルがもはや必要でない情報を破棄できるようにします。
MIRAS:シーケンスモデリングの統一的視点
MIRASフレームワークは、最新のTransformerから高速な線形RNNに至るまで、シーケンスモデリングにおけるすべての主要なブレークスルーが、本質的には同じもの、つまり高度に複雑な連想記憶(Associative Memory)モジュールであるという洞察に基づいています。
連想記憶とは、キーと値のペアを記憶し、与えられたキーに対応する値を効率的に検索できるメモリシステムです。コンピュータサイエンスでは、ハッシュテーブルやキャッシュメモリなどがこの概念の例として知られています。
MIRASが独自かつ実用的である理由は、AIモデリングを見る視点にあります。多様なアーキテクチャを別々のものとして見るのではなく、同じ問題を解決する異なる方法、つまり本質的な概念を忘れさせずに新しい情報と古い記憶を効率的に組み合わせる方法として捉えます。
MIRASは、4つの重要な設計選択によってシーケンスモデルを定義します。
第一に「メモリアーキテクチャ」は、情報を保存する構造(例:ベクトル、マトリクス、またはTitansのような深層多層パーセプトロン)です。
第二に「注意バイアス」は、モデルが最適化する内部学習目標であり、何を優先するかを決定します。
第三に「保持ゲート」は、メモリ正則化です。MIRASは「忘却メカニズム」を、過去の知識の保持と新しい学習のバランスをとる特定の形式の正則化として再解釈します。正則化とは、機械学習において過学習を防ぐための技術で、モデルが訓練データに過度に適合しすぎないようにする仕組みです。
第四に「メモリアルゴリズム」は、メモリを更新するために使用される最適化アルゴリズムです。
平均二乗誤差パラダイムの超越
従来、ほぼすべての成功したシーケンスモデルは、バイアスと保持の両方において平均二乗誤差(MSE)またはドット積類似度に依存してきました。平均二乗誤差とは、予測値と実際の値の差の二乗の平均を取る誤差指標で、機械学習で広く使われています。しかし、この依存性により、モデルは外れ値に敏感になり、表現力が制限される可能性があります。
MIRASは、最適化と統計学の文献に基づいたより豊かな設計空間を探索するための生成的フレームワークを提供することで、この制約を超越します。これにより、非ユークリッド目標と正則化を持つ新しいアーキテクチャの作成が可能になります。
Google Researchは、MIRASを使用して3つの特定の注意機構フリーモデルを作成しました。第一に「YAAD」は、大きなエラーや外れ値(大きな文書内の単一のタイプミスなど)に対して敏感になりにくいように設計されています。誤りに対してより穏やかな数学的ペナルティ(Huber損失)を使用することで、一時的な問題に過剰反応しないようにしています。Huber損失とは、小さな誤差には二乗誤差、大きな誤差には絶対誤差を使用するハイブリッド損失関数で、外れ値への頑健性が高いとされています。これにより、入力データが乱雑または不整合な場合でも、モデルがより堅牢になります。
第二に「MONETA」は、より複雑で厳格な数学的ペナルティ(一般化ノルムと呼ばれる)の使用を探求します。モデルが注意を払うものと忘れるものの両方に対してこれらのより規律的なルールを使用することが、全体的により強力で安定した長期記憶システムにつながるかどうかを調査しています。第三に「MEMORA」は、メモリを厳密な確率マップのように動作させることを強制することで、最良の記憶安定性を達成することに焦点を当てています。この制約を使用することで、メモリ状態が更新されるたびに、変更が制御されバランスが取れることを保証し、新しい情報を統合するためのクリーンで安定したプロセスを保証します。
実験結果と性能評価
Google Researchは、TitansとMIRAS変種(YAAD、MONETA、MEMORA)を、Transformer++、Mamba-2、Gated DeltaNetなどの主要なアーキテクチャと厳密に比較しました。さらに、ゲノムモデリング(DNA)と時系列予測でTitansをテストすることで、アーキテクチャがテキストを超えて効果的に一般化することを検証しています。
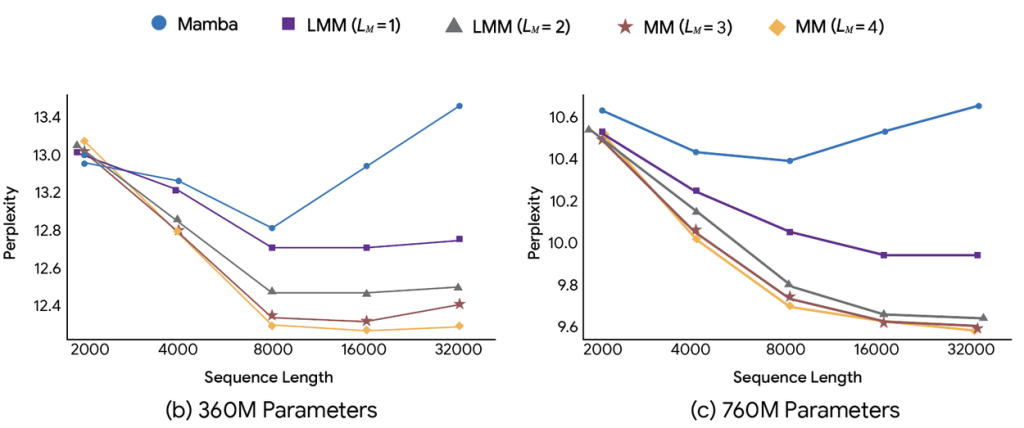
標準的な言語モデリングデータセット(C4、WikiText)とゼロショット推論タスク(HellaSwag、PIQA)の両方において、これらのモデルは一貫してより高い精度とパープレキシティを示しました。パープレキシティとは、言語モデルがテキストの断片を見たときにどれだけ驚くかを測定する指標で、値が低いほどモデルの予測精度が高いことを示します。
アブレーション研究により、メモリアーキテクチャの深さが重要であることが明らかになりました。同じサイズでも深さが異なる長期記憶モジュールを比較すると、より深いメモリを持つモジュールは言語モデリングにおいて一貫して低いパープレキシティを達成します。さらに、シーケンス長が大幅に増加しても性能を維持する、より優れたスケーリング特性を示しています。
言語モデリングと常識推論タスクにおいて、Titansアーキテクチャは、同等サイズの最先端線形再帰モデル(Mamba-2やGated DeltaNetなど)およびTransformer++ベースラインを上回る性能を示しました。新しいMIRAS変種(MONETA、YAAD、MEMORA)も、これらのベースラインと比較して改善された性能を達成し、堅牢で非MSE最適化メカニズムを探求する利点を検証しています。重要なことに、これらのモデルは効率的で並列化可能なトレーニングと高速な線形推論速度を維持しています。
超長文脈リコールにおける優位性
これらの新しいアーキテクチャの最も重要な利点は、極めて長い文脈を処理する能力です。これは、非常に長い文書に分散した事実をまたいで推論を必要とするタスクであるBABILongベンチマークで強調されています。この挑戦的な設定において、Google Researchによれば、Titansははるかに少ないパラメータ数にもかかわらず、GPT-4を含むすべてのベースラインを上回る性能を示しました。さらにTitansは、200万トークンを超える文脈ウィンドウサイズに効果的にスケールする能力を実証しています。
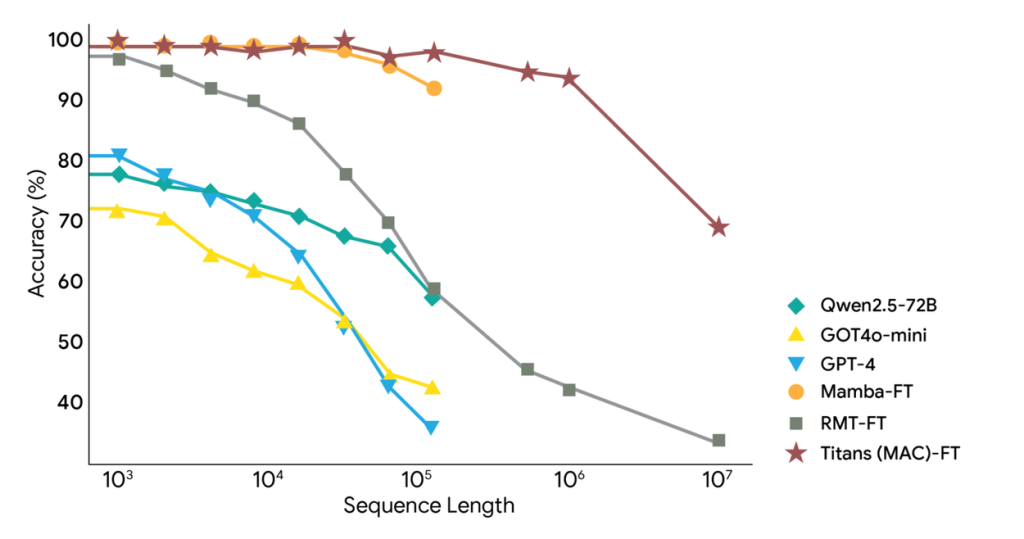
200万トークンという規模は、一般的な小説が約10万トークン程度であることを考えると、約20冊分の小説に相当する膨大な文脈を一度に処理できることを意味します。これは、長大な法律文書や医学文献、大規模なコードベース全体の理解など、実用的な応用の可能性を大きく広げると考えられます。
まとめ
TitansとMIRASフレームワークの導入は、シーケンスモデリングにおける重要な進歩を示しています。データが入力される際に記憶する方法を学習する深層ニューラルネットワークをメモリモジュールとして採用することで、これらのアプローチは固定サイズの再帰状態の限界を克服しました。さらに、MIRASはオンライン最適化、連想記憶、アーキテクチャ設計の間の関連性を明らかにする、強力な理論的統一を提供しています。標準的なユークリッドパラダイムを超えることで、この研究は、RNNの効率性と長文脈AI時代に必要な表現力を組み合わせた新世代のシーケンスモデルへの扉を開くと考えられます。