はじめに
Google Researchが2026年1月23日、機械学習における大規模データセットからの効率的なサンプリング手法「GIST(Greedy Independent Set Thresholding)」を発表しました。本稿では、データの多様性と有用性を数学的に保証しながら両立させるこの新しいアルゴリズムについて、その仕組みと実用性を解説します。
参考記事
- タイトル: Introducing GIST: The next stage in smart sampling
- 著者: Morteza Zadimoghaddam and Matthew Fahrbach, Research Scientists
- 発行元: Google Research Blog
- 発行日: 2026年1月23日
- URL: https://research.google/blog/introducing-gist-the-next-stage-in-smart-sampling/
要点
- GISTは、データの多様性(redundancy回避)と有用性(情報価値の最大化)という相反する2つの目標を同時に満たすサブセット選択アルゴリズムである
- 最適解の少なくとも50%の価値を持つデータサブセットを見つけることを数学的に保証しており、0.56を超える近似比を達成することはNP困難であることも証明されている
- ImageNetを用いた画像分類タスクにおいて、既存手法(Random、Margin、k-centerなど)を上回る精度を達成した
- データ選択にかかる実行時間は、モデル訓練時間と比較して無視できるほど高速である
詳細解説
現代の機械学習が直面するデータ規模の課題
Googleによれば、大規模言語モデル(LLM)からコンピュータビジョンシステムまで、現代の機械学習は膨大で複雑なデータセットを処理する必要があり、そのコストが課題となっています。この状況では、全データセットから代表的な小規模サブセットを選択する「サブセット選択」が不可欠です。
ここで重要な問いは、選択したサブセットに正確なモデルを訓練するのに十分な情報が含まれているかをどう保証するか、という点です。従来の機械学習では、ファインチューニングではなく通常の訓練タスクにおいて、この問題が特に顕著になります。
データ選択における根本的な矛盾
Googleの研究によれば、サブセット選択では「多様性(diversity)」と「有用性(utility)」という相反する2つの目標のバランスが求められます。
多様性については、選択されたデータポイント間の最小距離(通常は埋め込み空間での距離)を最大化する「max-min diversity」という指標が用いられます。この指標は、類似したデータポイント(例えば、ほぼ同一のゴールデンレトリーバーの写真2枚)を選択すると多様性が低くなり、できるだけ離れたポイントを選択することで冗長性を最小化し、データ空間の広範なカバレッジを確保します。
max-min diversityは、データセット全体の「偏りのない代表性」を測る古典的な指標として、クラスタリングや情報検索の分野で長く用いられてきました。一方、有用性については、単調劣モジュラ関数(monotone submodular functions)というクラスの関数が使用され、サブセットによってカバーされる総合的なユニーク情報を最大化します。
劣モジュラ関数は「収穫逓減の法則」を数学的に表現したもので、新しい要素を追加するたびに得られる情報の増分が減少していく性質を持ちます。この性質により、情報の重複を自然に抑制しながら、全体として最も価値の高いサブセットを効率的に見つけることができると考えられます。
問題の難しさは、これら2つの目標を組み合わせる点にあります。純粋なmax-min戦略では多様だが無関係なデータポイントを選択する可能性があり、純粋な有用性戦略では密集した冗長なポイント群を選択する可能性があります。Googleは、最大限に分散していて、かつ最大限に情報量が多いサブセットを見つけることは、NP困難(NP-hard)として知られる複雑な組合せ最適化問題であり、特に大規模データセットでは効率的に最良の解を見つけるアルゴリズムは存在しないと説明しています。
NP困難問題は、理論計算機科学において「現実的な時間内に厳密な最適解を見つけることが極めて困難」とされる問題のクラスです。巡回セールスマン問題やナップサック問題などが代表例で、データ規模が大きくなると計算量が指数関数的に増加するため、実用的には近似アルゴリズムの開発が必要となります。
GISTの動作原理
完璧なサブセットを見つけることは非現実的であるため、目標は証明可能な近似保証を持つアルゴリズムの発見に移ります。これは、解が常に真の最適解に近いことを保証する数学的な安全網です。Googleによれば、GISTはこの点で画期的な解決策を提供しています。
GISTは、多様性と有用性の課題を一連のより単純だが関連する最適化問題に分解します。
多様性成分のしきい値化
GISTはまず、多様性成分を一時的に分離します。すべてのポイント間の最小距離を最大化しようとする代わりに、「ある固定された最小距離に対して、選択できる最良のデータサブセットは何か」というより単純な問いに取り組みます。
最小必要距離を固定することで、GISTはグラフを使用してデータを処理します。このグラフでは、2つのポイントは、それらの距離が指定された距離よりも小さい場合にのみ接続されます。このグラフにおいて、接続された2つのポイントは、最終的なサブセットに含めるには類似しすぎていると見なされます。
グラフ理論を用いた距離のモデル化は、データポイント間の「近接関係」を視覚的かつ計算可能な構造として表現する手法です。各データポイントをノード(頂点)として、指定された距離以内のポイント同士をエッジ(辺)で結ぶことで、「どのポイントとどのポイントが近すぎるか」という制約を明示的に表現できます。
独立集合の近似
Googleの説明によれば、GISTはこのグラフにおいて、2つのポイントが接続されていない最大有用性サブセットを探します。これは古典的な最大独立集合(maximum independent set)問題です。
この問題は、特定のゲスト同士が同席できないディナーパーティーで、最も興味深いグループを招待する状況に例えられます。1人のゲストを選ぶと他の3人の高関心ゲストを「ブロック」する可能性があるため、最良の組み合わせを見つけるには指数関数的な数の組み合わせをチェックする必要があり、これが計算上最も困難な問題の1つとされる理由です。
最大独立集合問題自体がNP完全(効率的に完璧な答えを見つけるアルゴリズムは広く存在しないと信じられており、合理的な近似アルゴリズムも許容しない)であるため、GISTは慎重に構築された双基準貪欲アルゴリズム(bicriteria greedy algorithm)を使用して効率的に解を近似します。
双基準貪欲アルゴリズムは、「2つの基準を同時に考慮しながら段階的に最良の選択を行う」手法です。GISTの場合、「データの価値(有用性)」と「データ間の距離(多様性)」という2つの基準を同時に評価しながら、各ステップで最も有望なデータポイントを選択していきます。この手法により、複雑な最適化問題を実用的な時間内で解くことが可能になると考えられます。
GISTは多くの可能な距離しきい値を反復処理し、対応する独立集合問題を解き、最終的にすべてのしきい値にわたって見つかった最良の解を選択します。Googleによれば、最適解によって達成される任意の最小距離dに対して、GISTは距離しきい値d/2で最適有用性に匹敵する有用性を達成します。
双基準貪欲アルゴリズムは、データの多様性と価値の適切なバランスを見つける体系的な「調整ノブ」のように機能します。推測する代わりに、すべてのデータポイント間の実際の距離を分析して、潜在的な間隔ルールのリストを作成し、それらのルールを1つずつテストします。各ルールについて、既に選択したポイントに近すぎないという条件のもとで、見つけられる最も価値の高いポイントを「貪欲に」取得します。このプロセスをすべての関連距離にわたって実行し、結果を比較することで、最も有用な情報を捕捉しながらデータができるだけ分散している特定の「スイートスポット」を特定します。
これらの最大独立集合問題を巧みに近似することで、GISTは最小多様性要件を尊重しながら有用性目標を満たすことができます。
実証結果
強力な理論的保証
Googleによれば、最も重要な発見は理論的結果です。GISTは、この多様性と有用性のトレードオフに対して強力で証明可能な保証を提供する最初のアルゴリズムです。GISTアルゴリズムは、その価値が絶対最適解の価値の少なくとも半分であるデータサブセットを見つけることが保証されています。
この強力な保証は、実務者に必要な数学的安全網を提供し、アルゴリズムが有用性の最大化と多様化の確保の間で効率的なトレードオフを行っていることを保証します。さらに、Googleは、最適値の0.56以上の割合を持つサブセットを見つけることはNP困難であることも証明しています。
近似比0.5という数値は、「最悪の場合でも最適解の半分以上の性能を保証する」ことを意味します。これは近似アルゴリズムの分野では非常に強力な結果であり、さらに0.56を超える近似比の達成が理論的に不可能であることが証明されているため、GISTの0.5という保証は理論的限界に極めて近い水準と言えます。
実世界での影響
Googleは、多様性と有用性の両方が不可欠なシナリオに焦点を当て、さまざまな機械学習アプリケーションにおける最先端のベンチマークに対してGISTを評価しました。
比較対象となった手法は以下の通りです:
- Random: 多くの設定で多様性を促進し、良好な解を提供するシンプルで軽量なアプローチ
- Margin: モデルが現在「不確実」なデータポイントを選択するが、多様な訓練例のセットを出力するインセンティブはない
- k-center: 元の大規模データセット内のすべてのポイントが選択された代表の1つにできるだけ「近く」なるようにデータポイントのサブセットを選択する。最も重要または興味深いポイントを探すのではなく、「盲点」の排除を試みる
- Submod: 「重要な」ポイント(有用性)を選択しながら、それらが「類似しすぎ」ない(多様性)ようにする。ただし、データセットが大きくなると一貫性がなくなる可能性がある、やや古い数学的な多様性の定義方法を使用
Googleはさらに、GISTを他の戦略と組み合わせて改善できるかを検証しました:
- GIST-margin: 「難しいケースを選ぶ」戦略を取り、GISTの厳格な多様性ルールに従わせる。「最も混乱する例を選ぶが、互いに類似しすぎている2つの混乱する例を選ぶことは禁止する」というアプローチ
- GIST-submod: SubmodがGISTフレームワークを使用して、元のSubmodアプローチよりも厳密に多様性部分を処理
画像分類のためのデータサンプリング
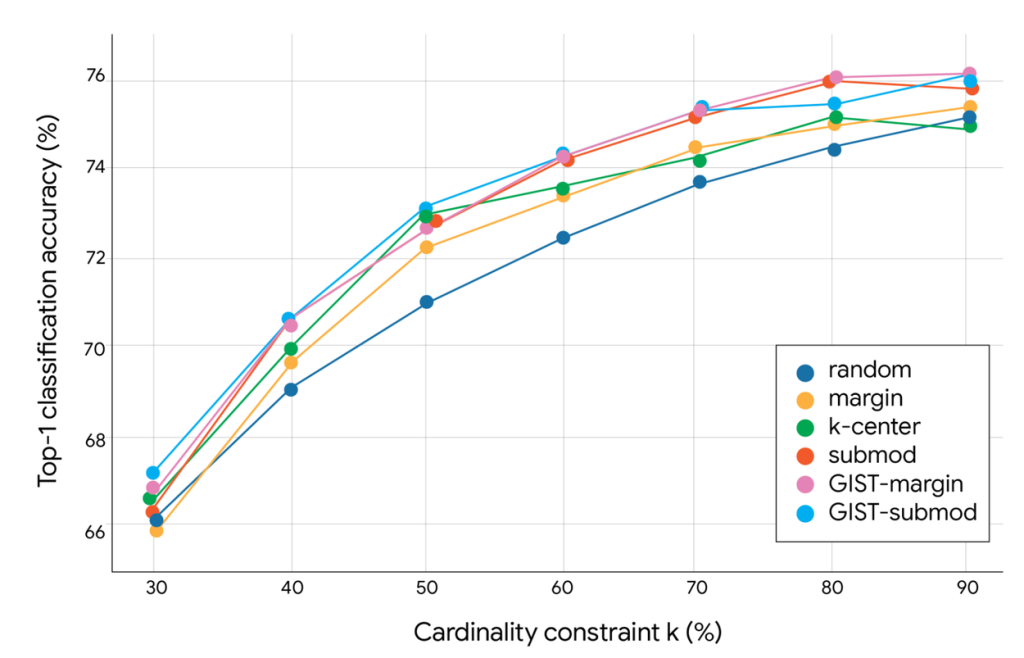
ImageNetなどのデータセットでResNet-56モデルを使用した実験において、GISTはシングルショットサブセット選択で顕著な利点を示しました。
シングルショットデータダウンサンプリングは、重要な情報を保持しながら、データセット(通常は画像、信号、または高次元データ)の量を1ステップで削減する手法です。反復的または多段階プロセスとは異なり、このアプローチは速度と効率を最大化し、計算負荷を減らすため、またはグラフィックス関連タスクでレンダリングパフォーマンスを最適化するためによく使用されます。
Googleの実験結果によれば、GISTは異なるシングルショットデータダウンサンプリングアルゴリズムに対して、ImageNetでより高いTop-1分類精度を達成しました。カーディナリティ制約は選択されるアイテムの数を制限します。例えば、130万枚の画像のプールがある場合、カーディナリティ制約10%(k=10%)は、アルゴリズムがモデルを訓練するために13万枚以上の画像を選択することが厳密に禁止されることを意味します。
Top-1分類精度は、モデルの最も確信度の高い予測(トップ1の予測)が正解と一致する割合を示す指標です。画像分類タスクでは、モデルが「これはゴールデンレトリーバーだ」と最も強く予測した場合に、それが実際に正解である確率を測定します。この指標が高いほど、モデルの判断精度が高いことを示します。
これは、コストのかかるモデル訓練を開始する前に、最も情報量が多く多様な画像を一度選択する必要があるデータ集約的なタスクにとって重要です。GISTは、以前の方法と比較してより高いモデル精度につながるサブセットを一貫して選択し、カバレッジと非冗長性のバランスを取る能力の向上を証明しました。
実行時間
基礎となる問題の複雑さにもかかわらず、GISTの実際のサブセット選択ステップは非常に高速です。Googleによれば、その実行時間は、最終的な機械学習モデルの訓練に必要な数時間または数日と比較して、しばしば無視できるほどです。この速度により、GISTは数十億のデータポイントを持つ大規模訓練パイプラインへの統合が実用的になります。
また、Googleは、YouTubeホームランキングチームでmax-min多様性アプローチの価値を観察し、同様の原理を採用してビデオ推奨の多様性を高め、その結果、長期的なユーザー価値が向上したと報告しています。
YouTubeのような推薦システムでは、ユーザーに似たようなコンテンツばかりを提示すると短期的には満足度が高くても、長期的には飽きられて離脱につながる可能性があります。max-min多様性の原理を適用することで、ユーザーの興味に関連しつつも多様なコンテンツを推薦でき、これが長期的なエンゲージメント向上に寄与したと考えられます。
まとめ
総合的な有用性の最大化と最大多様性の維持という競合する最適化目標を組み合わせる課題は、計算科学における長年の障壁でした。GISTアルゴリズムは、単一の高効率フレームワークを提供することで、データ選択におけるこの根本的なトレードオフを成功裏に解決しています。GoogleがNeurIPS 2025で発表したこの研究は、データが成長し続ける中でも、最大限に情報量が多く、最小限に冗長なサブセットでモデルを訓練できることを保証する、証明可能に効果的なツールを機械学習コミュニティに提供しています。