はじめに
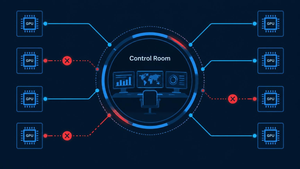
OpenAIが、研究用AIの処理を一元管理するシステム「Control Room」を発表しました。研究基盤で動くモデルの処理を追跡し、停止の判断から最大35秒で出力を止めます。ここでは、その構成と停止までの流れ、障害時にも止まる設計を解説します。
参考記事
- タイトル: Control Room: A central system to track and stop model workloads across our research infrastructure
- 発行元: OpenAI
- URL: https://openai.com/index/control-room
要点
- OpenAIは研究基盤上のモデル処理を追跡・停止する中央システム「Control Room」を構築し、研究基盤全体に導入済みである
- 停止の判断から最大35秒でモデルの出力が止まる。遅延は推論の認可に使うキャッシュ層に由来し、ゼロへ近づける取り組みが進行中である
- 停止の判定は研究者のコードではなく推論エンジン側で、推論リクエストごとに行われる
- Control Room自体が停止すると全推論を拒否する「フェイルクローズ」設計で、最前線モデルの研究ワークロードには導入済みである
詳細解説
Control Roomの概要
OpenAIによると、モデルの性能が上がるほど、安全性やセキュリティ上のリスクも大きくなります。そのため、問題を早く見つけ、必要ならモデルをすぐ止められることが重要になっています。この課題に対応するため、同社はControl Roomを構築しました。
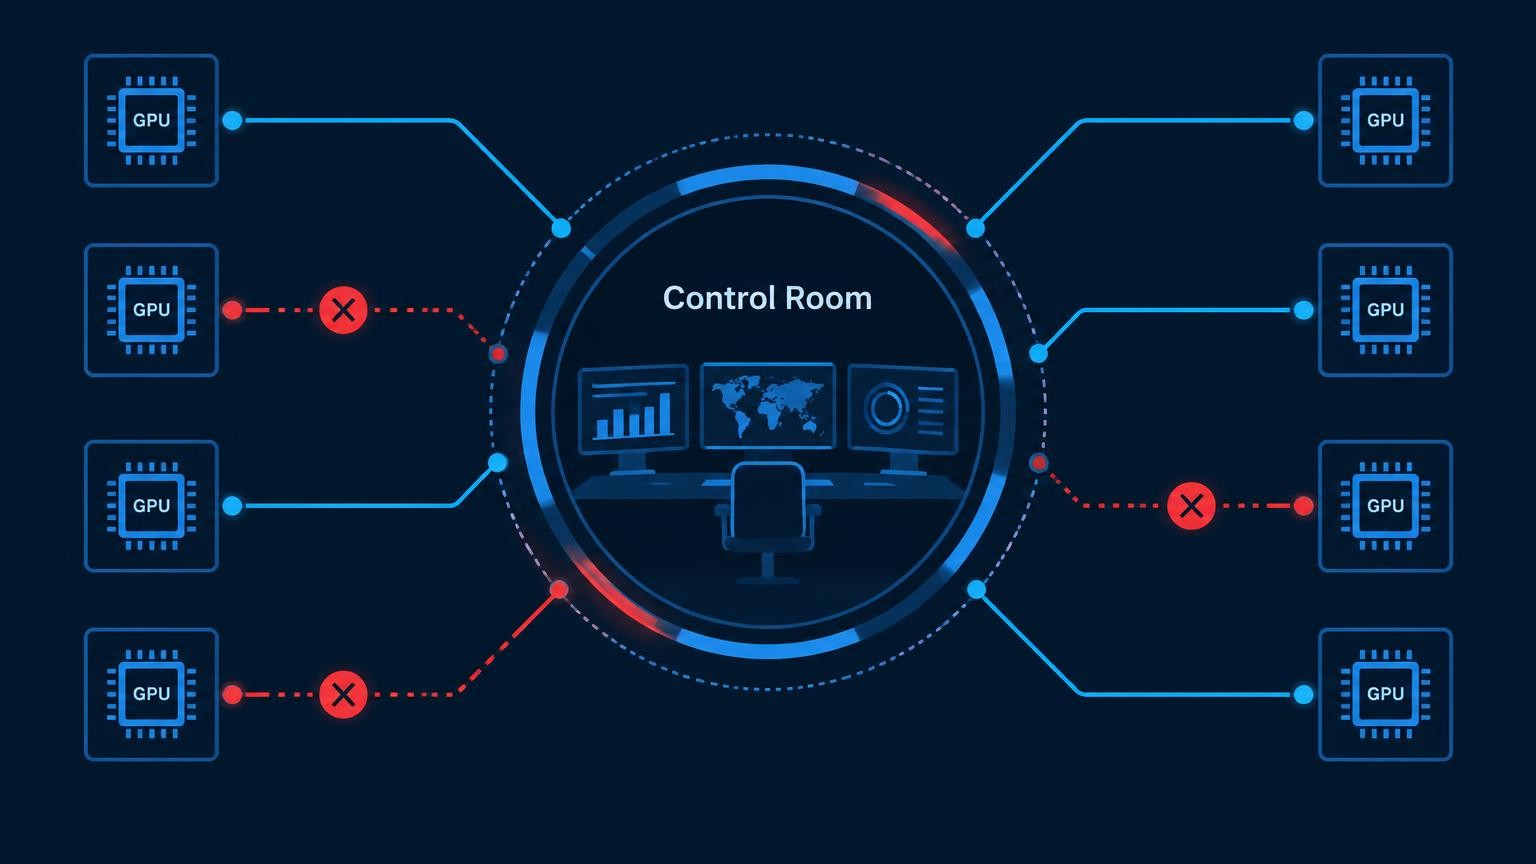
Control Roomは、研究基盤上のモデル処理(ワークロード)を追跡する中央システムです。安全性やセキュリティの懸念が生じたときに、処理を素早く止めます。対象は研究用のあらゆる推論ワークロードです。訓練や評価のためのエージェント的なサンプリング、データ処理なども含まれます。
同社のミスアラインメント監視システムと連携して動きます。停止や一時停止の判断から35秒以内に、モデルの出力を止めます。ほかのシステムが故障しても動き続けるように作られています。Control Room自体が落ちた場合も、モデルの出力は止まります。
推論(inference)は、学習済みモデルに入力を与えて出力を生成する処理です。サンプリングは、モデルに出力のトークンを生成させることを指します。ミスアラインメントは、AIの振る舞いが開発者の意図や安全上の方針からずれる状態です。
何が変わるのか:対象範囲と利用者への影響
Control Roomは、研究基盤全体にすでに導入されています。OpenAIは、必要性が最も高いのが研究基盤だと説明しています。一方、外部向けのモデル提供基盤は、もともと集中管理の度合いが高い構成です。必要に応じてモデルの提供を素早く止める運用体制も、すでに整っているとしています。
つまり、ChatGPTやAPIの利用者が操作する新機能ではありません。利用者側で設定や申し込みが必要なものでもありません。変わるのは、OpenAIの研究現場でモデルを止める手段の確実さです。
研究段階のモデルは、公開前に強化学習や評価を大量に回す段階にあります。Control Roomは、将来公開されるモデルの安全性を開発工程の側で支える仕組みと言えます。
3つの構成要素と連携の仕組み
Control Roomは、次の3つの仕組みを組み合わせて動きます。
- ワークロード(ジョブ):実行中の処理そのものです。強化学習の実験、評価、大量のサンプリングやデータ処理などが該当します。エージェント的な推論を行う研究ワークロードは、すべて承認済みの「セーフティケース」との紐づけが必須です。
- 推論エンジン:モデル本体で、GPU上で直接動く「頭脳」にあたります。1つのワークロードが複数のモデルやエンジンを使うことがあります。同じエンジンを複数のワークロードが共有することもあります。
- Control Roomサービス:ジョブを追跡し、モデル出力の生成を続けてよいかを管理します。エンジンはリクエストに応える前にこのサービスへ確認し、停止済みのジョブなら拒否されます。
セーフティケース(safety case)は、システムが特定の用途で十分に安全だと示すための、根拠を伴う論証です。航空や原子力などの安全工学で使われてきた考え方です。Control Roomでは、ジョブを始める時点でこの承認が前提になります。
各要素の連携は次のとおりです。
- 新しいジョブを始めるとき、ワークロードのコードがControl Roomに新しいjob_idを要求します。
- モデルからトークンを生成させたいとき、ワークロードはjob_idを付けて推論エンジンにリクエストします。エンジンは同じjob_idを渡して、Control Roomに処理の許可を求めます。
- Control Roomはそのジョブが停止済みかを確認し、停止済みなら推論リクエストを拒否します。エンジンはワークロードに拒否を返し、以後そのジョブの出力は生成されません。
job_idは、ジョブと推論リクエストを結ぶ鍵の役割を果たしています。止めたいジョブのIDを停止済みにするだけで、どのエンジンを使っていても出力を止められます。
ジョブの開始から停止までの流れ
OpenAIは、ジョブの開始から停止までを13の段階で説明しています。ここでは例として、「job_042」というIDが割り当てられるジョブを想定します。開始直後のジョブにはまだIDがなく、登録を経てIDを受け取ります。Control Room側では、job_039〜job_041のような他のジョブも同時に動いています。
- 研究者がジョブの開始を決める:実験や評価など、研究者がジョブを立ち上げるところから始まります。
- ジョブが起動する:ジョブのコード(ワークロードのコード)は研究者が所有し、実行します。推論エンジンは、ジョブの一部として起動する場合があります。特定のジョブに属さない独立したエンジンが、すでに動いている場合もあります。
- ジョブがControl Roomに登録する:ワークロードのコードがジョブIDを要求し、ジョブを承認済みのセーフティケースと紐づけます。この要求はジョブ自身が行います。
- Control RoomがジョブIDを返す:Control Roomはジョブを記録し、その識別子を返します。ワークロードは以後の推論リクエストに同じIDを付けます。
- ジョブが推論エンジンに出力を要求する:リクエストにはjob_idが含まれます。この要求はワークロードから直接送られ、Control Roomを経由しません。
- エンジンが許可を確認する:リクエストに応える前に、エンジンはControl Roomに問い合わせます。このジョブがまだ実行を認められているかを確かめるためです。
- Control Roomが許可する:ジョブはまだ認可されているため、Control Roomは許可を返します。エンジンはリクエストを処理できます。
- エンジンが出力を返す:モデルが応答を生成し、エンジンが研究ジョブに返します。ジョブはその出力を使って作業を続けます。
- ジョブを止める判断が下される:人または監視システムが、Control Roomにこのジョブの停止を指示します。Control RoomはIDを停止済みにしますが、ワークロードのコードは動き続けます。
- ジョブはなおも出力を求めることがある:OpenAIは、ジョブがまだ実行中かどうかの確認を、ワークロードのコードに頼っていません。コードが正しく確認する前提に立たない設計です。
- エンジンが再び許可を確認する:新しい推論リクエストについても、エンジンは同じジョブIDを渡してControl Roomに許可を求めます。
- 次の認可が拒否される:停止済みのジョブなので、Control Roomは許可を拒否します。エンジンはその推論リクエストを断らなければなりません。
- 出力は止まり、ジョブは残る:エンジンは出力の代わりに拒否を返します。研究用のプロセスは生きたままの場合があり、エンジンもほかの認可済みジョブには引き続き使えます。
この流れの特徴は、停止がプロセスの強制終了ではなく、出力の遮断として実装されている点です。出力のやり取り自体はControl Roomを通らず、Control Roomが担うのは許可の判定だけです。共有エンジンを止めずに済むため、他のジョブへの影響も抑えられます。ジョブの状態が残るので、後から原因を調べやすい面もあるとみられます。
監視アラートと連動した停止
OpenAIによると、最前線の強化学習ジョブはすべて「モニター」付きで実行されています。モニターは、訓練中のモデルの行動をすべて点検する別のモデルです。問題を検知すると警告を出します。最近起きたDNS関連のインシデントも、モニターが検知した事例です。
監視システムとControl Roomの連携は次のとおりです。
- 監視システムが問題の可能性を検知すると、内容や深刻度に応じてジョブを止めるかを判断します。
- 止める場合、監視システムはjob_idを付けてControl Roomに停止のメッセージを送ります。Control Roomはそのジョブを停止済みとして記録します。
- 以後、そのjob_idのジョブが、どのエンジン上のどのモデルにトークン生成を求めても拒否され、出力が止まります。
モデルが監視を担うことで、人が常時張り付かなくても大量のジョブを見張れます。検知から停止の指示までを仕組みとしてつなげている点が、この連携の中心と言えます。
35秒の上限と障害に強い設計
OpenAIによると、Control Roomが停止の指示を受けてから、ジョブが先へ進めなくなるまでの時間は最大35秒です。この遅延は、推論の認可に使うキャッシュ層から生じています。キャッシュ層は、大量のトラフィックを処理するために必要な層です。同社はこの時間をゼロに近づけ、ジョブを即時に終了できるようにする取り組みを進めています。
キャッシュは、一度得た結果を一定時間保存して再利用する仕組みです。毎回の推論で中央に問い合わせると、負荷が集中します。認可結果を一時的に使い回せば負荷は減りますが、停止の反映は遅れます。35秒という上限は、このトレードオフから生じているとみられます。
実験や評価などのワークロードは、研究者や研究チームが所有・運用しています。そのためコードは頻繁に変わり、重要な安全対策を実装する場所としては理想的ではありません。Control Roomは、ワークロードのコードにバグや不具合があっても機能するよう設計されています。
具体的には、停止の仕組みを推論層に実装しています。ワークロードのコードは多様で、分散しています。一方、OpenAIの研究全体で使われる推論のコード経路はごく少数です。展開も集中的かつ均一です。推論層を関所にすることで、研究中のすべての推論が毎回の認可確認を受けると強く保証できます。
加えて、エージェントとプログラムによる継続的な点検(スイープ)も実施しています。目的は、Control Roomを組み込んでいない独自エンジンの起動を見つけることです。Control Roomを無効にしたエンジンも対象で、誤って起動された場合も悪意による場合も含みます。
さらに、システムは「フェイルクローズ」で動きます。エンジン側の連携は、Control Roomサービスが止まると推論リクエストをすべて拒否する設定です。原因がシステムエラーでも、悪意ある第三者の改ざんなどによる無効化でも同じです。Control Roomが正常に戻るまで、推論は再開しません。
フェイルクローズは、最前線モデルの研究ワークロードすべてに導入済みです。残りの研究ワークロードにも、発表から数日で展開を終える予定としています。同社はControl Roomを安全な開発に向けた取り組みの一部と位置づけ、今後数か月で強化・拡張するとしています。
フェイルクローズは、異常時に安全側へ倒す設計で、反対は通過を許すフェイルオープンです。安全性は高まりますが、Control Roomの障害は研究全体の停止につながります。そのため、サービス自体の可用性がより重要になると言えます。
AIエージェントを運用する側が参考にできる点
Control RoomはOpenAI社内の仕組みですが、設計の考え方は自社でAIエージェントを動かす場合にも参考になります。発表内容から読み取れる要点は次のとおりです。
- 停止の判定を、エージェント本体ではなくモデル呼び出しの手前に置く
- すべての呼び出しに、ジョブを識別するIDを付ける
- 停止は処理の強制終了ではなく、出力の拒否として実現する
- 判定役のサービスが止まったら、呼び出しも止める(フェイルクローズ)
- 停止の判断から実際に止まるまでの最大時間を把握しておく
- 判定を通らない抜け道の呼び出しがないかを定期的に点検する
小規模な環境なら、APIの呼び出しを1か所の中継処理に集め、そこで停止フラグを確認する形が近い考え方になります。ただし、フェイルクローズにすると判定役の障害で業務も止まります。止める安全性と止まる影響を比べて、どこまで厳しくするかを決めるのが良さそうです。
まとめ
OpenAIのControl Roomは、研究中のモデルの出力を、停止の判断から最大35秒で止める中央システムです。判定を推論エンジン側に置き、自身の障害時にも推論を拒否する設計が特徴です。モデルが強力になるほど、確実に止められる仕組みの価値は高まります。35秒の短縮や今後の拡張にも注目したいところです。