はじめに
Microsoft Researchが2026年10月30日、Copilotを評価するための合成データ基盤「Industry Evaluation Data Generation Platform」を紹介しました。本稿では、顧客データを使わずに企業向けAIを評価する仕組みと、その成果を解説します。
参考記事
- タイトル: From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence
- 著者: Somya Chatterjee、Harshita Sahijwani、Min Chen、Sushmitha Rajeswari Muppa、Dayquan Julienne、Irene Shaffer、Chandra Inguva、Jenny Chen、Minha Hwang、Sam Ade Jacobs
- 発行元: Microsoft Research
- 発行日: 2026年10月30日
- URL: https://www.microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence/
関連記事
要点
- Microsoftは、公開データに基づく合成企業環境でCopilotを評価する基盤を構築した。
- 製薬、資本市場、IT・ソフトウェアの3業界で、数百人規模の環境を生成している。
- 評価用の質問は6段階の自動パイプラインで生成し、品質も自動で検証する。
- 自動化により、評価データセット1件あたり約10万ドルの削減を見込んでいる。
- この基盤は、Copilot初の標準化された評価ベースラインとして社内で共有されている。
詳細解説
背景: 企業向けAIの評価が抱える矛盾
Microsoftによれば、毎日世界中の数百万人の知識労働者が、文書の作成、会議の要約、情報の検索などにCopilotを利用しています。その裏側では複数のAIシステムが連携して動いており、意図どおりに機能しているかを確かめるには、継続的なテスト・測定・改善が欠かせないとしています。
記事では、医療機関の例が挙げられています。各チームの安全性に関する情報を集約して迅速に意思決定する必要がある組織で、Copilotに会議の要約とアクションアイテムの抽出を頼むと、数秒で議事録の具体的な箇所を引用した要約が返ってきます。では、その回答が正確で、漏れがなく、会議の内容にきちんと根拠を持っているかを、どう確かめればよいのか。この問いに答えるのが今回の評価基盤です。
ここには根本的な矛盾があります。企業向けAIを適切に評価するには、組織の上下関係、プロジェクトの経緯、コミュニケーションのパターン、業界特有の業務の流れといった、実際の組織の複雑さを備えたテストデータが必要です。一方で、実在の企業データには機密情報が含まれるため、評価に使うことはどのような場合でもできません。Microsoftはこの矛盾の解消を、プロジェクトの中心課題として位置づけています。
Industry Evaluation Data Generation Platformの3本柱
Microsoftは、この課題に対して「Industry Evaluation Data Generation Platform」という評価の仕組みを開発しました。業界別の評価データセットを含み、次の3本柱で構成されています。
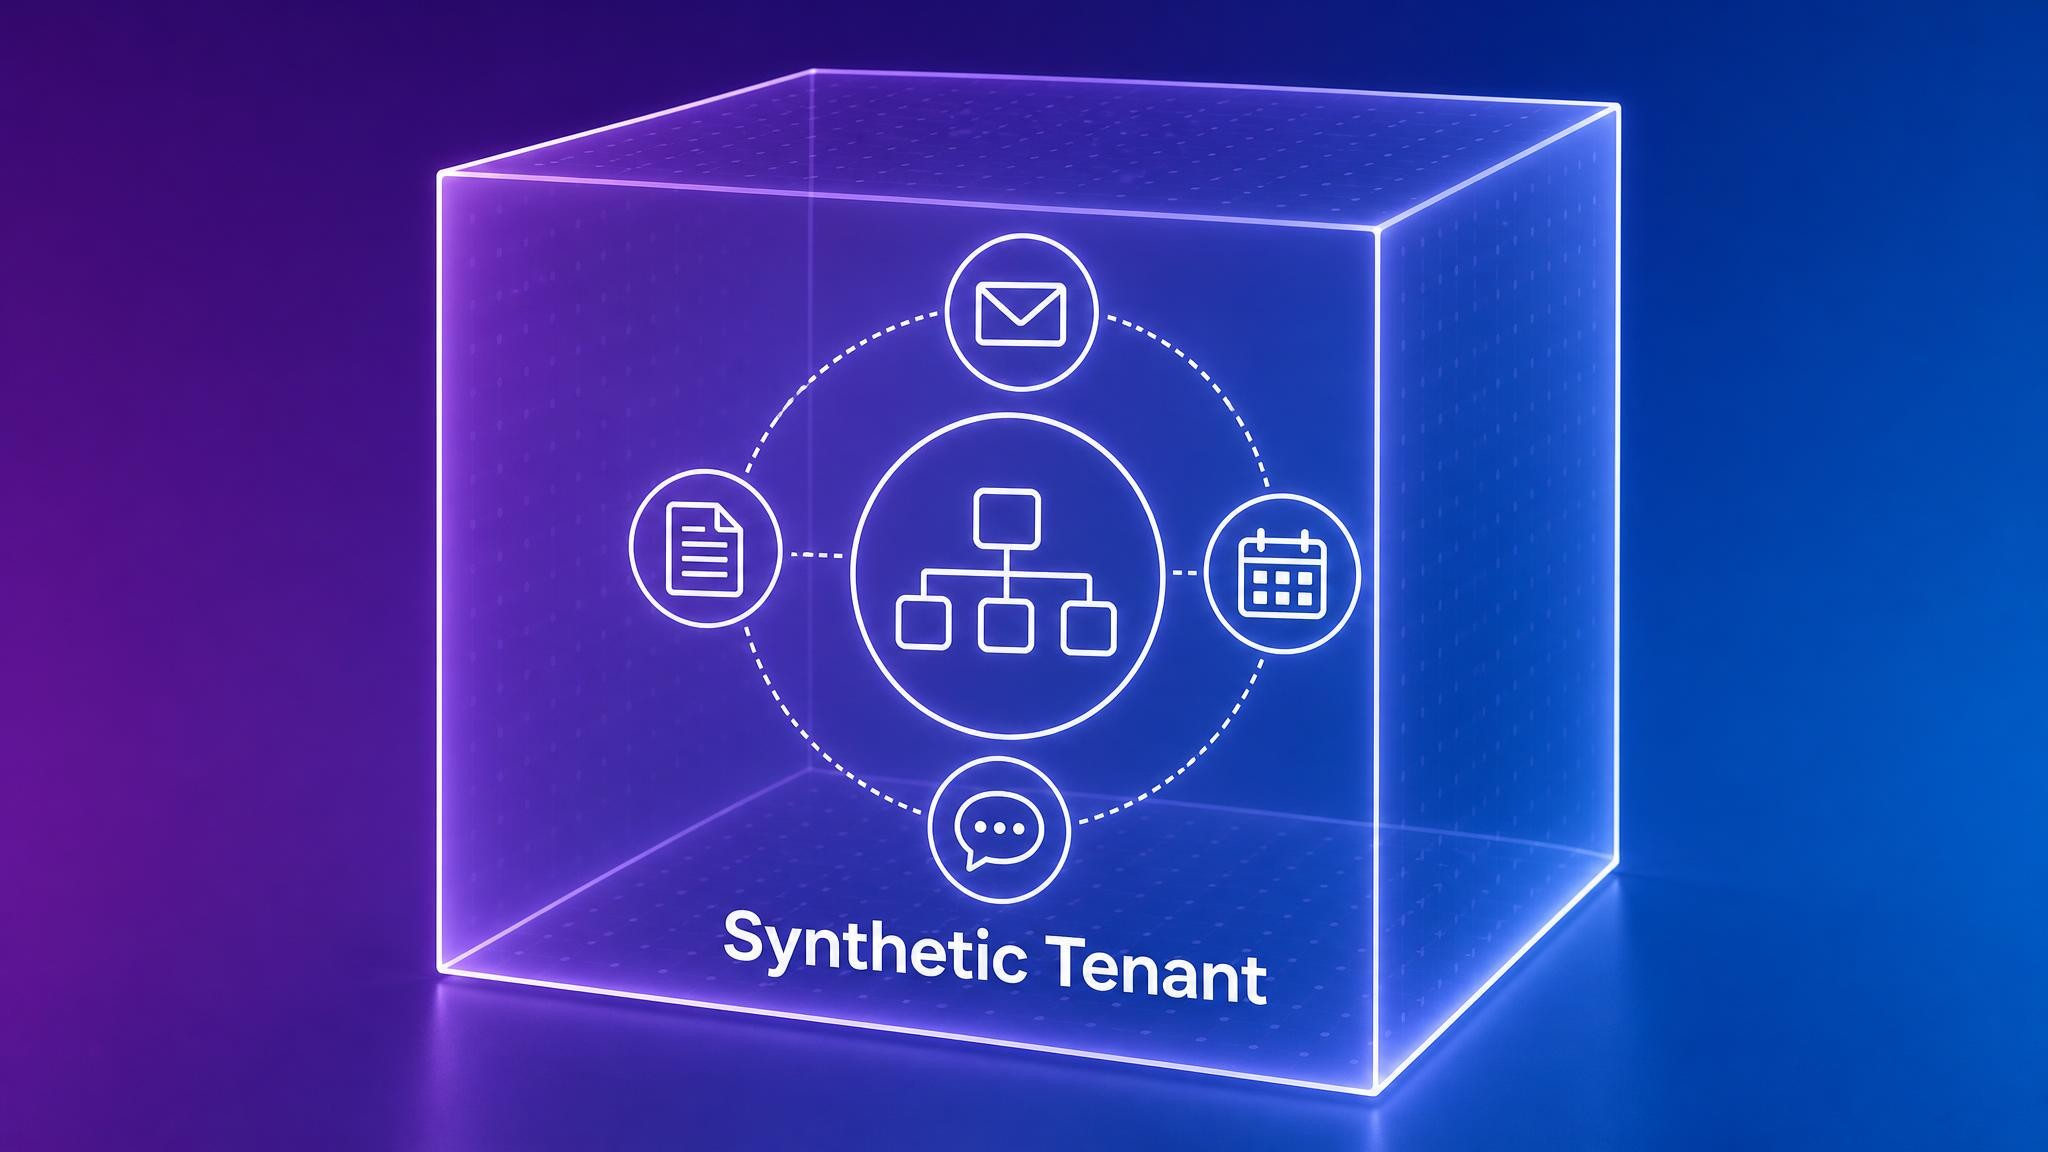
- 合成企業環境: 現実的なユーザー、会議、メール、文書、組織構造を備えた、シミュレーション上のCopilot環境。顧客データを一切使わずに、実際の組織の複雑さを再現する
- 自動クエリ生成パイプライン: 評価データセットを迅速かつ再現可能な形で作成する仕組み
- 構造化された品質フレームワーク: 合成データが意味のある評価に耐える水準に達しているかを確認する仕組み
これらによって、「Copilotはユーザーが必要とすることを本当に実行できているか」「それをユーザーのデータに一切触れずに証明できるか」という2つの問いに答えることを目指しています。
合成データ(synthetic data)とは、実在のデータを直接使わず、統計的な特徴や構造を模して人工的に生成したデータのことです。個人情報や機密情報を含まない形で、現実に近い検証環境を作れる点が利点とされています。今回の取り組みは、単発のテストデータではなく「組織まるごと」を合成している点に特徴があると考えられます。
合成企業環境: 組織まるごとを再現する
Microsoftは、手作業で用意した小規模なテストデータに頼るのではなく、 フルスケールの合成環境 を生成しています。それぞれが現実的な組織構造、コミュニケーションの履歴、業務の成果物を備えた、シミュレーション上の企業ワークスペースです。Microsoftの用語ではこれを「テナント」と呼びます。テナントとは、独自のユーザー、データ、設定を持つ、他から分離された組織環境のことです。これらの環境は、各チームや組織が自由に拡張して使える基盤として設計されています。
環境を現実に近づけるため、次の公開データが活用されています。
- O*NET: 米国労働省の職業データベース。合成された社員の役割や職責を現実的にし、役割ごとの業務の種類と頻度を調整し、治験レビューやポートフォリオ更新といった業界特有の業務フローを作り込むために使われた
- オンラインの求人情報: 現実的な役職名、報告ライン、部門構成の参考にされた
- SEC(米国証券取引委員会)への提出書類: 組織の規模、事業部門の構成、財務状況の参考にされた
これらはすべて公開されている情報源で、Microsoftの法務・ポリシー部門による審査と承認を経ているとしています。
もう一つ重要なのが、合成環境が静止したスナップショットではない点です。会議の履歴、プロジェクトのタイムライン、数週間にわたって続くメールのやり取り、自然に起こる組織変更など、時間とともに変化する組織がシミュレーションされています。Microsoftによれば、Copilotへの質問の多くは、本質的に時間を意識した内容です。「先週木曜にチームは何を決めたか」「前回の四半期レビュー以降に何が変わったか」といった質問は、元のデータに本物の時間構造がなければ意味のある評価になりません。本稿としては、この「時間軸の再現」が、汎用的なベンチマークとの大きな違いの一つだと受け止めています。
業界別のシミュレーション
Microsoftは、業界ごとに特徴の異なる3つの合成環境を生成しました。
- 製薬: 規制当局への申請業務、治験に関する議論、部門横断の安全性レビュー会議を含む
- 資本市場: 案件パイプライン、コンプライアンス関連のやり取り、顧客ポートフォリオのレビューを含む
- IT・ソフトウェア企業: スプリント計画、コードレビューの議論、製品ローンチの調整をシミュレーションする
業界を特定することで、汎用的なテストケースでは見つからない業界特有の失敗パターンを洗い出し、その分野の実際のユーザーが尋ねるような質問でCopilotを試せるとしています。同じ「会議の要約」でも、製薬業界では規制上の論点の取りこぼしが、資本市場ではコンプライアンス上の表現の誤りが重く受け止められるなど、求められる正確さの中身は業界によって異なると考えられます。
6段階の自動クエリ生成パイプライン
合成環境は評価の土台になりますが、それだけでは足りません。Copilotが正しい情報を見つけ、正しく統合し、役立つ形で提示できるかを試すための、現実的な評価用の質問(クエリ)が必要です。業界特有で、データに根拠を持つ質問を何千件も手作業で書くのは、コストも時間もかかりすぎます。そこでMicrosoftは、自動パイプラインを構築しました。
記事の説明をもとに、本稿でパイプラインの流れを整理すると次のようになります。
- 一般的な職場の作業をまとめた大規模なライブラリから出発する
- 対象の業界に関係するものに絞り込む
- 業界特有の言葉遣いや文脈に合わせて調整する
- AIを使って、合成環境のデータに根拠を持つ質問を生成する
- 質問を、より自然で人間らしい表現に書き直す
- 各質問の正確さと重複のなさを検証する
こうして、汎用的な質問の雛形から、現実的で業界に特化した高品質な質問の集合が作られ、実際の利用場面に即した評価を大規模かつ安定して行えるようになるとしています。
合成データの品質をどう確かめるか
合成データを作ることは課題の一部にすぎず、そのデータが意味のある評価を生むだけの品質を持っているかも確かめる必要があります。Microsoftは、社内の意味的評価フレームワークで、合成環境の品質を次の観点から測定しています。
- 構造的忠実性: 組織構造が、現実的な報告ライン、チームの規模、部門横断の関係を反映しているか
- 文脈的関連性: 質問や業務フローが、実際の企業での利用パターンを代表しているか
- 行動のリアリティ: シミュレーション上のユーザーが、人間らしいコミュニケーションや協働のパターンを示しているか
- コンテンツの安全性: 生成された内容に有害・不快な表現や個人を特定できる情報が含まれず、実在の人物になりすましていないか
なお、元記事の本文では「3つの観点」と書かれていますが、列挙されている項目は4つです。本稿では列挙に従って4項目をすべて掲載しています。
エンドツーエンドの自動化がもたらしたもの
合成環境とクエリパイプラインは評価の方法論を提供しますが、適切な自動化がなければ、実務上は次のような限界があるとMicrosoftは指摘しています。
- 再現性: 手作業では毎回微妙に異なる結果になり、リリース間で評価を比較しにくい
- 規模: 業界の種類と設定のバリエーションの数が、どのチームも手作業で作れる量を超えている
- 改善の速度: 手作業での作成には数日かかり、必要なフィードバックが遅れて開発サイクルが鈍る
- チーム間の一貫性: 標準化されたツールがないと、チームごとに形式や品質がばらばらの評価データセットができてしまう
Microsoftによれば、自動化によって、数日がかりだった評価データセットの作成が自動実行で済むようになり、評価データセット1件あたり約10万ドル、プロジェクト全体で約30万ドルの削減を見込んでいます。ただし同社は、より重要な成果として「同じ設定からデータセットを再生成すれば、どのチームでもまったく同じ結果が得られるようになったこと」を挙げています。モデルや機能の更新のたびに同じ物差しで比較できることは、評価の信頼性を支える前提だと思います。
プライバシーと安全性を設計に組み込む
Microsoftは、業界別評価データセットの譲れない設計原則として、 パイプラインのどの段階でも実在の顧客データを使わない ことを掲げています。組織構造からメールの本文、会議の議事録まで、すべての要素が合成され、顧客データは一切入力されません。データが完全に合成され、安全性のチェックも経ているため、各チームは評判、コンプライアンス、責任あるAI(Responsible AI)の面でリスクを生まずに、データを広く共有・再利用できるとしています。
安全対策として、次の3点が挙げられています。
- 現実の統計的な分布を参照する際の、プライバシーを保護した集計手法
- すべての公開データ源に対する、法務の専門家による審査と承認
- パイプライン全体を通じた、データの出所と系譜(どこから来てどう加工されたか)の明確な追跡
これにより、Microsoft社内の各チームは、プライバシー審査の手間や、本来なら改善を遅らせるデータ取り扱い上の制約なしに、実験、ベンチマーク、回帰テスト(更新によって既存の機能が壊れていないかの確認)に自由に使えるとしています。Microsoftは「プライバシーへの配慮はシステムの制約ではなく、幅広い活用を可能にするもの」と表現しています。プライバシーを「守るべき制約」ではなく「共有を可能にする条件」として捉える見方は、評価データの扱いに悩む組織にとっても参考になると思います。
成果: 品質スコアの向上と社内標準化
Microsoftは、プロジェクト開始以降の成果を3つの観点で報告しています。
合成データの品質 については、社内の採点システムで、生成データの構造的・文脈的・統計的な忠実性が大きく向上したとしています。合成データが実際の企業環境の複雑さやパターンをどれだけ再現しているかを測る複合品質指標では、当初の生成手法と比べてスコアが39%向上しました。業界特化型の環境の中には、1.0満点で0.9を超える品質スコアに達したものもあるとしています。改善の要因としては、現実的な業界のシグナルを取り入れたことと、複合品質指標を使って構造の整合性、文脈の一貫性、統計的な多様性の改善を自動化したことが挙げられています。
規模と効率 については、3つの業界それぞれの合成環境が、完全なコミュニケーション履歴を持つ数百人のユーザーを含むまでになりました。評価データセットの作成は、数日がかりの手作業から自動実行へと移行しています。
組織への浸透 については、この評価データ生成基盤がチーム横断で再利用できるよう社内の共有カタログに公開され、Copilot初の標準化された評価ベースラインとして確立されたとしています。Microsoftは、これを単なる段階的な改善ではなく、場当たり的な手作業から、標準化された再現可能なインフラへと評価の進め方が変わったものだと説明しています。
一方で、ここで示されている品質スコアはMicrosoft社内の指標によるもので、合成環境で高い評価を得たCopilotが、実際の顧客環境でどの程度同じ性能を示すかについては、記事の中で具体的なデータは示されていません。評価用データの「現実らしさ」と、そこでの評価結果の「現実での妥当性」は別の問題でもあるため、この点は今後の情報公開を待ちたいところだと思います。
今後の課題: エージェント型AIの評価へ
Microsoftは、Copilotが単発の質疑応答から、複数のステップを自律的にこなすエージェント型のワークフローへと広がる中でも、評価をアプローチの中心に据え続けるとしています。企業向けAIの品質は正確さや速さだけでなく信頼の問題であり、その信頼は徹底した再現可能な評価からしか生まれない。そしてその信頼は、厳格なプライバシー保護と先回りしたコンテンツの安全性という2つの約束に支えられている、というのが同社の考え方です。
今後取り組む課題として、次の3つの問いが挙げられています。
- 複数ターンにわたるエージェント型の対話の品質を、どう評価するか
- 数か月から数年かけて変化する組織の動きを、合成環境でどう再現するか
- テキストを生成するだけでなく行動を起こすAIシステムの評価の枠組みを、どう作るか
評価の重要性はAI業界全体で高まっており、Anthropicが開発の内部に評価者を置く「組み込み型評価」をAccentureと進めているように、各社が評価の方法そのものを差別化の領域として扱い始めていると読めます。なお、Microsoftの記事はMicrosoft社内での取り組みの紹介であり、この評価基盤や合成データセットが外部に公開されるとは書かれていません。
Copilotを導入する企業の側から見ると、この考え方は小さな規模でも応用できる部分があると考えています。たとえば、自社の業務に似せた架空の会議記録や文書を用意し、実データを使う前にAIツールの挙動を試してみる、といった進め方です。導入前の検証で機密情報の扱いに悩む組織にとって、一つのヒントになるのではないでしょうか。
まとめ
Microsoftは、公開データに基づく合成企業環境と自動化されたクエリ生成によって、顧客データに触れずにCopilotを評価する基盤を構築しました。エージェント型AIの評価がどう発展するかに注目したいところです。評価の落とし穴については、コーディングベンチマークの報酬ハッキングに関する解説もあわせてご覧ください。