はじめに
Googleは2026年8月11日、軽量モデル「Gemma」と推論ランタイム「LiteRT」を組み合わせ、Raspberry Pi上でエッジAIを動かす手法を開発者向けブログで公開しました。本稿では、ロボット「Reachy Mini」を使った実証デモを軸に、モデル構成や性能データ、導入方法を解説します。
参考記事
- タイトル: Mastering Edge AI on Raspberry Pi with LiteRT and Gemma
- 著者: Lu Wang、Terry Heo、Naushir Patuck、José María Casanova
- 発行元: Google for Developers(Google Developers Blog)
- 発行日: 2026年8月11日
- URL: https://developers.googleblog.com/mastering-edge-ai-on-raspberry-pi-with-litert-and-gemma/
関連記事
要点
- GoogleはRaspberry Pi向けに、軽量言語モデル「Gemma」と推論ランタイム「LiteRT」を組み合わせたエッジAI実装を公開した。
- Raspberry Pi 5のCPU上でGemma 4 E2Bを動作させた場合、プリフィル99トークン/秒、デコード9トークン/秒、ピークメモリ使用量1432MBを記録した。
- GPU向けにはWebGPU(Vulkan)バックエンド「ML Drift」が用意され、CPUとGPUの並列実行が可能になった。
- 実証デモでは、ロボット「Reachy Mini」が物体検出・音声認識・応答生成・音声合成をすべてオンデバイスで並行実行する構成が示された。
- コマンドラインツール「LiteRT CLI」により、モデルの変換・量子化・ベンチマーク・推論を一括で扱えるようになった。
詳細解説
Gemmaのモデルラインアップとエージェント機能
Gemmaは、Googleが提供する軽量なオープンモデル群です。2026年4月に公開されたGemma 4はパラメータ効率の高さが特徴でしたが、今回のRaspberry Pi向けラインアップはその流れを継いだエッジ特化のバリエーションと言えます。Googleによれば、用途に応じて「Gemma 3 270M」「EmbeddingGemma 300M」「Gemma 3 1B」「Gemma 4 E2B」「Gemma 4 E4B」の5種類が選べます。Gemma 3 270Mは感情分析やエンティティ抽出などタスク特化のファインチューニング向け基盤モデル、EmbeddingGemma 300Mは検索やRAG(検索拡張生成)に使えるテキスト埋め込みモデルです。Gemma 4 E2Bはメモリ制約の厳しいモバイル・エッジ環境向け、Gemma 4 E4Bは性能とサイズのバランスに優れ、複雑な多段階の推論・計画に向いているとされています。
複数サイズのモデルが用意されている背景には、エッジデバイスの計算資源やメモリ容量が機器ごとに大きく異なるという事情があります。用途に応じてモデルサイズを選べる設計は、実装の自由度を高める要素だと思います。
Raspberry Pi CPU上での性能
Googleによれば、LiteRT-LMを使ってRaspberry Pi 5のCPU上でGemma 4 E2Bを実行した場合、プリフィル(入力処理)が99トークン/秒、デコード(生成)が9トークン/秒で、ピーク時のメモリ使用量は1432MBに抑えられたとしています。Gemma 4 E2Bのトークナイザーは1トークンあたり平均4.2文字を扱えるため、Reachy Miniの音声デモでは1秒あたり約27.3文字、毎分約300語(wpm)の生成速度を達成したと報告されています。
人間の会話速度は毎分150語程度とされることが多く、その基準で見るとこの生成速度は人間の発話のおよそ2倍に相当します。本稿としては、リアルタイムの音声対話や翻訳用途にも十分対応できる速度だと受け止めています。
GPUによる並列実行とLiteRTの対応
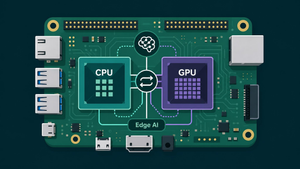
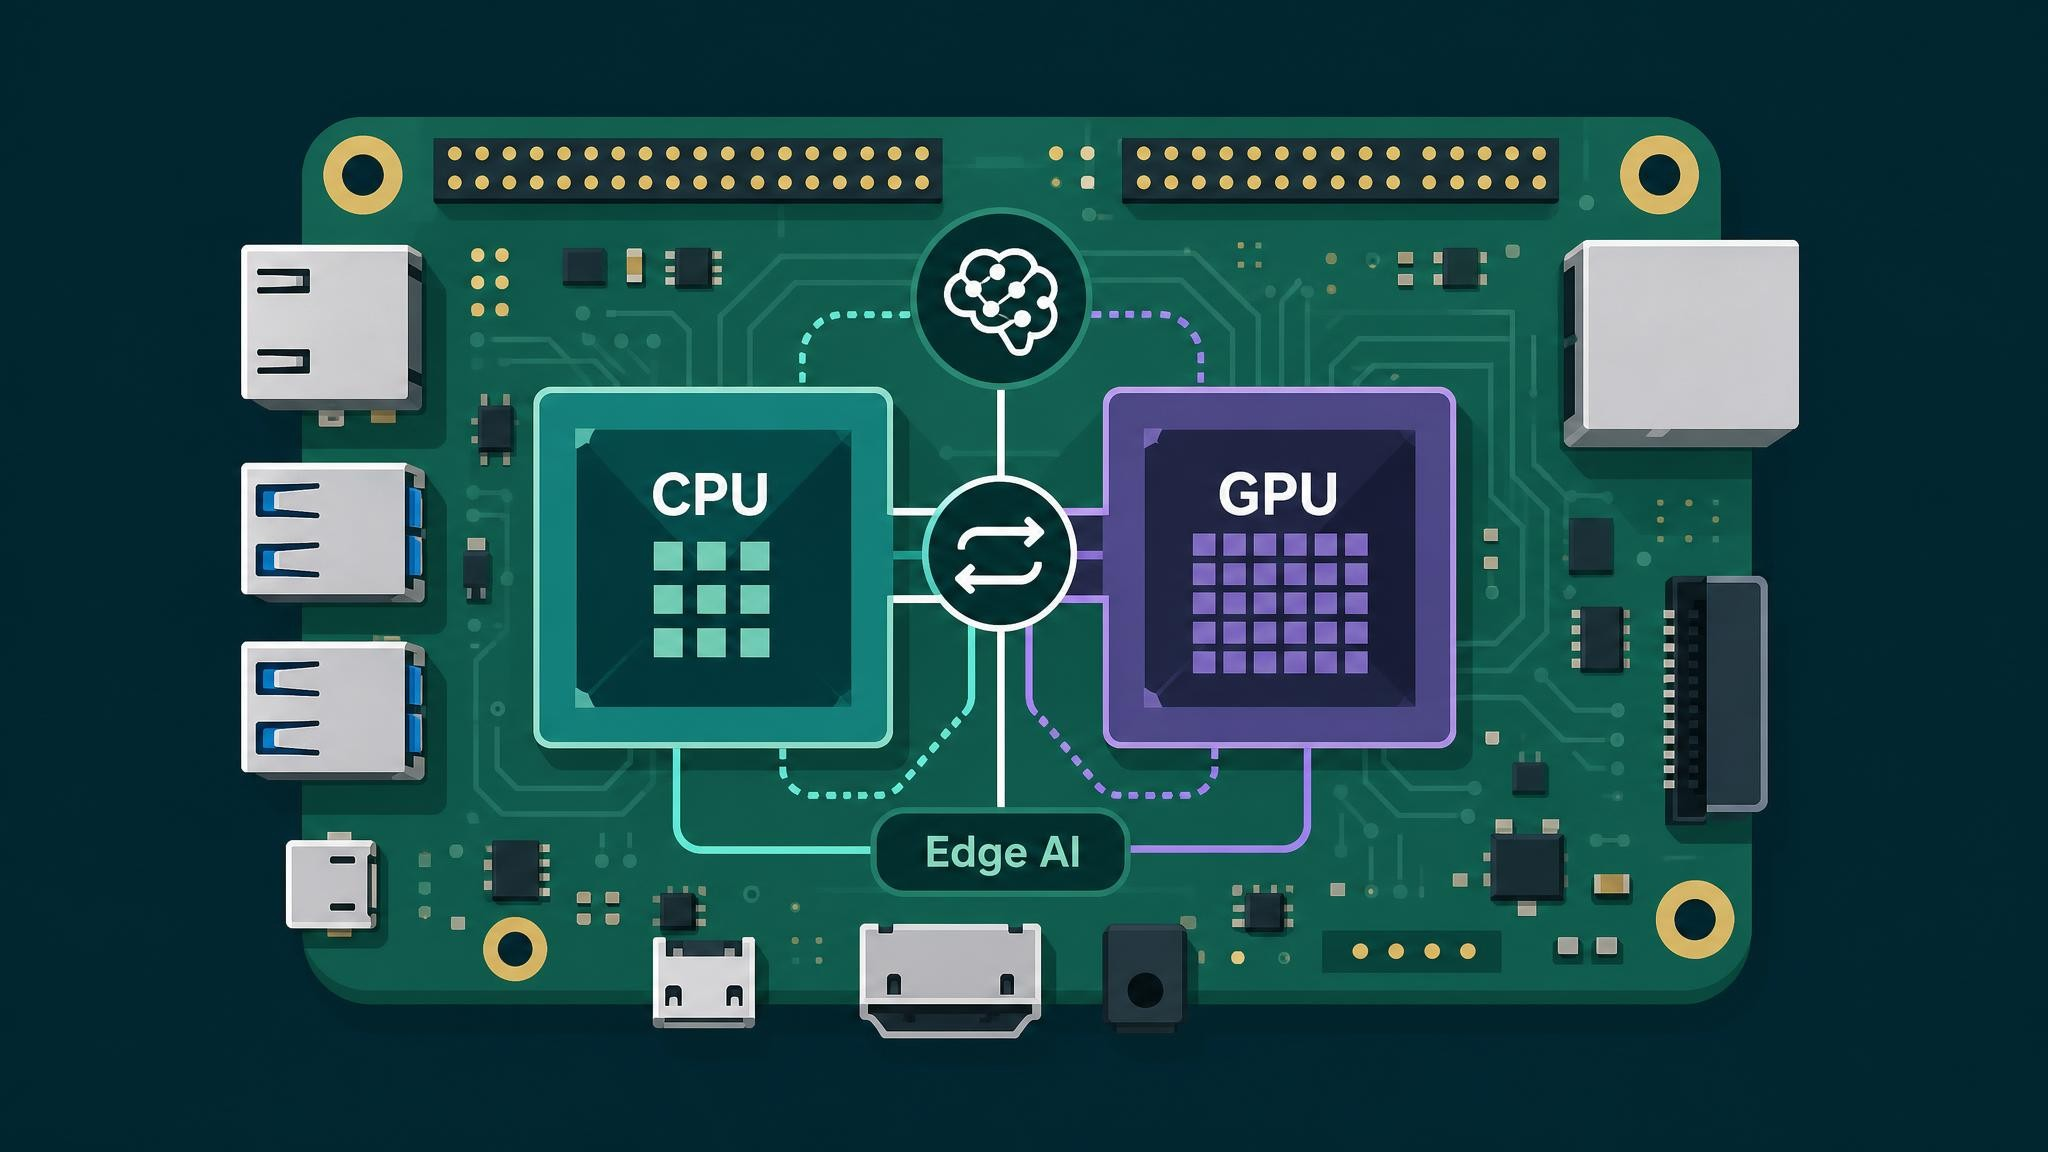
Googleの説明によれば、Raspberry Pi 5はクアッドコアのARM Cortex-A76 CPUで最大約153.6GFLOPS(FP32)、統合GPU「Broadcom VideoCore VII」で約76.8GFLOPS(FP32)の性能を持ちます。LiteRTは、このGPUを活用する「WebGPU(Vulkan)」バックエンド(ML Drift経由)を新たに導入し、CPUとGPUに処理を振り分けるヘテロジニアス(異種)並列実行に対応しました。映像認識モデルをGPU側に割り当てることで、CPU側のリソースをシステム監視やLLM推論に優先的に使えるようになるとしています。
単純な計算能力だけを比較するとCPUの方が高性能ですが、処理を分散させることで全体のスループットと発熱のバランスを取れる点に、エッジデバイス特有の設計思想が表れていると考えています。
Reachy Miniのパイプライン構成
ブログのデモでは、ロボット「Reachy Mini」が、物体検出(GPU上でUltralytics YOLOを実行)、音声認識(CPU上でMoonshineを実行)、応答生成(CPU上でGemma 4 E2Bを実行)、音声合成(CPU上でTTSを実行)という4つの処理を並行して行う構成が示されています。カメラ映像はGPUで継続的に処理され、ユーザーが話しかけるとCPU側の音声認識モデルがテキスト化し、Gemma 4 E2Bが会話内容と視覚情報を組み合わせて応答と身体動作(ジェスチャー)を生成し、TTSがストリーミングで音声を返すという流れです。
カメラ・音声・言語処理という複数のリアルタイム処理を1台のRaspberry Pi上で同時に動かせる点は、クラウド接続なしで動く自律ロボットの実現例として分かりやすい構成だと考えています。
導入方法
LiteRT CLIを使うと、モデルの変換・量子化・ベンチマーク・推論をひとつのコマンド群でまとめて扱えます。Googleが示す導入手順では、まずpip(Pythonのパッケージ管理ツール)でLiteRT CLIをインストールします。
# LiteRT CLIをインストールするコマンドです(仮想環境内での実行が推奨されています)

pip install litert-cli
続いて、Hugging Face上のモデルリポジトリを指定し、認証トークンを設定した上でモデルを実行します。
# Hugging Faceの認証トークンを環境変数に設定するコマンドです
export HUGGING_FACE_HUB_TOKEN=<your_hugging_face_token_here>

# litert-community/gemma-4-E2B-it-litert-lm を取得し、画像入力付きで推論を実行するコマンドです
litert lm run \
  --from-huggingface-repo=litert-community/gemma-4-E2B-it-litert-lm \
  gemma-4-E2B-it.litertlm \
  --attachment=image.jpg \
  --prompt="You are Reachy Mini. Identify the main object in front of you, state its location (Left/Right/Center), and suggest head action in 10 words or less."
このコマンド例は参考記事に記載されているものをもとにしており、本稿側では動作確認を行っていません。実際に試す場合は、Hugging Face上のモデルページで最新の利用条件やファイルサイズを事前に確認したうえで進めることをおすすめします。
なお、GoogleはLiteRTとGemmaの対応を今後Raspberry Pi向けAIアクセラレータ「Hailo」にも拡大する計画を示しており、AI HAT+シリーズを使ったハードウェアアクセラレーションが予定されているとのことです。
まとめ
本稿では、GoogleがGemmaとLiteRTでRaspberry Pi上でエッジAIを動かす仕組みと、ロボット「Reachy Mini」の実証例を紹介しました。CPU・GPUを使い分けた並列実行とLiteRT CLIによる開発体験の簡素化が特徴です。モバイル向け量子化モデルは過去記事でも取り上げています。