はじめに
NVIDIAが2026年9月4日、開発者向けブログで、同社のエージェント基盤「NemoClaw」を使ったメモリ駆動型エージェントの構築事例を公開しました。本稿では、この記事で示された「自己モデル」と呼ばれる記憶層の構造、ベンチマークによる評価結果、そして実行時の権限統制の考え方について解説します。
参考記事
- タイトル: Building a Memory-Driven Agent with NVIDIA NemoClaw
- 著者: Xuan Wu、Alexia Huang、Yijie Lai、Joe Liu、Xiaowei Li
- 発行元: NVIDIA Developer Blog
- 発行日: 2026年9月4日
- URL: https://developer.nvidia.com/blog/building-a-memory-driven-agent-with-nvidia-nemoclaw/
関連記事
要点
- NVIDIAは、NemoClaw上で動作するメモリ駆動型の「Chief of Staff」エージェントの設計事例を公開した
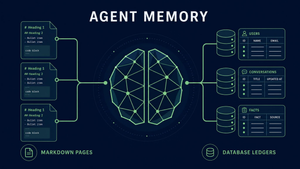
- 中核となるのは、人物・プロジェクト・優先度・作業パターンを人間が読めるMarkdownページで保持する「自己モデル(self model)」である
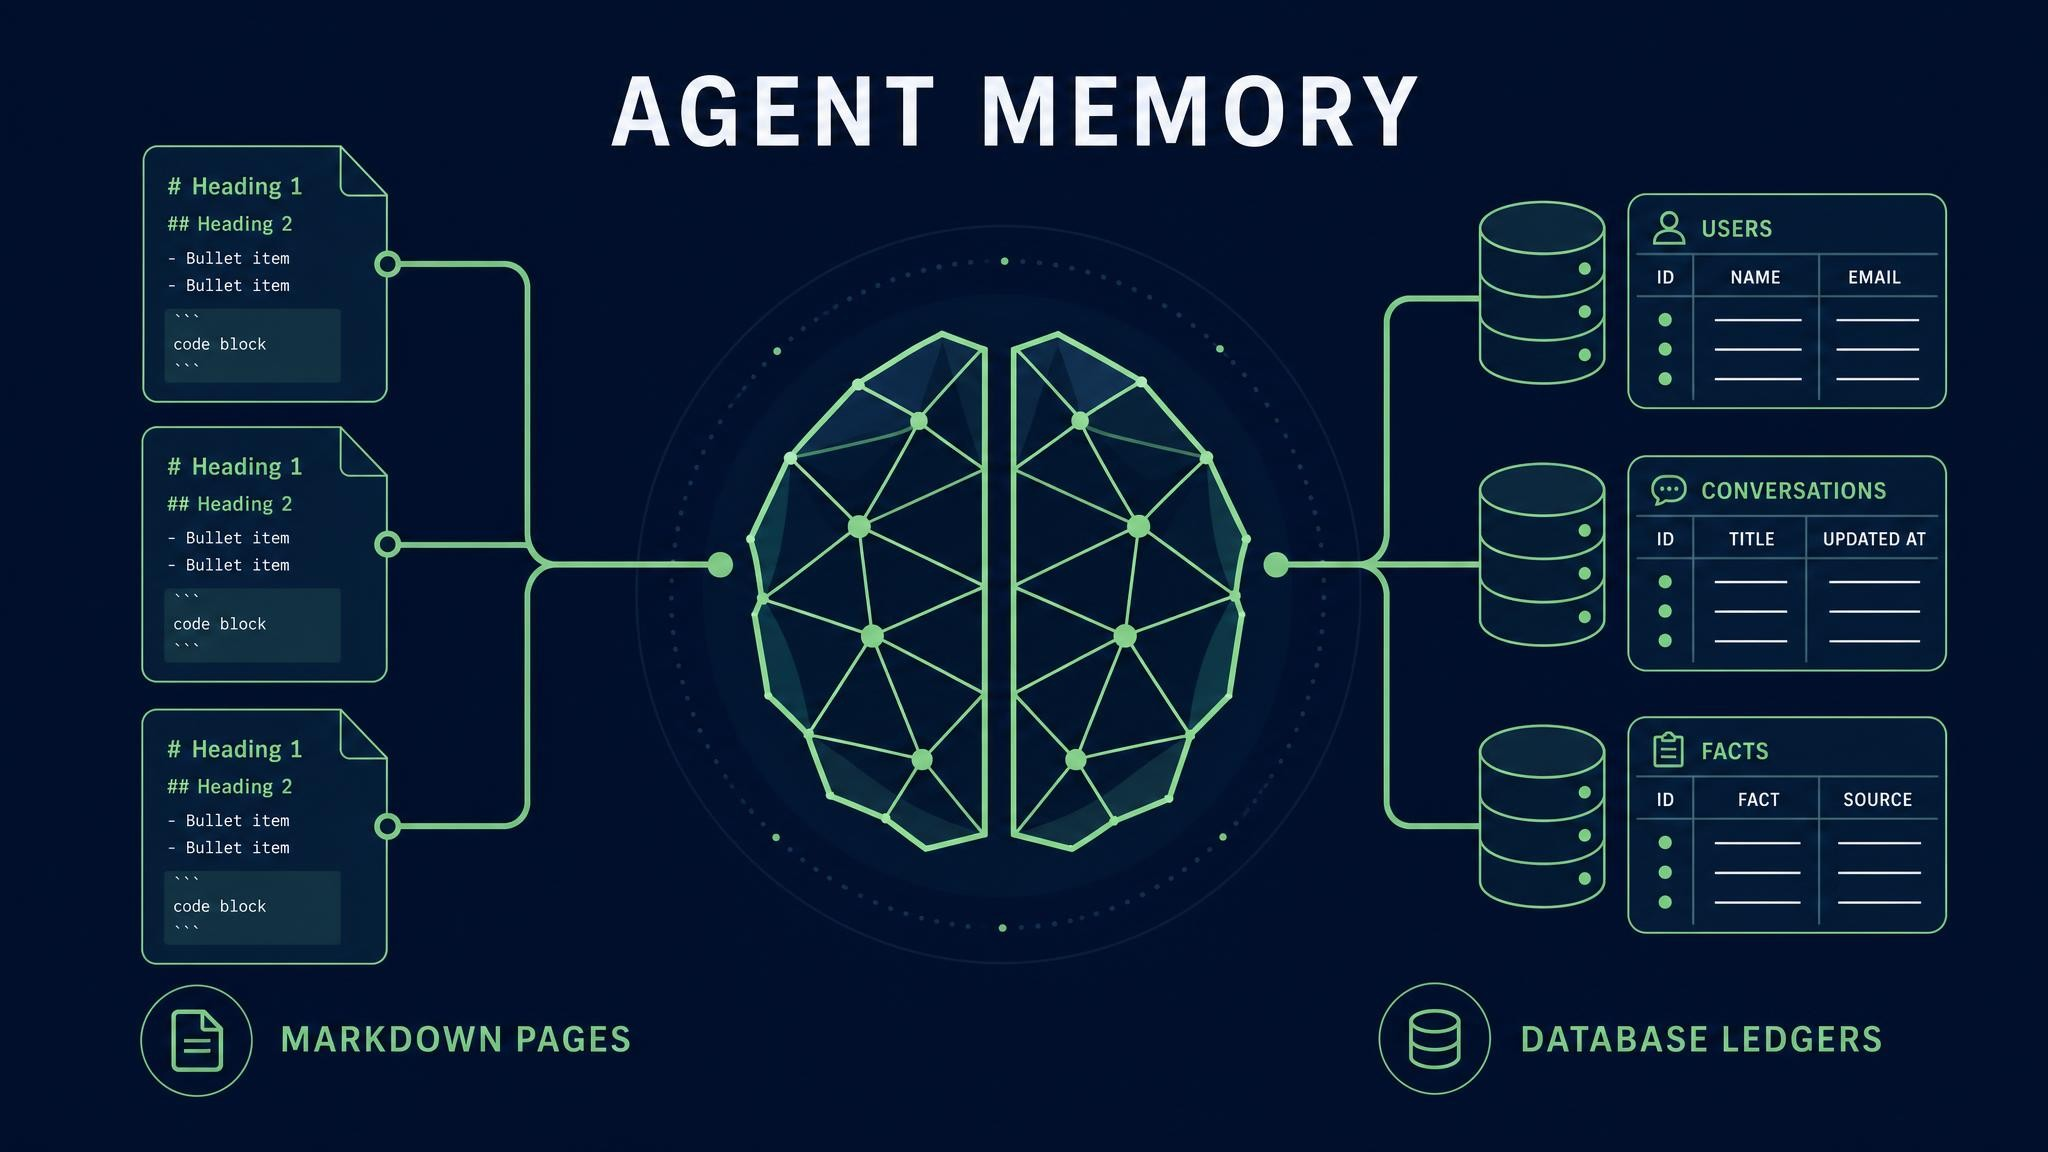
- 知識はMarkdownのメモリに、義務・順位付け・修正・監査イベントはSQLiteの台帳に分けて保存される
- Agent Memory Benchmarkでは、エージェント型RAGベースラインの総合正答率82.8%に対し、自己モデルは90.9%を記録した
- 実行時はNVIDIA OpenShellがサンドボックスとして動作し、ファイルシステム・プロセス・ネットワークへのアクセスを統制する
詳細解説
会話履歴でも検索でも埋まらない文脈
NVIDIAによれば、企業の業務はメッセージ、意思決定、プロジェクト、義務(obligation)といった要素が時間とともに変化しながら積み重なるもので、文脈を持たずに始まるAIエージェントは、貢献する前にまずそれを再構築しなければなりません。会話履歴は短期的な連続性を与えますが、現在の優先事項と過去の決定、一時的な依頼が混ざり合ってしまいます。検索(retrieval)で関連する原文を見つけられたとしても、時間をまたいだ情報同士を接続する作業はエージェント側に残ります。
あるプロジェクトの状況を尋ねられたとき、その答えは以前の決定、後のメッセージでの訂正、未解決の義務、そして「2つの異なる名前が同じプロジェクトを指している」という知識に依存しているかもしれません。エージェントに長期記憶を持たせる試みは、Microsoftが公開したMemoraの事例など各社で進められてきましたが、今回の記事は「何を覚えるか」以上に「記憶をどう構造化し、どう統治するか」に重心を置いている点が特徴だと思います。
自己モデル——人が読めるMarkdownの知識層
NVIDIAがこの課題に対して用意したのが「自己モデル(self model)」です。人物、プロジェクト、優先度、目標、概念、繰り返し発生する作業パターンといった情報を、人間が読める構造化Markdownページとして整理します。スキーマ側では、インデックス、相互参照、来歴(provenance)、そして肥大化を防ぐための成長上限が定義されています。
自己モデルは元の証拠(source evidence)を置き換えるものではなく、そこから導かれた解釈を保存する層だと説明されています。両者を分けておくことで、誤った回答が証拠に由来するのか、記憶のメンテナンスなのか、検索なのか、それとも最終的な判断なのかを切り分けられるとされています。障害の切り分けができる構造は、運用開始後に改善のサイクルを回すうえで有効だと考えられます。
証拠・知識・実行を分ける三層構造
この事例は「証拠 → 知識 → 統治された実行」という三層で整理されています。保存される情報は2種類に分かれます。人物やプロジェクト、優先度、作業パターンといった 知識 と、その項目に対応が必要か、どの順位に置くか、利用者が無視したかといった 判断 です。前者はMarkdownのエージェントメモリに、後者はSQLiteの台帳(ledger)に格納されます。
この分離により、エージェントの判断を、元のメッセージに既読フラグやラベル、フォルダとして書き込むことなく保持できます。NVIDIAは、メモリページに「この協力者はSlackを好む」と記録されていても、実際にメッセージを送る行為は認証情報、ツール権限、実行時ポリシー、利用者の承認に依存すると述べています。文脈は行動に情報を与えるが、行動を認可することはできない、という整理です。
緊急度より意図を優先するインテントゲート
受信する依頼の多くは自らを緊急だと主張しますが、その緊急度が利用者の優先事項を反映しているとは限りません。そこでインテントゲートが、最上位のティアを「利用者が明言した優先事項に結びついた義務」のために確保します。公開されているレシピでは、緊急とされた経費ポリシーの承認手続きが表示はされるものの、優先事項に紐づいた目立たない依頼より下位に置かれる例が示されています。
ここでも役割分担は明確です。関係性の解釈はモデルが担い、ティアのサイズ、あふれた場合の挙動、順位の並びは決定論的なコードが強制します。モデルの判断に全面的に委ねるのではなく、構造にあたる部分を固定する設計は、出力のばらつきを抑えるうえで現実的な選択だと思います。
利用者による修正と監査証跡
永続的な記憶は、正しい判断と同じくらい容易に誤った判断も保存してしまいます。レシピでは、義務を別のティアに移したり無視したりでき、その決定は後続の実行でも維持されます。変更は追記専用(append-only)の監査証跡に一度だけ記録されます。
繰り返される修正のパターンは、小さく読みやすい選好ポリシーの更新につながります。利用者はそのポリシーを確認・編集・削除できるため、選好がモデルの内部状態に隠れたままにならない点が特徴です。「エージェントの判断 → 利用者の修正 → 監査イベント → 選好の更新」というループが、外から見える形で保たれていると言えます。
ベンチマークで確認された効果
NVIDIAは、Agent Memory Benchmarkを用いて、多段の検索を行うエージェント型RAGベースラインと自己モデルを比較しています。いずれの構成もNVIDIA Nemotron 3 Ultraを使用しています。
| 指標 | 設問数 | エージェント型RAG | 自己モデル | 差分 |
| 総合正答率 | 186 | 82.8% | 90.9% | +8.1pp |
| 難易度の高い設問 | 31 | 67.7% | 87.1% | +19.4pp |
| 時間とともに変化した事実の追跡 | 5 | 60.0% | 100.0% | +40.0pp |
| 特定時点にもとづく推論 | 6 | 33.3% | 66.7% | +33.3pp |
| エンティティの曖昧性解消 | 15 | 66.7% | 86.7% | +20.0pp |
| 複数ソースの統合 | 73 | 87.7% | 94.5% | +6.8pp |
| コーパスに忠実な回答 | 13 | 100.0% | 92.3% | -7.7pp |
| 単一ホップの検索 | 30 | 86.7% | 83.3% | -3.3pp |
| 引用のカバレッジ | 186 | 92.5% | 97.8% | +5.4pp |
変化した事実の追跡が60.0%から100.0%に、エンティティの曖昧性解消が66.7%から86.7%に伸びており、時間軸と名寄せに関わる設問で差が大きく出ています。一方で「コーパスに忠実な回答」と「単一ホップの検索」は自己モデルが下回りました。解釈を保存する層を挟むことで、単純な事実照会では原文への忠実さがわずかに犠牲になる場合があると考えられます。設問数が5〜6件と少ない項目も含まれるため、個々の数値の振れ幅には注意が必要だと思います。
実行時の境界と、公開レシピで試せる範囲
この分離は実行時にも強制されます。NemoClawが事例をNVIDIA OpenShellと統合してライフサイクルを管理し、OpenShellがエージェントをサンドボックスで実行して、ファイルシステム・プロセス・ネットワークへのアクセスに対する統治とポリシー適用を担います。マネージド推論やMCP接続で用いる認証情報は、サンドボックスの外に置かれます。NVIDIAはその理由を、メモリや取得したコンテンツはモデルへの入力であって、信頼できるセキュリティポリシーではないためだと説明しています。エージェントが文脈を誤解したり、悪意ある指示に従ったりした場合でも、運用者が定義した境界の内側にとどまる、という考え方です。
レシピはNemoClaw向けのHermesプロファイルとして配布され、メモリスキーマ、義務台帳、順位付けロジック、修正と監査の経路、定期メンテナンス、合成データ、オフラインのウォークスルー、ユニットテストが一式で含まれます。登場する人物や組織はすべて架空で、ウォークスルーでは記録済みのモデル判断が推論の代わりに使われます。現時点のレシピはメモリの基盤に絞られており、メッセージの送信や元システムの変更は行いません。業務アカウントを接続せずに設計を確認できる一方、実際のコネクタを使う段階では認証情報、プライバシー、保持期間、削除の扱いを別途検討する必要があるとされています。
まとめ
今回の事例は、エージェントの記憶を保存の問題ではなく、構造化・選択的な取り出し・統治の問題として整理した設計だと言えます。ベンチマークでも総合正答率が82.8%から90.9%へ改善する一方、単純な事実照会では下回る項目もありました。記憶設計の考え方については、過去記事でも整理していますので、あわせてご覧いただければと思います。