はじめに
Google Researchが2026年7月15日、拡散モデルが訓練データをそのまま暗記するのではなく新しいデータを生み出す「創造性」の仕組みを、数学的に解明した研究をブログで公開しました。本稿では、この発表内容をもとに、創造性の背景にある「スコア平滑化」という現象と、その実用的な意味について解説します。
参考記事
- タイトル: Towards demystifying the creativity of diffusion models
- 著者: Zhengdao Chen(Research Scientist, Google Research)
- 発行元: Google Research Blog
- 発行日: 2026年7月15日
- URL: https://research.google/blog/towards-demystifying-the-creativity-of-diffusion-models/
関連記事
要点
- 拡散モデルの創造性は偶然の産物ではなく、ニューラルネットワークが学習する過程で生じる数学的な帰結である
- 学習時の正則化(重みの過学習を防ぐ仕組み)によってスコア関数が滑らかになる「スコア平滑化」が、訓練データ点間の補間を生み出す
- 1次元の簡易モデルでは、スコア関数が滑らかになるほど生成過程が訓練データそのものに収束しにくくなることが確認された
- 多次元の実データでは、スコア平滑化がデータの多様体(マニフォールド)に沿った方向にのみ働き、画像としての自然さと新規性の両立を可能にする
- 研究チームは数値実験に用いたコードをGitHubで公開している
詳細解説
拡散モデルはなぜ「創造的」に見えるのか
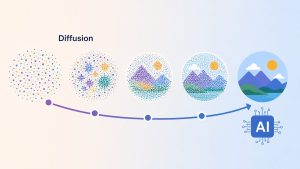
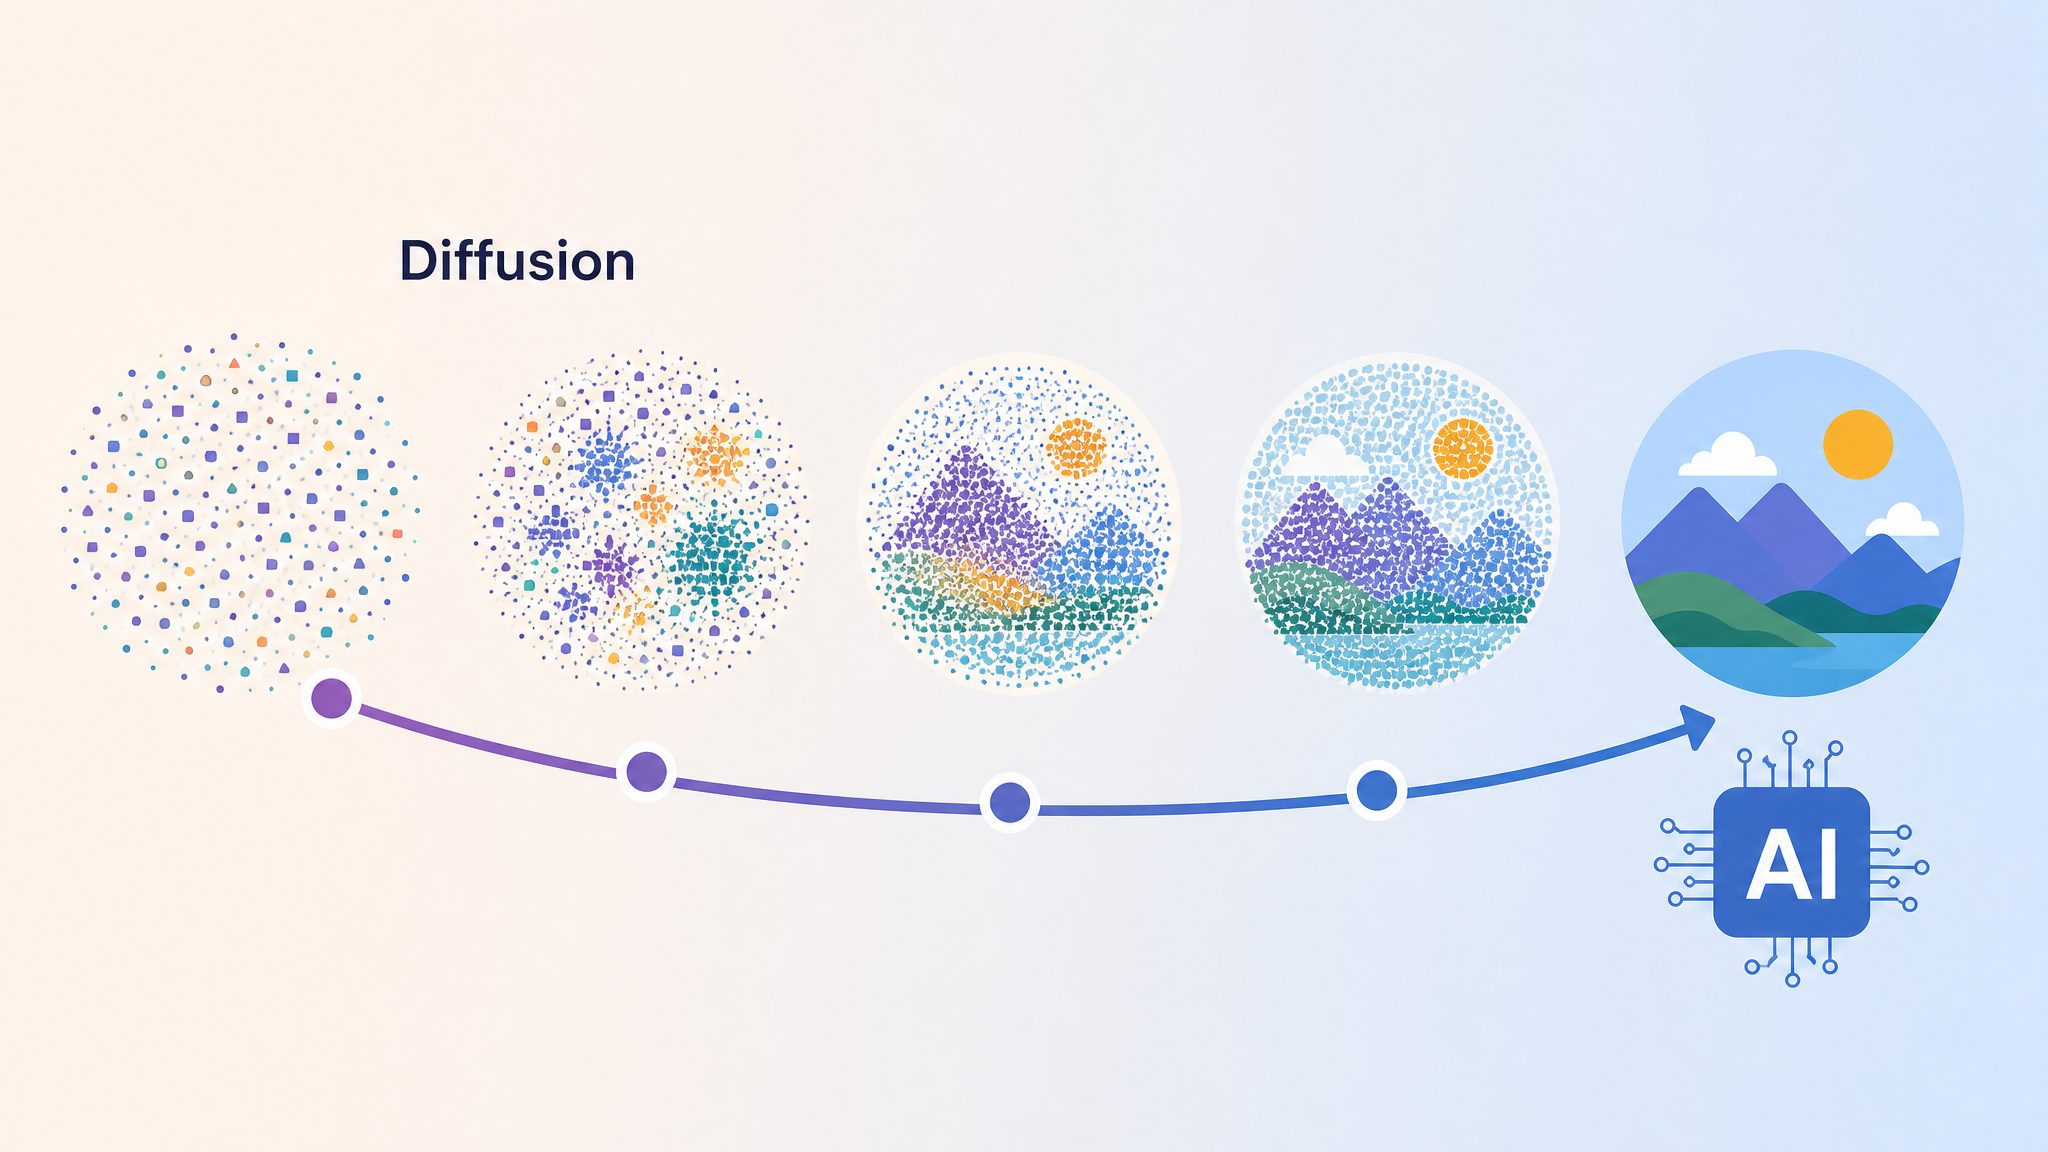
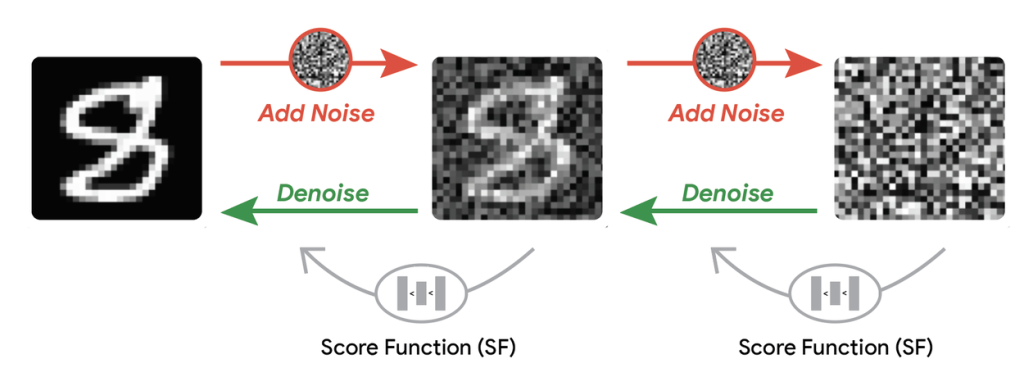
拡散モデルは、画像生成や分子設計など複雑な構造を持つデータの生成に広く使われている手法です。Google Researchによれば、訓練データセットにない新しいデータを生み出す能力を持ち、その意味で「創造性」を示すとされています。学習の仕組みは、実際の画像データにノイズを加えて完全に崩し、そこから元の画像を復元できるようモデルを訓練する「ノイズ除去(デノイジング)」と呼ばれる過程です。
もしモデルが訓練データだけをもとにこのノイズ除去を完璧にこなせるなら、生成されるのは訓練データの複製、つまり「暗記(メモライゼーション)」になるはずです。この場合、モデルは新しいものを生み出す装置ではなく、単なる検索ツールとして振る舞うことになります。ところが実際の拡散モデルは、暗記だけにとどまらず新しいデータを生み出す方向へ一般化することが知られています。この一般化がなぜ起きるのかは、生成AIの「ブラックボックス」性を理解するうえで重要な問いだと考えられます。
「スコア平滑化」が創造性を生む仕組み
Google Researchは今回、ノイズから意味のあるデータへと粒子を導く「力場」にあたる スコア関数 (データの各点でどちらへ動くべきかを示す関数)に着目しました。もし訓練データから完璧に学習されたスコア関数を使えば、粒子は訓練データ点そのものへ収束し、暗記が起こります。
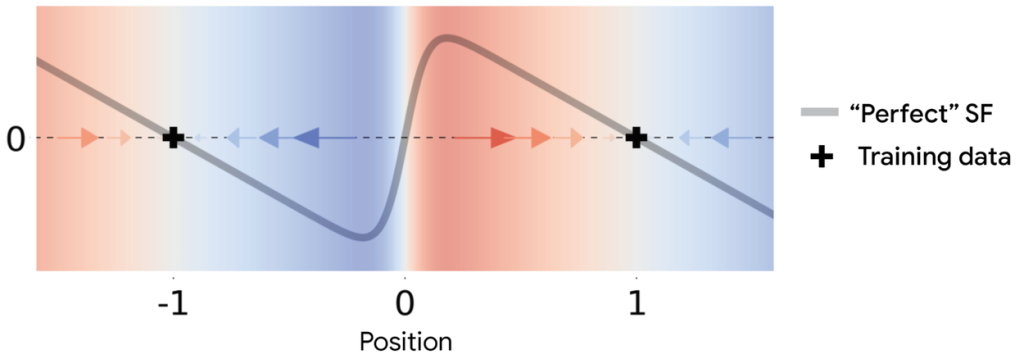
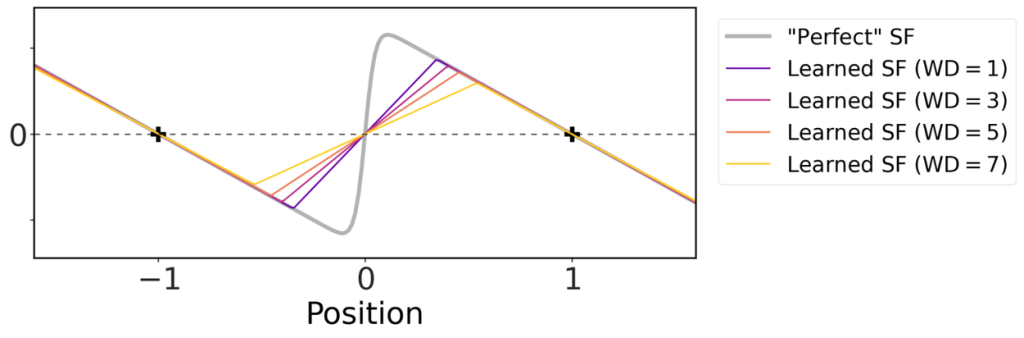
しかし実際のニューラルネットワークは、weight decayのような正則化の影響を受けるため、急激に変化する「完璧な」スコア関数をそのまま学習することが難しいとされています。研究チームによれば、正則化の結果として学習されるスコア関数はやや滑らかになり、この現象を「スコア平滑化」と呼んでいます。1次元の簡易な実験(訓練データ点が2つだけの世界)では、正則化の度合いを強めるほどスコア関数の中間領域が滑らかになり、粒子は2つの訓練点の「間」に位置する補間ゾーンに落ち着きやすくなることが確認されました。
こうした振る舞いは、単純化された1次元の設定で観察された結果です。実際の画像データはより高次元かつ複雑な構造を持つため、実用上の効果を評価するには追加の検証が必要だと考えられます。
高次元データでの「マニフォールド回復」
高解像度の画像のような複雑なデータは、高次元のピクセル空間のうちごく一部にしか存在しません。この意味のあるデータが集まる領域は「データ多様体(マニフォールド)」と呼ばれています。画像生成は、限られた訓練データからこの隠れた多様体の形を推測し、その上に新しい点を見つける「マニフォールド回復」の課題だと捉えることができます。
研究チームによれば、多次元設定においてスコア平滑化の効果は方向によって異なります。多様体に沿う(接する)方向では1次元の場合と同様に粒子の動きが遅くなる一方、多様体に向かう方向ではもともとスコア関数が滑らかなため、追加の平滑化はほとんど影響しません。この結果、粒子が多様体に到達する動きは妨げられず、訓練データ点へ完全に収束する動きだけが抑えられるため、生成された画像は自然さと新規性を両立できると説明されています。この仕組みは、画像生成だけでなく分子設計のような他分野の応用にも関係する可能性があると考えられます。
実装・コードの公開について
研究チームは、論文の図を再現するために使った数値実験のコードをGitHubで公開しています。リポジトリにはColabノートブック形式の実験コードが含まれていますが、公式な利用ガイドやAPIとしての提供ではなく、あくまで論文の再現用途を想定した公開です。数式やスコア関数の挙動を実際に確認したい読者にとっては、理論の理解を深める手がかりになると考えられます。
まとめ
拡散モデルの「創造性」は、学習時の正則化がスコア関数を滑らかにすることで生まれる、数学的に説明可能な現象であることが示されました。拡散型モデルの仕組みについては、過去記事でも整理していますので、あわせてご覧いただければと思います。