はじめに
Googleが2026年6月10日、新しい実験的オープンモデル「DiffusionGemma」を発表しました。本稿では、この発表内容をもとに、テキスト拡散(text diffusion)という新しいアプローチの仕組みと、開発者が実際に試す方法について解説します。
参考記事
- タイトル: DiffusionGemma: 4x faster text generation
- 著者: Brendan O’Donoghue, Sebastian Flennerhag
- 発行元: Google (Google Blog)
- 発行日: 2026年6月10日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/diffusion-gemma-faster-text-generation/
関連記事
要点
- DiffusionGemmaは、テキストを1トークンずつ逐次生成する従来の自己回帰型(autoregressive)モデルとは異なり、256トークンのブロックを並列に生成する実験的モデルである
- Apache 2.0ライセンスで公開された26B規模のMixture of Experts(MoE)モデルであり、推論時には3.8Bパラメータのみが活性化される
- 単一のNVIDIA H100で1000トークン/秒以上、RTX 5090で700トークン/秒以上という生成速度を記録し、自己回帰型のGemma 4と比較して最大4倍の高速化を実現する
- 双方向注意(bi-directional attention)機構により、コードのインフィル編集や数式処理など非線形なタスクに強みを持つ
- Hugging Face、vLLM、MLX、NVIDIA NeMoなど複数のツールで利用可能で、量子化によりコンシューマー向けGPUでも動作する
詳細解説
テキスト拡散モデルとは
Googleの発表によれば、DiffusionGemmaは「テキスト拡散(text diffusion)」と呼ばれる手法を採用した実験的モデルです。Gemma 4ファミリーをベースに、Gemini Diffusion研究の知見を組み込んだ拡散ヘッドを統合しており、26Bパラメータを持つMixture of Experts(MoE、複数の専門ネットワークを切り替えて使うアーキテクチャ)構造で、推論時に活性化されるのは3.8Bパラメータのみとされています。
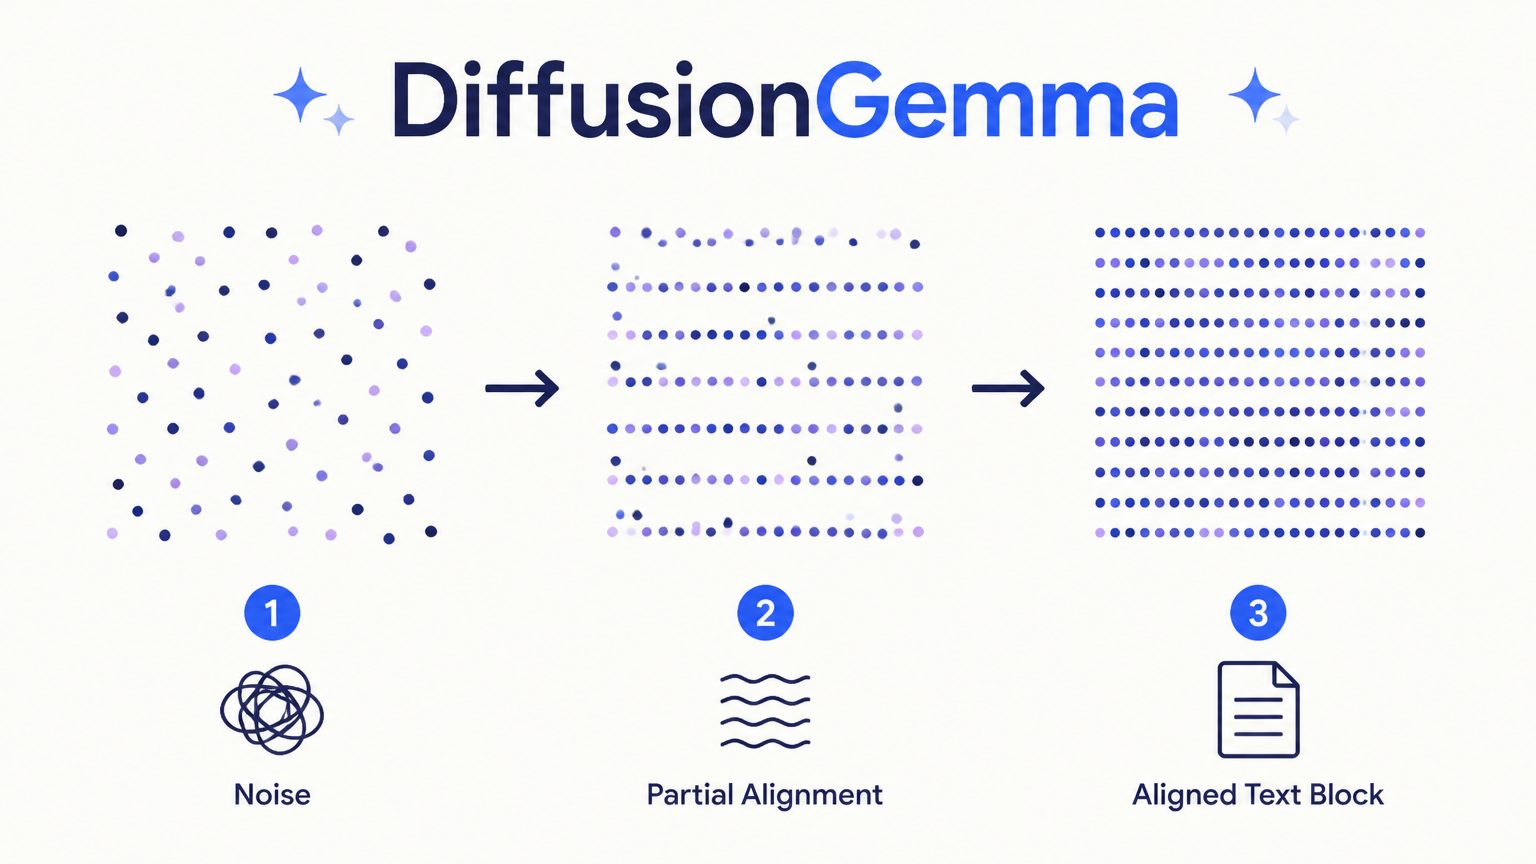
拡散モデルというと、画像生成AIで「ノイズから徐々に画像を生成する」手法として知られていますが、DiffusionGemmaはこの考え方をテキスト生成に応用したものです。具体的には、ランダムなプレースホルダートークンで構成された「キャンバス」から始まり、複数回の処理を経て正しいトークンを確定させながら全体を refine していくという流れになります。最終的に高品質な出力に収束する仕組みです。
生成速度と仕組み
従来の自己回帰型LLMは、タイプライターのように1トークンずつ左から右へ生成します。クラウド環境では多数のリクエストをバッチ処理できるため効率的ですが、ローカル環境で単一ユーザーが利用する場合、GPUは次のトークンを待つ時間が多くを占め、ハードウェアを十分に活用できないという課題がありました。
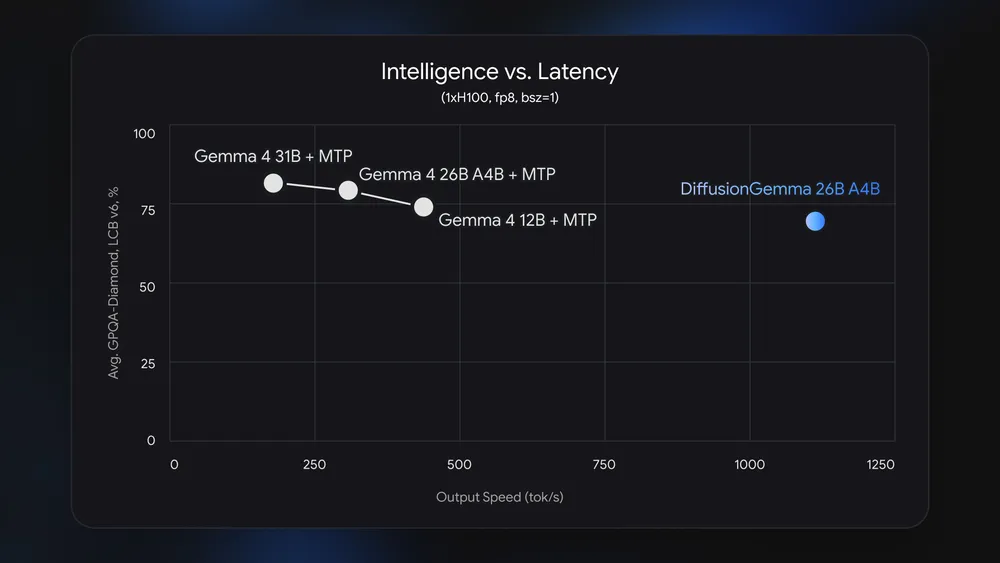
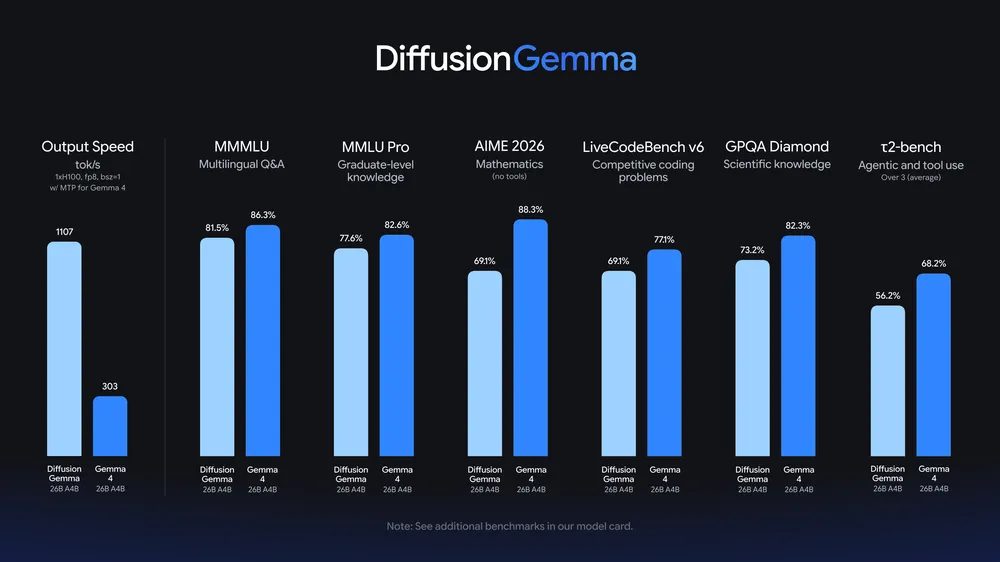
Googleによれば、DiffusionGemmaは256トークンの段落を一度に生成することでこの課題に対応し、単一のNVIDIA H100で1000トークン/秒以上、RTX 5090で700トークン/秒以上の生成速度を記録しています。これは、印刷で言えば1文字ずつ打つタイプライターから、ページ全体を一度に刷る印刷機への転換に近いイメージだと思います。
ただし、この高速化はローカル環境や低同時実行数の場合に特に有効とされています。クラウドでの高QPS(Queries Per Second)なサービングでは、自己回帰型モデルが既にハードウェアを効率的に飽和させられるため、並列デコードの優位性は薄れ、コスト面でも不利になる可能性があるとされています。また、Apple Siliconのような統合メモリアーキテクチャは、推論時にメモリ帯域幅がボトルネックになりやすく、自己回帰型モデルと同等の高速化が得られない場合があるとも説明されています。
双方向注意とユースケース
DiffusionGemmaの特徴のひとつが、双方向注意(bi-directional attention)です。各フォワードパスで256トークンを並列に生成するため、各トークンが他のすべてのトークンを参照できます。Googleの発表では、これによりコードのインフィル編集(既存コードの間に新しいコードを挿入する作業)、アミノ酸配列、数式のグラフといった非線形なドメインで大きな利点があるとされています。
また、モデル自身が出力全体を見渡しながら誤りをリアルタイムで修正する「自己修正」機能も備えています。一例として、Unsloth(効率的なファインチューニングツールを提供する企業)がDiffusionGemmaを数独タスク向けにファインチューニングした事例が紹介されており、各セルが他のすべてのセルの値に依存するため自己回帰型モデルが苦手とする数独のような問題に、双方向注意が有効だと説明されています。
なお、Googleは現時点でDiffusionGemmaを実験的なモデルと位置づけており、出力品質は標準のGemma 4と比較して劣るとされています。最大限の品質が求められる本番用途には、標準のGemma 4の利用が推奨されています。この点は、速度と品質のトレードオフとして理解しておく必要があると思います。
環境構成・利用可能なツール
DiffusionGemmaの重みは、Apache 2.0ライセンスのもとHugging Faceで公開されています。利用には以下のような複数の選択肢が用意されています。
- モデルの取得: Hugging Face Transformers (google/diffusiongemma-26B-A4B-it)
- サービングエンジン: vLLM(Red Hatによる統合サポートあり)、MLX(Apple Silicon向け)
- ファインチューニング: Hackable Diffusion(Googleが公開したJAXベースのモジュール式ツールキット)、Unsloth、NVIDIA NeMo
- クラウド実行: Gemini Enterprise Agent Platform Model GardenまたはNVIDIA NIM
Googleの発表によれば、NVIDIAとの協業によりハードウェア最適化も進められており、コンシューマー向けのRTX 5090・4090では量子化対応、エンタープライズ向けのHopper・Blackwellアーキテクチャでは高度なNVFP4(4bit浮動小数点)カーネルが利用可能とされています。NVFP4のネイティブサポートにより、精度をほぼ落とさずに計算スループットを高速化できるとのことです。なお、llama.cppへの公式対応も近く提供される予定とされています。
前提条件・環境構成
実際にDiffusionGemmaを試す場合、以下の点を確認しておくとよいと思います。
- ハードウェア: 26B総パラメータ・3.8B活性化パラメータのMoE構造のため、量子化すれば18GB VRAM程度の高性能コンシューマー向けGPU(RTX 4090・5090クラス)で動作するとされています
- ライセンス: Apache 2.0のため商用利用を含め柔軟に利用できます
- 推論方式の選択: vLLMやMLXなど、利用環境(Linux/Mac、GPUの種類)に応じて適切なサービングエンジンを選ぶ必要があります
注意: vLLMやNeMoなどのツールは、それぞれ別途のインストール・セットアップ手順が必要です。各ツールの公式ドキュメント(vLLM、Unsloth、NVIDIA NeMoのDiffusionGemma対応ガイド)を確認しながら進めることをおすすめします。
Gemma 4との関係
Googleは2026年4月にGemma 4を公開しており、パラメータ効率の高いオープンモデルファミリーとして展開してきました。DiffusionGemmaはこのGemma 4をベースにしており、標準のGemma 4が高品質な本番出力の標準として位置づけられる一方、DiffusionGemmaは速度を優先した実験的な選択肢として提供されている形です。用途に応じてどちらを使うかを選べる構成になっていると言えます。
まとめ
DiffusionGemmaは、テキストをブロック単位で並列生成する拡散モデルのアプローチを大規模オープンモデルに適用した事例として注目されます。ローカルでの対話的な編集作業など、速度が重視される用途での活用が見込まれます。一方で品質面では標準のGemma 4が優位とされており、用途による使い分けが重要だと思います。テキスト拡散の研究的背景については、Gemini Diffusionの紹介記事もあわせてご覧いただければと思います。