はじめに
Google ResearchのZorik GekhmanとJonathan Herzigらが2026年6月24日、大規模言語モデル(LLM)が思考プロセスを生成するだけで単純な事実問題の正答率が向上する現象を調査した研究を発表しました。本稿では、この研究が明らかにした2つのメカニズムと、ハルシネーション抑制への示唆を解説します。
参考記事
- タイトル: Thinking to recall: How reasoning unlocks parametric knowledge in LLMs
- 著者: Zorik Gekhman, Jonathan Herzig(Google Research)
- 発行元: Google Research Blog
- 発行日: 2026年6月24日
- URL: https://research.google/blog/thinking-to-recall-how-reasoning-unlocks-parametric-knowledge-in-llms/
関連記事
要点
- 推論(chain-of-thought)が有効なとき、LLMは複雑な計算が不要な単純な一問一答においても正答率が向上することが実験で確認された
- この現象を引き起こすメカニズムは「計算バッファ効果」と「事実的プライミング」の2つである
- 推論トレース中に 1件でも 誤った中間事実(ハルシネーション)が含まれると、最終回答の正答率が大幅に低下する
- テスト時に検証可能な事実のみを含む推論トレースを優先選択することで、精度が向上することが示された
詳細解説
なぜ「考えるだけ」で正答率が上がるのか
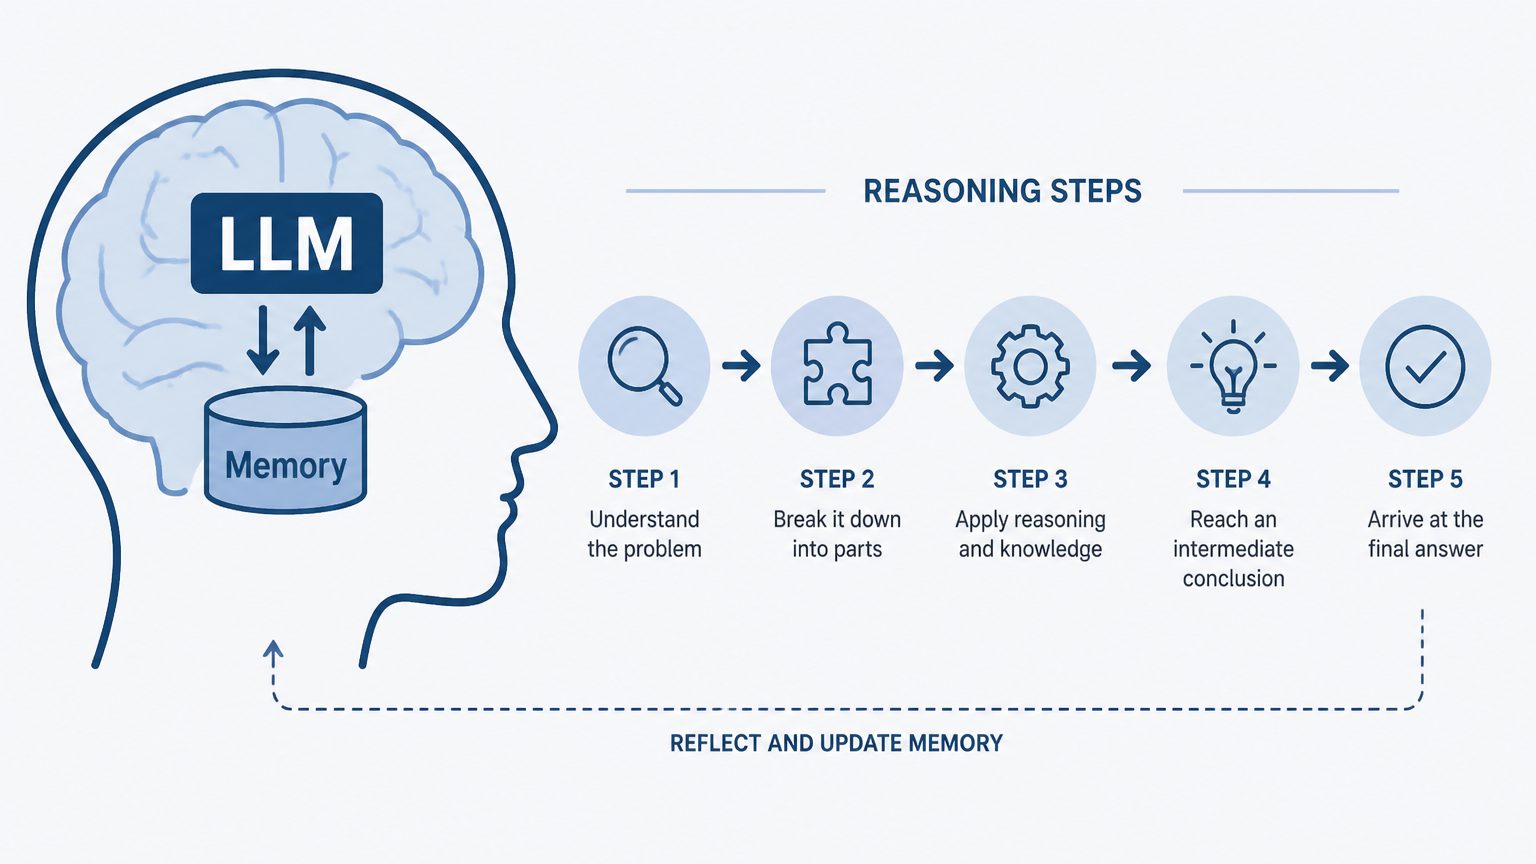
LLMが段階的な思考(chain-of-thought, CoT)を生成することで、数学の計算や複数ステップの推論を要する問題の精度が向上することは広く知られています。しかし、「Mary Engle Pennington が National Inventors Hall of Fame に殿堂入りしたのは何年か」のような単純な一問一答では、論理的な推論は不要です。モデルの重みにその事実が記憶されているか否かがすべてであり、思考プロセスを生成する意義は理論上ないはずです。
Google Researchの今回の研究は、この直感に反する現象を定量的に検証しました。評価には、推論の ON/OFF を切り替えられる推論特化型 LLM(R-LLM)を使用し、Gemini 2.5 Flash・Gemini 2.5 Pro・Qwen3-32B の3モデルを対象にしています。評価指標として pass@k を採用しており、上位1件の回答だけでなく複数の生成候補の中に正答が存在するかを確認することで、モデルが原理的に持っている知識の「到達可能な上限」を測定できます。
実験の結果、推論を有効にしたとき、推論なしでは事実上回収不可能だった正答がモデルの出力分布から浮かび上がることが、3モデルすべてで一貫して確認されました。この改善は問題の複雑さを分解したからではなく、意図的に単純な一問一答のデータセット(SimpleQA VerifiedおよびEntityQuestions)に絞って評価した結果であるため、推論そのものが記憶の引き出しを助けていると考えられます。
メカニズム1:計算バッファ効果
第一の仮説は、追加のトークンを生成することが「計算時間の延長」として機能するというものです。研究チームはこれを検証するため、モデルが生成した推論トレースを「Let me think」という無意味な文字列の繰り返しに差し替え、元の推論トレースと同じトークン長になるように調整して最終回答を生成させました。
この「ダミー推論」条件でも、推論を完全にオフにした場合と比べて正答率が有意に向上しました。つまり、生成された内容の意味とは独立して、追加のトークン生成そのものがモデルの内部状態を調整し、届きにくい記憶を引き出す助けになっていることが示されました。
ただし、ダミーテキストを長くしても効果は逓減し、自然な推論トレースには及ばなかったとGoogle Researchは報告しています。計算バッファは必要条件のひとつですが、それだけでは不十分であり、推論の「内容」も重要だということです。
メカニズム2:事実的プライミング
第二のメカニズムは人間の認知科学における「拡散的活性化(spreading activation)」に着想を得たものです。あるキーワードを処理すると、それと意味的に関連する概念が記憶内で活性化され、より引き出しやすくなる現象です。研究チームは、LLMの推論トレースにも同様の「事実的プライミング」が起きていると仮説を立てました。
これを検証するために、モデルが推論トレース中に挙げた具体的な事実のみを厳密にフィルタリングして抽出し、それを元の推論トレースの代わりにモデルへ与えました。その結果、短い事実リストを提示するだけで推論トレース全体を使ったときとほぼ同等の効果が得られ、推論をオフにした場合でも精度向上に貢献しました。
研究が示す具体例として、「ネパール第10代国王の名前は?」という問いに対し、推論モデルは第1代から第9代の王を順番に挙げていきます。この連続的な事実想起が「意味的な準備運動」として機能し、第10代の名前を正しく引き出すためのプライミングになるというわけです。事実自体が記憶の踏み台になっているというこの発見は、シンプルながら重要だと思います。
ハルシネーションが精度を下げるリスク
事実的プライミングは強力なメカニズムですが、根本的なリスクも伴います。モデルが中間事実を自ら生成するため、その事実が誤っている(ハルシネーション)可能性があります。
研究チームは、検索機能付きの検証システムを用いた大規模な監査パイプラインを構築し、数十万件の推論トレース中の中間事実を独立に検証しました。結果は明確でした。推論トレース中に 1件でも ハルシネーションが含まれていると、最終回答が正答になる確率が大幅に低下したのです。これは、事実的プライミングが「正しい事実を踏み台にする」という条件付きのメカニズムであることを示しています。誤った踏み台は、正しい記憶の想起を妨げると考えられます。
精度改善への応用可能性
この知見は実用的な示唆も持ちます。テスト時の戦略として、1つの問いに対して複数の推論トレースを生成し、検証可能で正確な事実のみを含むトレースを優先選択する方法が有効であることが示されました。
さらに長期的には、中間ステップで事実的に正確な推論を行うことを奨励するプロセス報酬(process rewards)を訓練に組み込むことで、より信頼性の高いモデルを構築できる可能性があると、Google Researchは述べています。モデルの「考え方」そのものを改善するアプローチとして、今後の研究が注目されます。
まとめ
Google Researchの今回の研究は、LLMにおける推論の役割が「問題分解」だけでなく、「記憶の引き出し」にも及んでいることを示しています。計算バッファと事実的プライミングという2つの発見は、ハルシネーション抑制の研究にも新たな視点を与えるものだと思います。LLMの記憶と推論の関係についてより詳しく知りたい方は、人間の脳とLLMの効率比較を論じた過去記事もあわせてご覧いただければと思います。