はじめに
Microsoft Researchが2026年6月25日、AIを活用して大脳皮質の機能を言語で説明し、そのまま実験で検証するフレームワーク「Generative Causal Testing(GCT)」を発表しました。UC Berkeley・UCSF・コロンビア大学との共同研究として Nature Neuroscience に採択されています。
参考記事
- タイトル: Understanding the brain with AI-driven explanations and experiments
- 著者: Chandan Singh(シニアリサーチャー)、Jianfeng Gao(テクニカルフェロー&コーポレートバイスプレジデント)
- 発行元: Microsoft Research Blog
- 発行日: 2026年6月25日
- URL: https://www.microsoft.com/en-us/research/blog/understanding-the-brain-with-ai-driven-explanations-and-experiments/
関連記事
要点
- LLMは人間の脳のfMRI反応を高精度で予測できるが、その予測根拠は膨大なパラメータに埋もれており、「なぜその領域が反応するか」を科学的に説明できない課題があった
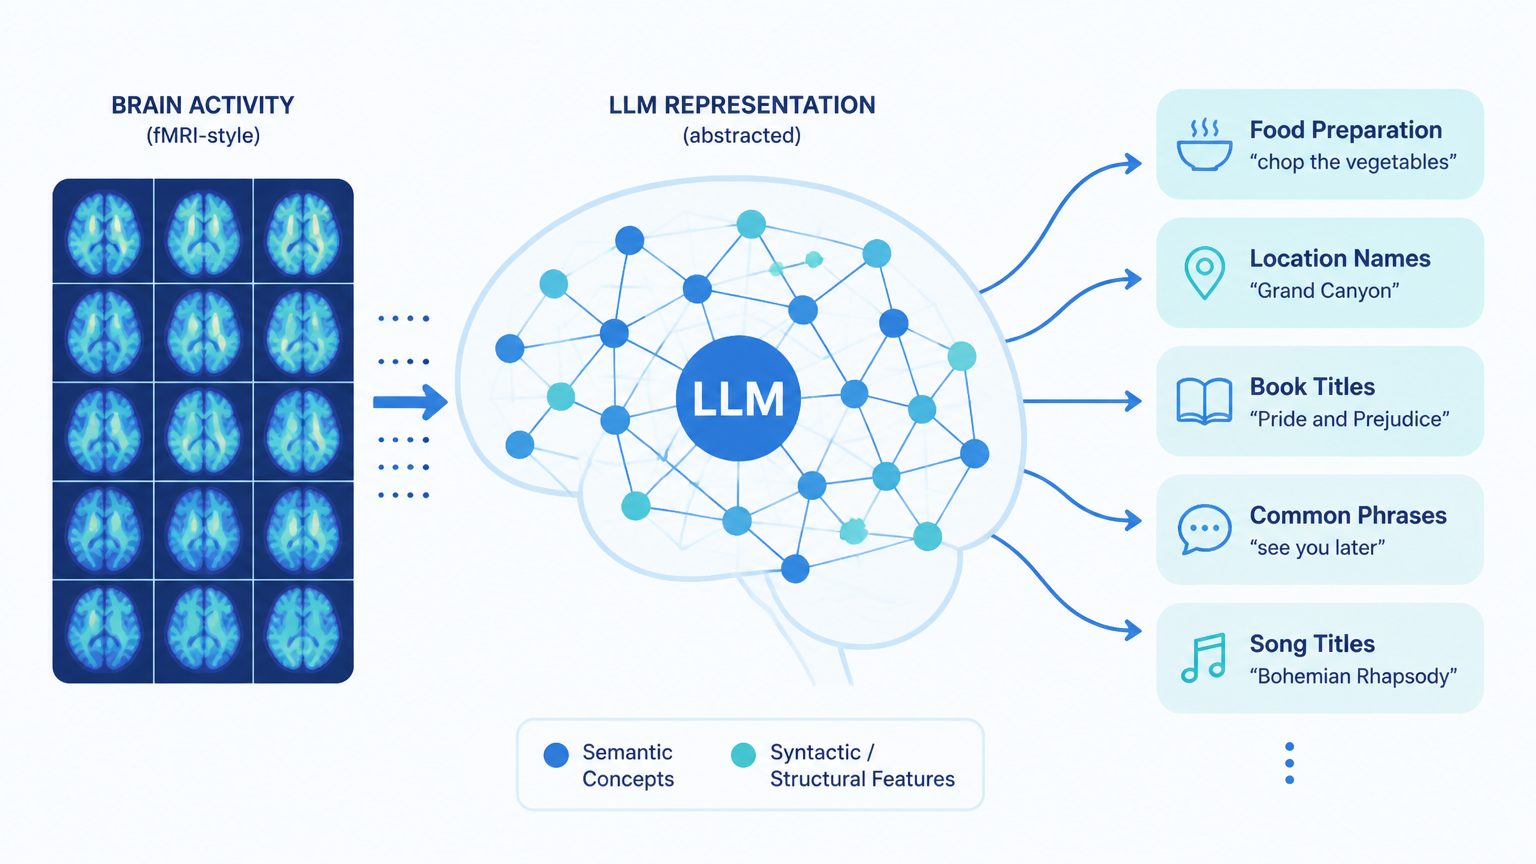
- GCTは予測モデルから「食品調理」「場所の名前」のような短い言語説明を自動生成し、LLMがその説明に基づいた新しい物語文を作成してfMRIで実際に検証するという閉ループ構造をとる
- 既知の場所処理領域(RSC・PPA・OPA)を差分刺激で機能的に区別することに成功し、RSCが固有名詞の地名(「東京」「コネチカット」など)に特異的に反応することを確認した
- 前頭前皮質に「対話」「時刻表現」「数値計測」に特化したマイクロ領域が新たに発見された
- GCTのアプローチは神経科学に限らず、予測精度は高くても説明できないAIモデルが広がるあらゆる分野に応用できる可能性がある
詳細解説
「予測できるが説明できない」という問題
過去10年で、LLMは人間が物語を聞いたときの脳反応を個々の皮質領域レベルで予測する最も精度の高いツールになりました。しかし、この能力はあくまで「何かを捉えている」ことを示すにすぎず、「何を捉えているか」の説明は含まれていません。モデルの内部は数百万のパラメータの集合体であり、「この領域は食べ物に反応する」「あの領域は場所に反応する」といった科学的命題に直接変換できないのです。
Microsoft Researchによれば、この予測と理解の乖離が計算神経科学における中心的な課題になっています。GCTはこの「ブラックボックス問題」を、「予測モデル → 言語説明 → 実験検証」という閉ループで解消しようとする試みです。
GCTの仕組み:2ステップの説明・検証サイクル
GCTは大きく2段階で動作します。
Step 1(説明の生成):まず、ある皮質領域の予測モデルに対して、その応答を最も強く引き起こす短いフレーズを特定します。次にLLMがそれらのフレーズを「食品調理(food preparation)」「場所の名前(location names)」のような簡潔な言語説明にまとめます。
Step 2(因果的検証):得られた説明をLLMへのプロンプトとして与え、その説明に沿った新しい物語文を生成させます。被験者がこれをfMRIスキャナー内で聴取したとき、対象領域の活動がベースラインより有意に高まれば、説明は「単なる相関」ではなく「因果的に正しい」と判断できます。
論文によれば、3名の被験者で検証したところ、GCTが生成した「ドライビングストーリー」はいずれも対象領域をベースライン以上に活性化させることが確認されました。また、元の予測モデルの精度が高い領域ほど、説明の信頼性も高くなるという一貫した傾向が見られたとのことです。
既知の知見を再確認し、未解決の問題を整理
GCTの有効性が確認された後、研究チームは長年の懸案に取り組みました。場所処理に関わる3つの隣接領域——RSC(後帯状皮質)、PPA(海馬傍回場所野)、OPA(後頭葉場所野)——は機能的に似ていると見なされることが多く、区別が難しいとされてきました。
最初は3領域への刺激が互いを活性化してしまいましたが、研究チームは「差分刺激(differential stimuli)」、つまり1つの領域だけをオンにして隣接領域を抑制するよう設計した物語を生成させることで、それぞれの違いを浮き彫りにしました。例えばRSCは、「場所」という一般的なカテゴリではなく、「東京」「コネチカット」のような固有名詞の地名に特異的に反応することが示されました。これは従来の手法では得にくい、領域固有の細かな理論です。
また、GCTは「食品調理」が腹側後頭皮質の紡錘状顔面野(FFA)近傍の領域を活性化することを独立に確認するなど、既存の研究知見との整合性も示しています。
前頭前皮質に「マイクロ領域」を発見
さらに注目すべき成果として、Microsoft Researchは前頭前皮質に従来未発見だった複数の「マイクロ領域」を発見したと報告しています。GCTが候補場所のグリッドをスキャンし、安定性の高い領域のみを保持する形で絞り込んだ結果、非常に特異的な概念に選択的な神経集団が存在することが明らかになりました。
具体的には、人物間の対話(「said」「told」などの語)、時刻表現(「one o’clock」など)、数値計測(「50 feet」など)にそれぞれ特化した領域が見つかっています。これらは事前に仮説を持って探したわけではなく、GCTの「仮説生成→即時検証」という構造によって自然に浮かび上がってきたものです。この点は、ターゲットを絞った従来の実験デザインでは見落とされがちだった領域の存在を示唆していると考えられます。
神経科学を超えた意味
Microsoft Researchは、GCTの意義は神経科学にとどまらないと述べています。「予測はできるが説明できない」モデルが急速に普及している今、データ駆動モデルを人間が読める検証可能な仮説へと変換するというアプローチは、他の科学領域にも移植できると考えられます。
「ブラックボックスモデルの台頭が、必ずしも人間が読める理論の後退を意味するわけではない。適切なフレームワークがあれば、両者は同時に前進できる」——これが論文の示す最も広いメッセージだと思います。
まとめ
GCTは、LLMの予測能力を「科学的に検証可能な仮説の生成装置」として再定義した点で、神経科学研究の手法論に新しい選択肢を加えたと言えます。同様のアプローチが広がれば、AIモデルの説明可能性と科学的探究の両立という課題に対する一つの実践的な回答になると思います。脳とAIの関係性についてより幅広く知りたい方は、脳の効率性とLLMの関係を論じた過去記事もあわせてご覧いただければと思います。