はじめに
Googleが2026年6月26日、Pixel 9・10シリーズ搭載のGemini Nano v3に対して、学習済みモデルを凍結したまま Multi-Token Prediction(MTP) ヘッドを後付けする高速化手法を公開しました。本稿では、その仕組みと実際の性能改善について解説します。
参考記事
- タイトル: Accelerating Gemini Nano models on Pixel with frozen Multi-Token Prediction
- 著者: Eden Cohen(Research Product Manager)、Michelle Ramanovich(Research Manager)、Google Platforms and Devices
- 発行元: Google Research Blog
- 発行日: 2026年6月26日
- URL: https://research.google/blog/accelerating-gemini-nano-models-on-pixel-with-frozen-multi-token-prediction/
関連記事
要点
- Gemini Nano v3の重みを凍結したまま、軽量なMTPヘッドを後付けすることで、モデル本体の品質や安全性を損なわずに推論速度を向上させる手法である
- MTPヘッドがメインモデルのKVキャッシュを直接参照する「ゼロコピーアーキテクチャ」により、独立型ドラフターと比較してメモリ使用量を最大130MB削減できる
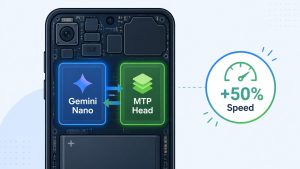
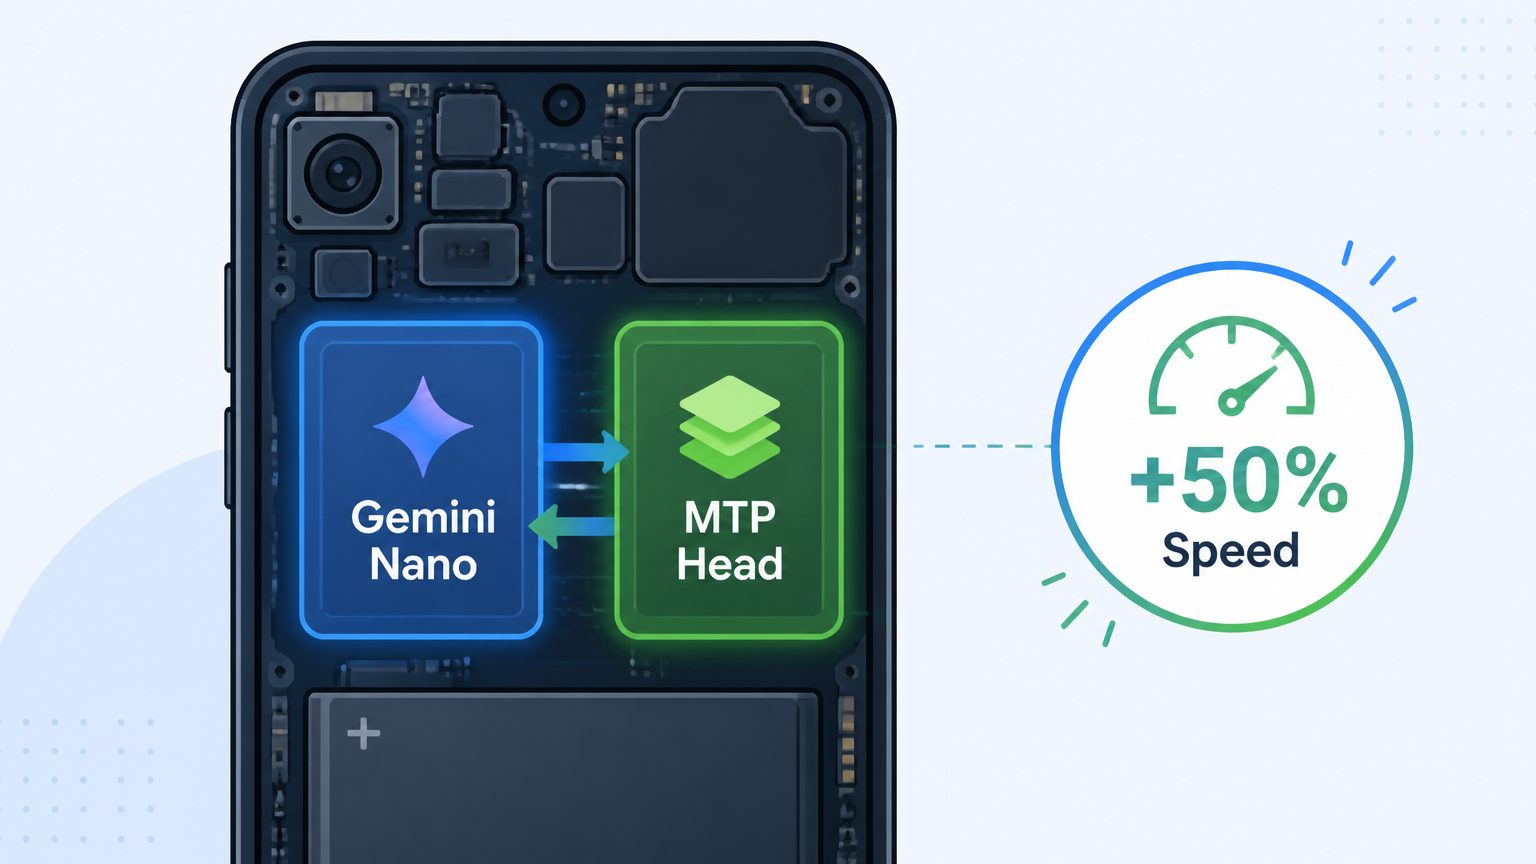
- Pixel 9デバイスにおいて、タスクによっては独立型ドラフターと比べて50%以上の高速化を達成し、スマートリプライでは最大55%のトークン受理率改善が確認されている
- AI通知要約やProofread機能など本番ワークロードで、1回の推論パスあたり平均約2トークンの追加予測に成功しており、バッテリー消費の削減にも寄与している
詳細解説
オンデバイスAIが抱えるボトルネック
スマートフォン上でLLMを動かす場合、サーバー環境とは異なる厳しい制約が課されます。メモリ(RAM)の上限が小さく、処理できるエネルギー量も限られているためです。さらに、標準的な言語モデルは「自己回帰的」にテキストを生成します——つまり、1ステップごとに1トークンずつ出力する方式です。このステップバイステップの処理がボトルネックを生み、プロセッサの処理能力を十分に活かせないまま、メモリ帯域幅を圧迫します。
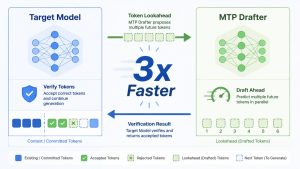
Googleはこの課題に対して、投機的デコーディング(Speculative Decoding) と呼ばれるアプローチを進化させてきました。投機的デコーディングでは、小さな「ドラフターモデル」が複数トークンの候補を先読みし、大きなメインモデルが並列で検証します。候補が正しければまとめて採用できるため、処理ステップを減らせます。ただし、独立したドラフターモデルを別途用意する従来方式には問題がありました——ドラフターが独自のメモリを消費する上に、メインモデルの内部状態を参照できず、精度が制限されていたのです。
凍結バックボーンへの後付けアプローチ
今回Googleが発表したMTP手法は、学習済みのGemini Nano v3の重みを凍結(freeze) したまま、軽量なTransformerブロック(MTPヘッド)を最終層に取り付けるものです。MTPヘッドのパラメータのみを追加学習し、バックボーン側は一切変更しません。
この設計には重要な意味があります。メインモデルの品質や安全性アライメントは保たれたまま、推論効率だけを後から改善できるためです。さらに、誤った候補トークンは検証時に破棄される仕組みのため、最終出力はメインモデルが単独で生成した場合とビット単位で一致します。つまり、出力品質を犠牲にすることなく速度だけを向上させられる、後方互換性の高い手法だと考えられます。
Gemma 4でもMTPドラフターによる高速化が実装されましたが、あちらはバックボーンとMTPヘッドを同時に事前学習する方式でした。今回の手法はすでに本番展開済みのモデルに後から適用できる点で異なります。
ゼロコピーアーキテクチャでメモリを節約
モバイル環境で独自にKVキャッシュを持つ独立型ドラフターは、メモリの「二重課税」を引き起こします。KVキャッシュとは、過去のトークンに対するアテンション計算結果を保存しておく仕組みで、推論速度の要となるものです。独立ドラフターはメインモデルとは別にこのキャッシュを確保・維持するため、限られたモバイルRAMをさらに圧迫します。
これに対してGoogleが設計したMTPヘッドは、メインモデルのKVキャッシュにクロスアテンションする方式を採用しています。自身でキャッシュを持たず、バックボーンが計算済みの「記憶」をそのまま参照します。Googleによれば、この設計によりドラフタープリフィルのレイテンシがなくなるとともに、独立型ドラフターと比較してインスタンスあたり最大 130MB のメモリ削減を実現しています。
独立型ドラフターより精度が高い理由
メインモデルの最終層の活性化(隠れ状態)を直接入力として受け取るMTPヘッドは、メインモデルをブラックボックスとして扱う独立型ドラフターに比べてはるかに豊かな表現を利用できます。Googleの実験によれば、Pixel 9デバイスでタスクによっては独立型ドラフターと比べて 50%以上 の速度向上を達成しました。
タスク別の内訳も公開されています。要約や複雑な制約付き書き換えなど指示追従が求められるタスクでは独立型ドラフターを大きく上回り、スマートリプライのように構造的な予測可能性が高いタスクでは 55% のトークン受理率改善が確認されています。
本番環境での効果
Pixel 9・10シリーズへの展開後、AI通知要約やProofreadといった本番ワークロードで、1回の推論パスあたり平均約2トークンの追加予測に成功しているとGoogleは報告しています。検証ステップが減ることで重いプロセッサを起動する頻度も下がり、バッテリー消費の削減と応答速度の改善を同時に達成しています。
今後はPixelの次世代デバイスへの展開に加えて、補助ヘッドを使わない並列デコーディングなどの代替アーキテクチャも研究中とのことです。また、厳密なトークン一致を前提とする現在の検証方式を緩和し、特定用途ではより多くのトークンを受理できる「検証寛容度」の研究も進めているとしています。
まとめ
Googleが今回公開した手法は、既存の本番モデルを再学習なしに高速化できる点で実用的な意義があります。MTPヘッドの後付けという発想は、オンデバイスAIの制約下で品質を維持しながら速度を追求する一つの方向性を示していると思います。オンデバイスAIの推論効率に関心がある方は、LiteRTのリリース記事もあわせてご覧いただければと思います。