はじめに
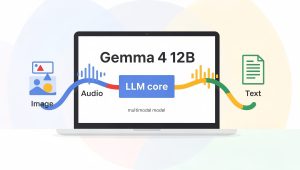
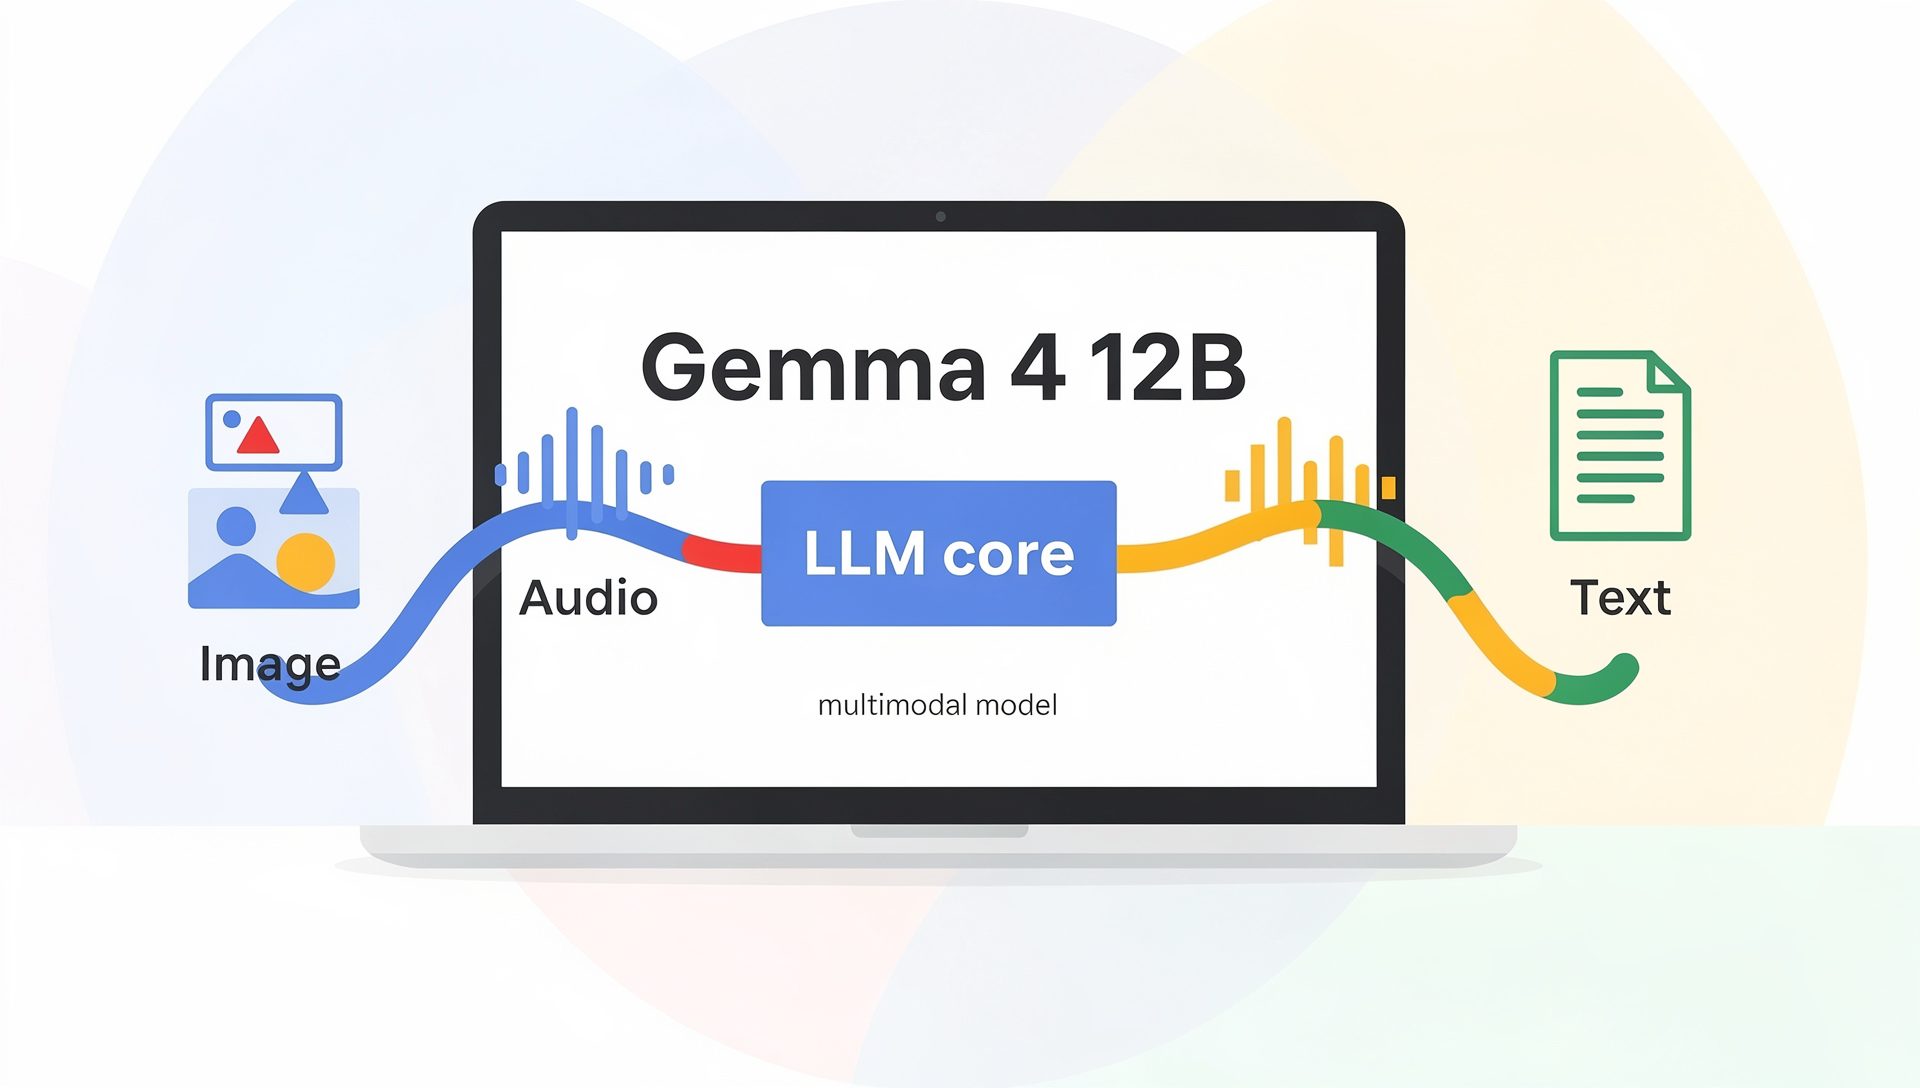
GoogleとGoogle DeepMindが2026年6月3日、新しいオープンモデル「Gemma 4 12B」を発表しました。視覚・音声・テキストをエンコーダーなしで統合処理する独自アーキテクチャを採用し、16GBのVRAMで動作するラップトップ対応モデルです。本稿では、その技術的特徴と開発者向けの利用方法を解説します。
参考記事
- タイトル: Introducing Gemma 4 12B: a unified, encoder-free multimodal model
- 著者: Olivier Lacombe(Director of Product Management, Google DeepMind)、Gus Martins(Product Manager, Google DeepMind)
- 発行元: Google Blog(Developers Tools)
- 発行日: 2026年6月3日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemma-4-12b/
関連記事
要点
- Gemma 4 12Bは、視覚・音声入力を専用エンコーダーなしにLLMバックボーンへ直接統合する、エンコーダーフリーの統合アーキテクチャを採用したモデルである
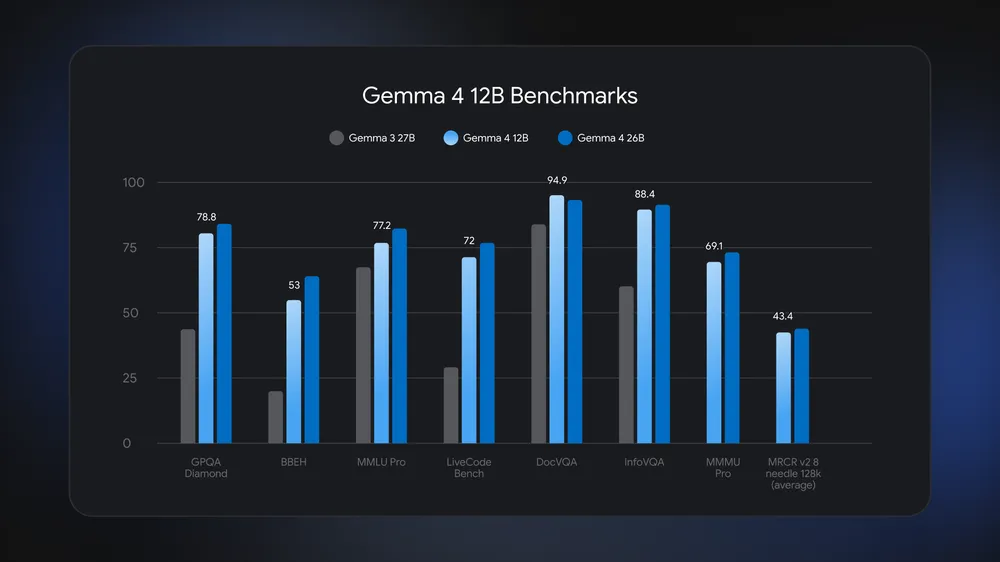
- 26B MoEモデルに匹敵するベンチマーク性能を持ちながら、メモリフットプリントは半分以下であり、16GBのVRAMまたは統合メモリを持つラップトップで動作する
- Gemmaシリーズとして初めてネイティブ音声入力に対応しており、音声エンコーダーを排除してオーディオ信号をテキストトークンと同じ次元空間に直接投影する
- Multi-Token Prediction(MTP)ドラフターを搭載しており、推論レイテンシを低減できる
- Apache 2.0ライセンスで公開されており、Hugging Face、Kaggle、LM Studio、Ollamaなど主要プラットフォームからすぐに利用できる
詳細解説
Gemma 4 12Bの位置づけと背景
GoogleはGemmaシリーズのオープンモデルを継続的に展開しており、2026年4月にGemma 4を公開しました。今回の12Bモデルは、軽量なEdge 4B(E4B)と大型の26B Mixture of Experts(MoE)の中間に位置するモデルです。Googleによれば、Gemma 4シリーズは現在までに1億5,000万ダウンロードを超えており、ウェアラブルロボットアームや企業向けセキュリティなど多様な用途での活用が進んでいます。
また、Gemmaシリーズとして初めて中型モデルでのネイティブ音声入力対応を実現した点も注目に値します。
エンコーダーフリーの統合アーキテクチャ
Gemma 4 12Bの最大の技術的特徴は、マルチモーダル処理におけるエンコーダーを排除した設計にあります。従来のマルチモーダルモデルでは、画像や音声をLLMに入力する前に専用のエンコーダーがモダリティごとに処理を行うのが一般的でした。この分離型エンコーダーは処理のレイテンシ増加とメモリ使用量の増大をもたらすことが課題とされてきました。
Googleは、Gemma 4 12Bでこのアーキテクチャを刷新しています。
視覚処理の変更点:
Gemma 4の視覚エンコーダーは、1つの行列乗算・位置埋め込み・正規化のみからなる軽量な埋め込みモジュールに置き換えられています。これにより、視覚処理の主体がLLMバックボーン自体に移ります。行列乗算(Matrix Multiplication)とは、入力データを別の表現空間に変換する基本的な線形変換です。
音声処理の変更点:
音声処理ではさらに踏み込んだ設計が採用されており、音声エンコーダー自体を完全に排除しています。生のオーディオ信号をテキストトークンと同じ次元空間に直接投影することで、音声もテキストと同様にLLMバックボーンが処理します。この方式によりオフライン環境での音声処理も実現されており、Googleの「Google AI Edge Eloquent」アプリではラップトップ上でのオフライン文字起こし・翻訳がデモされています。
ベンチマーク性能とハードウェア要件
Googleの発表によれば、Gemma 4 12Bは標準ベンチマークにおいて26B MoEモデルに匹敵する性能を発揮しています。一方、総メモリフットプリントは26Bの半分以下とされており、16GBのVRAMまたは統合メモリ(Apple Siliconのような統合メモリアーキテクチャを含む)を持つ一般的なコンシューマーラップトップでの動作が可能です。
ローカルでの動作については、GemmaシリーズをNVIDIA RTX PCで活用する構成も実用的な選択肢です。
また、本モデルにはMulti-Token Prediction(MTP)ドラフターが同梱されています。MTPは推論時に複数トークンを並列的に予測することでレイテンシを削減する技術で、Speculative Decodingの一種です。このMTPドラフターの詳細な仕組みと使い方については別途解説しています。
利用方法と対応プラットフォーム
Gemma 4 12BはApache 2.0ライセンスで公開されており、商用利用を含む幅広い用途に対応しています。以下の手順で各プラットフォームから利用できます。
手順の前提条件:
- 16GB以上のVRAMまたは統合メモリを持つ環境
- いずれかのツールがインストール済みであること(後述)
Ollamaでの利用(最も手軽な方法):
Ollama(ローカルLLM実行ツール)がインストール済みの場合、以下のコマンド一つで起動できます。
# Gemma 4 12Bのインストールと起動を同時に行うコマンドです

ollama run gemma4
注意: ollamaコマンドが見つからない場合は、Ollamaの公式サイトからインストーラーをダウンロードしてください。
Hugging Face Transformersでの利用:
pip(Pythonのパッケージ管理ツール)でインストール後、以下のように利用できます。
# Transformersライブラリのインストールコマンドです

pip install transformers

# Hugging FaceからGemma 4 12B(インストラクションチューニング版)を読み込みます

from transformers import AutoTokenizer, AutoModelForCausalLM

# モデルIDを指定します(-it はインストラクションチューニング版を意味します)

model_id = "google/gemma-4-12B-it"

# トークナイザーとモデルを読み込みます

tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto")
注意: モデルのダウンロードには数十GB程度のストレージが必要です。また、Hugging Faceのアカウントでモデルへのアクセス許可を事前に取得する必要があります。
その他の対応ツール:
Googleによれば、以下のツールでもGemma 4 12Bが利用できます。
- ローカル実行: LM Studio、Google AI Edge Gallery App
- 推論フレームワーク: llama.cpp、MLX、SGLang、vLLM
- ファインチューニング: Unsloth
- クラウドデプロイ: Google Cloud(Gemini Enterprise Agent Platform Model Garden、Cloud Run、GKE)
エージェント開発への活用
Gemma 4 12Bのリリースと同時に、Googleはエージェント開発向けの「Gemma Skills Repository」を公開しています。これはGemmaモデルを活用してエージェントを構築するためのスキルライブラリで、GitHubの google-gemma/gemma-skills リポジトリで公開されています。マルチステップ推論やワークフロー自動化などのエージェントユースケースに対応した実装パターンが収録されていると考えられます。
まとめ
Gemma 4 12Bは、エンコーダーフリーの統合アーキテクチャによって視覚・音声・テキストの処理を統合しながら、ラップトップで動作するサイズに収めたモデルです。Apache 2.0ライセンスで公開されており、OllamaやHugging Faceから手軽に試せるのも特徴だと思います。ローカルでマルチモーダルなエージェントを構築したい開発者にとって、有力な選択肢になると考えられます。