はじめに
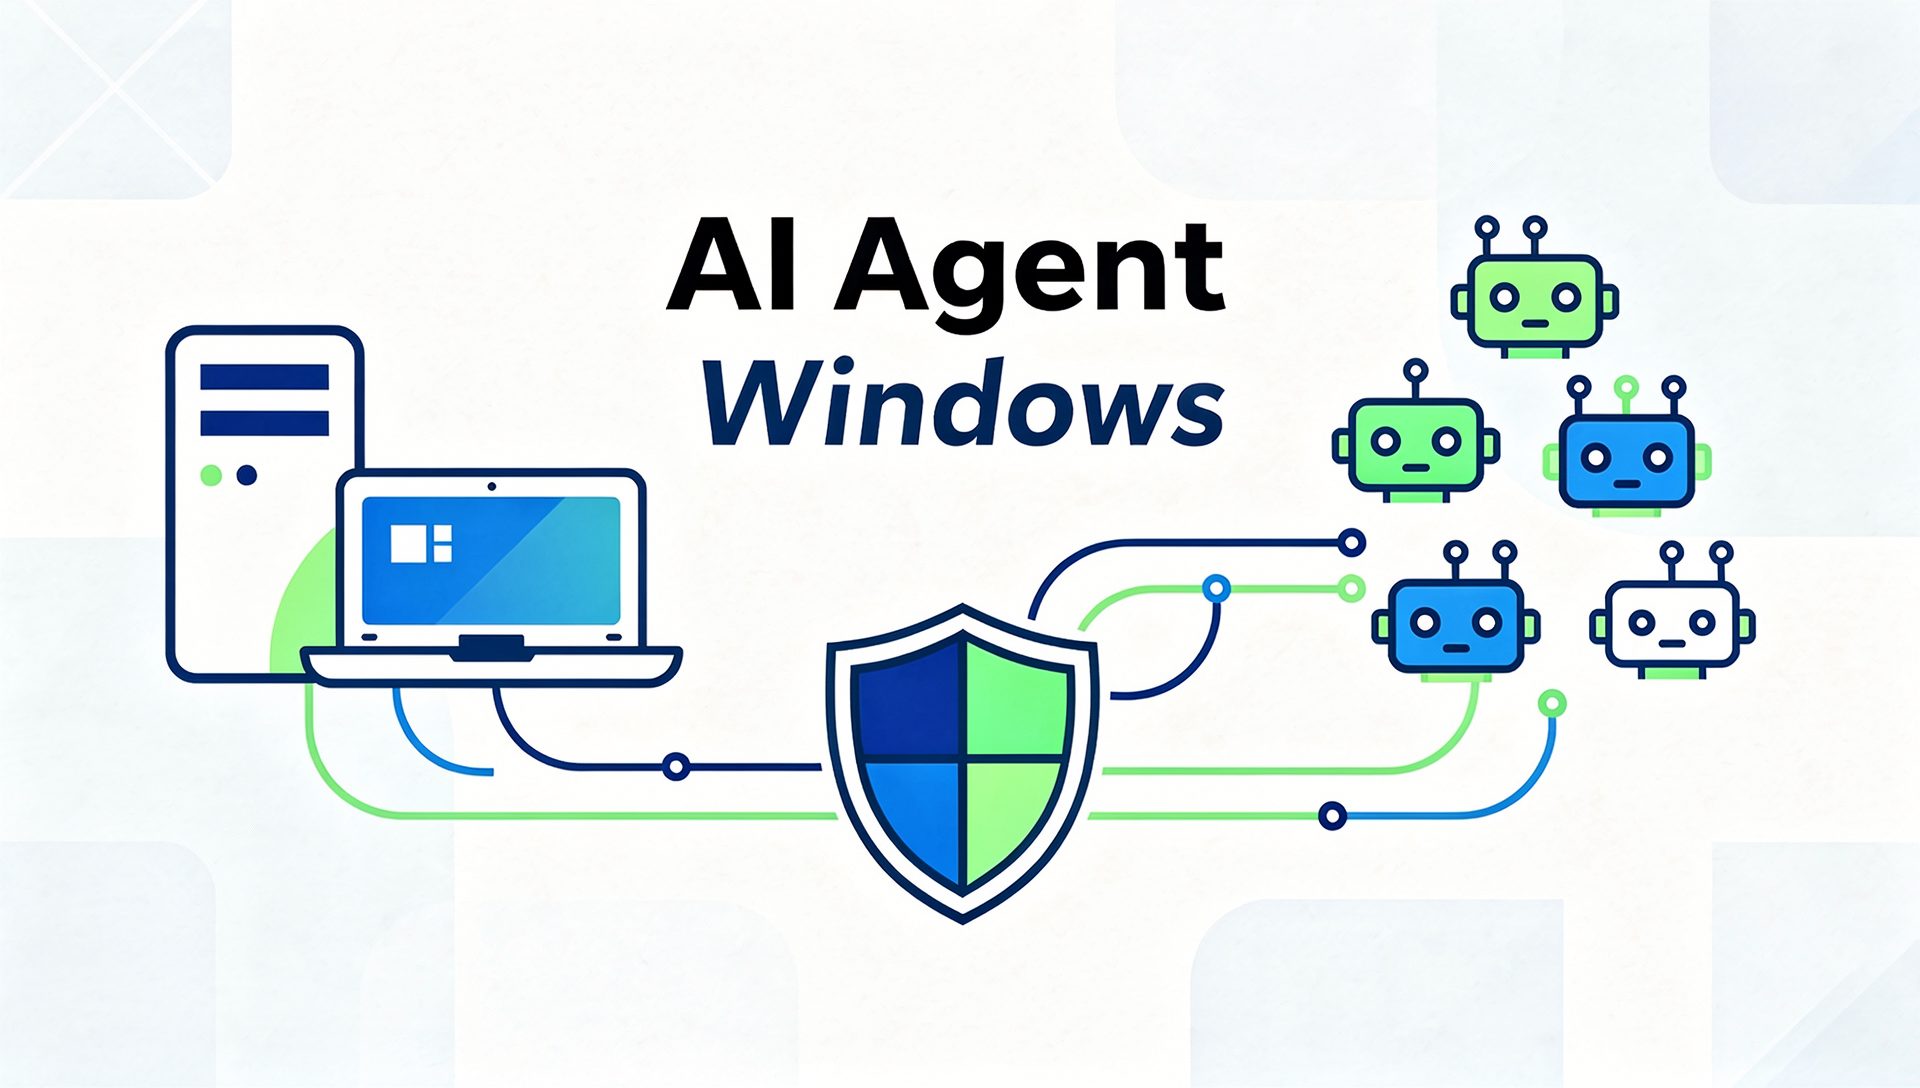
NVIDIAとMicrosoftが2026年6月2日、COMPUTEX 2026(GTC Taipei)とMicrosoft Build 2026の合同発表として、Windows PC上でAIエージェントをセキュアかつ高速に動かすための新ツール群を公開しました。本稿では、エージェントのサンドボックス化、推論の高速化、マルチGPU対応など、開発者が今すぐ使える内容を詳しく解説します。
参考記事
- タイトル: Build Personal AI Agents on Windows PCs with New Tools from Microsoft and NVIDIA
- 著者: Annamalai Chockalingam、Gerardo Delgado
- 発行元: NVIDIA Developer Blog
- 発行日: 2026年6月2日
- URL: https://developer.nvidia.com/blog/build-personal-ai-agents-on-windows-pcs-with-new-tools-from-microsoft-and-nvidia/
関連記事
要点
- MicrosoftがeXecution Containers(MXC)を発表。Windowsネイティブのセキュリティ機構を使ってエージェントのコード実行・ファイル操作を安全に分離できる
- NVIDIAがMXC上で動くOpenShellランタイムを提供し、エージェントのデプロイ・推論ルーティング・PII難読化を一体で扱えるようになった
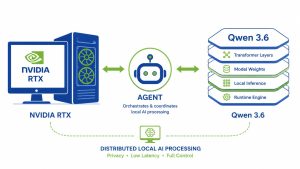
- llama.cppでQwen 3.6 27B dense モデルの推論スループットが2倍、vLLMでは2.6倍に向上
- llama.cppがテンソル並列(TP)に対応し、RTX PC上の2GPU構成でメモリ容量最大2倍・推論最大1.8倍を実現
- H CompanyのHolo 3.1がComputer Useに特化したモデルとして登場し、FP8比35%の低メモリで動作する
詳細解説
エージェントを安全に動かす仕組み——MXCとOpenShell
AIエージェントはユーザーの代わりにファイルを読み書きしたり、アプリを操作したりするため、悪意のある指示を注入される「プロンプトインジェクション」のリスクが常に伴います。このリスクに対処するため、MicrosoftはMicrosoft eXecution Containers(MXC)をMicrosoft Buildで発表しました。MXCはWindowsネイティブのOS構造を使った隔離・制限レイヤーであり、エージェントがシステム全体にアクセスできないよう制御します。既存のコンテナ技術(DockerなどのLinuxベース)とは異なり、Windowsネイティブで動作するため追加の仮想化レイヤーが不要です。
NVIDIAはこのMXCをベースにしたOpenShellランタイムをWindowsに提供します。OpenShellはMXCを統合するパッケージとして設計されており、エージェントの自律的・常時稼働デプロイを安全に実現しつつ、推論ルーティングや個人識別情報(PII)の難読化機能も備えます。OpenClawやHermes Agentといった人気のオープンソースエージェントも、MXCとOpenShellを活用してWindowsでの安全性を強化する方向で開発が進んでいます。NemoClaw/OpenClawの詳細はこちらでも取り上げています。
Hermes AgentがネイティブWindowsに対応
以前紹介したHermes Agentが今週、ネイティブWindowsサポートをリリースしました。CLIに加え、新しいデスクトップアプリも提供されており、WindowsのネイティブAPI・ファイル・アプリとの連携がより容易になっています。また、NemoClaw経由でHermes Agentを起動するオプションも追加され、セットアップの一体化が進んでいます。
H CompanyのHolo 3.1——Computer Useに特化したローカルモデル
AI研究・製品企業のH CompanyがHolo 3.1モデルレンジを発表しました。このモデルはComputer Use(エージェントが画面を見てクリックや操作を行うモード)に特化したチューニングが施されており、FP8比で35%メモリ消費を削減した量子化チェックポイントを含みます。ローカルモデルに対応したComputer Useハーネスも近日公開予定とのことです。NVIDIAのGPU最適化により、NVIDIA GPU上でのパフォーマンスは2倍以上に向上しているとされています。
Computer UseはAnthropicが2024年に発表した概念で、AIが画面を視覚的に解釈しながらGUIを操作する技術です。従来はクラウドAPIを通じた利用が主でしたが、ローカルモデルで実現できるようになることで、プライバシーが重視される業務環境での活用範囲が広がると考えられます。
推論速度の大幅改善——llama.cppとvLLMの最適化
エージェントが24時間365日稼働する前提では、ローカル推論の効率が直接ユーザー体験に影響します。NVIDIAはオープンソースコミュニティと協力し、主要な推論バックエンドを大幅に高速化しました。
llama.cppの改善:
- Qwen 3.5 / 3.6 27B dense モデルで 2倍 のスループット向上
- Qwen 3.5 / 3.6 35B MoEモデルで 1.6倍 の向上
この改善は主に2つの技術によるものです。
Multi-Token Prediction(MTP)は、より小さなドラフトモデルが複数トークンを先読みして提案し、ターゲットモデルが1回のフォワードパスで検証する投機的デコーディング(speculative decoding)の手法です。すでにMTPをサポートするモデルであれば追加学習不要で利用できる点が実用上のメリットです。
Programmatic Dependent Launch(PDL)は、同じCUDAストリーム上の依存カーネルを並行実行できるようにすることでデコード速度を向上させる手法です。従来は依存カーネルを順次実行する必要がありましたが、PDLによってその制約が解消されています。
vLLMの改善:
- MTPの採用に加え、追加の最適化で推論パフォーマンスを 2.6倍 向上
- MoEモデル向けBF16カーネルの改善
- CUDA Graphsの改善によるランタイムオーバーヘッドの削減
これらの更新はLM Studio、llama.cpp、vLLMを通じてすぐに試すことができます。
マルチGPU対応——RTX PCで大型モデルをより効率的に
RTX PCに2枚のGPUを搭載する構成は、メモリ容量とコンピュートを増やす人気の方法です。しかしクラウド向けに最適化されたvLLMと異なり、PC向けフレームワークのllama.cppやComfyUIはマルチGPUに対応していませんでした。NVIDIAはこれを解消するため、それぞれのコミュニティと協力して対応を進めました。
llama.cppのテンソル並列(TP)対応: 2台の同等GPUを完全に活用し、メモリ容量最大2倍・コンピュートパフォーマンス最大1.8倍を実現します。LM Studioでも利用可能で、Settings → Runtime からTPを有効化できます。
# LM Studioでテンソル並列を有効にする手順
1. LM Studio アプリを開く
2. Settings(設定)を選択
3. Runtime(ランタイム)を選択
4. テンソル並列(TP)を有効化
ComfyUIのマルチGPU対応: Classifier-Free Guidance(CFG)メソッドを統合し、2枚のGPUで最大2倍のコンピュートを実現します。モデルチェーンをGPU間で分割してフルロードすることも可能で、低VRAMモードのメモリスワップオーバーヘッドを排除できます。
テンソル並列の詳細はllama.cpp GitHubおよびHow to Build a Multi-GPU AI PCで確認できます。
メディア・動画開発者向けの新機能
NVIDIA AI for Media SDK(AI4M)が開発者向けプライベートアクセスで提供開始されました。
- LipSync GA: フランス語・ドイツ語・スペイン語対応の言語最適化モデルを含み、高品質な吹き替えとコンテンツのローカライゼーションを実現
- Active Speaker Detection(ASD)GA: マルチカメラ・マルチマイク対応と話者IDのクロスビデオ相関機能により、リップシンク吹き替えや動画編集の自動化ワークフローを解放
Windows AIプラットフォームの整備
Windows AI FoundryとWindows AI APIがGPUアクセラレーションに対応し、RTXハードウェア上では対応APIの呼び出しが高性能なローカル推論にルーティングされます。最初に対応するモデルはPhi-Silicaで、要約・リライト・コード生成などに対応した3.3Bのスモール言語モデル(SLM)です。
また、Windows Subsystem for Linux Containers(WSL-C)が新たに提供されます。これはWindowsネイティブアプリからLinux AIコンテナを作成・実行・操作するための組み込み機能で、ユーザー自身がWSLのシステムリソースを管理する必要がなくなります。
まとめ
MicrosoftのMXCとNVIDIAのOpenShellによるセキュアなエージェントサンドボックスの整備、llama.cppやvLLMの大幅な高速化、マルチGPU対応など、Windows PCをローカルAIエージェントの開発・実行基盤として本格的に活用するための環境が一気に整ってきたと言えます。1億台超のNVIDIA RTX PC向けに開発するという視点は、今後の開発者戦略として注目に値するだと思います。