はじめに
Perplexityの「Portable Computer」が、RTX搭載のWindows PCに対応しました。NVIDIAが2026年10月26日付の公式ブログで紹介しています。Portable Computerは、手元のPCで作業を進めるAIエージェントです。本稿では、発表内容と利用条件、注意点を解説します。
参考記事
- タイトル: Perplexity Portable Computer が NVIDIA RTX 搭載 Windows PC に対応
- 著者: Gerardo Delgado
- 発行元: NVIDIA(NVIDIA日本語公式ブログ)
- 発行日: 2026年10月26日
- URL: https://blogs.nvidia.co.jp/blog/local-ai-perplexity-windows-pcs/
要点
- PerplexityのPortable Computerが、対応するRTX搭載Windows PC向けアプリに追加された
- ローカルで完了した作業は、Perplexity Computerのクレジットを消費しない
- 高度な推論が必要な場合は、ユーザーの許可を得てクラウドへ連携できる
- 利用には、24GB以上のVRAMを搭載したGeForce RTXまたはRTX PRO GPUが必要である
- Outlook、Slack、GitHubなど7種類のアプリ向けコネクタが用意されている
詳細解説
Portable Computerとは
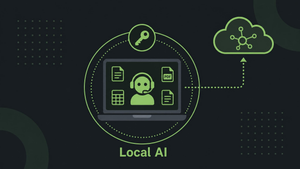
NVIDIAによると、Portable Computerは「Perplexity Computer」のローカル版です。Perplexity Computerは、複数のステップからなるタスクを計画・実行するエージェントです。ローカル版はNVIDIA GPUで高速化され、ローカルモデルを使って次の作業をこなします。
- データの分析
- 複数ファイルからの情報の統合
- 反復業務の処理
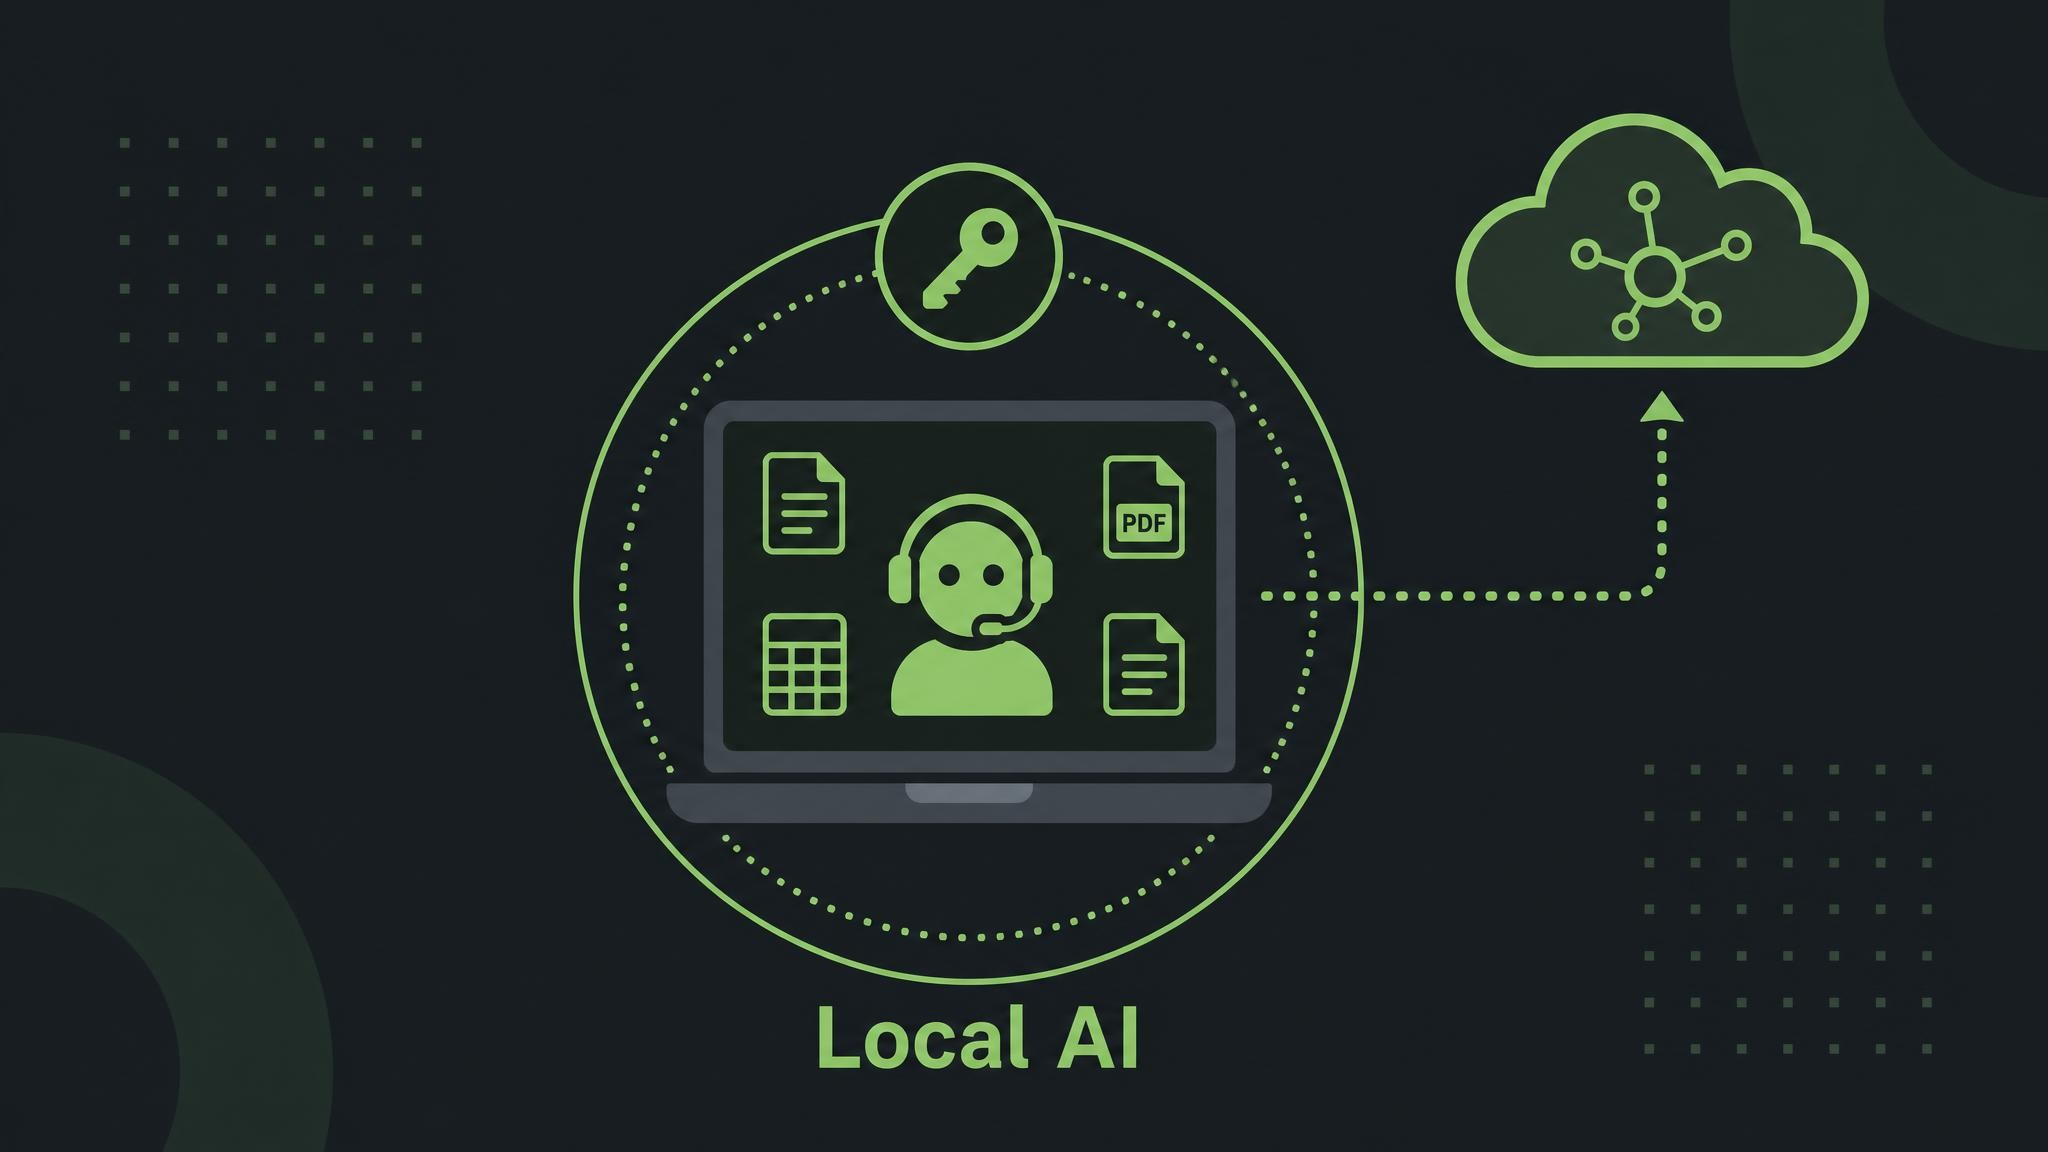
機密情報はデバイス上に保持されます。ローカルで完了した作業は、Perplexity Computerのクレジットを消費しません。高度な研究や推論が必要な場合は、クラウドモデルへ作業を連携することもできます。
ここでいうローカルモデルとは、手元のPC上で動くAIモデルを指します。入力データを外部のサーバーへ送らずに処理できる点が特徴です。一方で処理能力はPCの性能に左右されるため、クラウドとの併用を前提にした設計と読めます。
Windows対応で何が変わるか
今回、PerplexityはWindows版PerplexityアプリにPortable Computerを追加します。対象は、対応するGeForce RTX PCとNVIDIA RTX PROワークステーションです。より多くのWindows PCユーザーに、エージェント型AIを届けることが目的とされています。
Portable Computerはこれまで、NVIDIA DGX Sparkシステムと、Linuxを実行するRTX PCで利用できました。今回のリリースは、この既存のサポートを土台にしています。
DGX Sparkは、NVIDIAが展開するデスクトップ型のAI向けシステムです。これまでの対応環境は、開発者や研究者向けの色合いが強かったと考えられます。業務で使われるPCはWindowsが多いと考えられるため、利用者層が広がる点に意味があると見ています。
ローカルとクラウドを1つのアプリで使い分ける
Perplexityは、ローカルAIとクラウドAIを1つのアプリに統合しています。ユーザーはPC上で機密ファイルを扱いながら、Computerの内蔵ツールを活用できます。内蔵ツールの例として、内蔵ブラウザと独自のSPACEサンドボックスが挙げられています。
より高度な推論が必要なタスクでは、Portable Computerがクラウドの支援が必要かを判断します。そのうえで、ユーザーの許可を得てから、デバイスの外へ情報を送信できます。
サンドボックスとは、PC本体から隔離された実行環境のことです。エージェントの操作による影響を、限られた範囲に閉じ込める仕組みと考えられます。ただし、SPACEの具体的な仕様は元記事では説明されていません。
クラウドへ送る前に許可を求める設計は、機密情報を扱う業務で重要だと思います。どの情報がどこまで送られるかは、実際の確認画面で見極めるのが確実だと考えられます。
最適化済みのローカルモデルで導入の手間を減らす
アプリには、Perplexity Computerと連携するようポストトレーニングされたローカルモデルが用意されています。例として挙げられているのはQwen 3.8 27Bです。これらのモデルは、NVIDIA RTX GPU向けに最適化されています。
そのため、ユーザーは自分でモデルを調べる必要がありません。ローカルAIの実行に通常必要な、複雑なソフトウェアスタック(必要なソフトウェアの組み合わせ)の構成も不要です。すぐにエージェントを使い始められる点が、セットアップの簡素化として説明されています。
ポストトレーニングとは、事前学習を終えたモデルを特定の用途向けに追加で調整する工程です。「27B」は、パラメーター数が約270億であることを示す一般的な表記です。ローカルAIでは、モデル選びや実行環境の構築が負担になりがちです。専任の担当者がいない小規模な組織ほど、この手間が減る利点は大きいと思います。
7種類のコネクタで業務アプリとつなぐ
コネクタは、次の7種類のアプリ向けに用意されています。
- Microsoft Outlook
- OneDrive
- Word
- Google Drive
- Gmail
- Slack
- GitHub
これらのコネクタにより、日常のワークフローに組み込まれたファイルやアプリ全体へ、エージェントの体験を広げられます。
コネクタとは、外部サービスのデータにアクセスするための接続機能です。クラウドサービスと連携する場合、データの流れが手元のPCだけで完結しない可能性があります。各コネクタの処理範囲は、元記事では詳しく説明されていません。導入時は、権限の設定とあわせて確認しておくと安心だと思います。
想定されている3つの活用例
NVIDIAのブログでは、エージェントが支援できる例として次の3つを挙げています。
- エンジニアリング: 接続したGitHubプロジェクトの未解決のプルリクエストを確認し、ステータス別に分類して次のステップを特定する。古いドキュメントにフラグを付け、更新案をレビューに提出することもできる。
- 財務: 過去2年分の証券取引の概要、統合1099フォーム、納税申告書をComputerに指定する。回避可能な手数料と税負担が最も多く生じている保有銘柄を追跡させ、すべての数値について正確なファイルとページを引用させる。これらを、チャットボットに文書を送らずに実行する。
- スタートアップ: アクティベーションが停滞した理由を尋ねると、エージェントがファネルのエクスポートをローカルで分析する。インストールから最初のタスク完了までの間で、新規登録者が離脱するポイントを特定する。主な分析結果は、チームのSlackチャネルに直接投稿する。
アクティベーションは、新規ユーザーが製品を使い始めて価値を感じるまでの段階を指す言葉です。ファネルは、利用者が段階を進むごとに減っていく流れを表したデータです。また、1099フォームは米国の税務書類であり、財務の例は米国の利用者を想定したものと読めます。日本では、取引報告書や確定申告の書類に置き換えて考えると分かりやすいと思います。
本稿としては、数値ごとにファイルとページを引用させる指示の出し方に注目しています。AIの回答を後から検証しやすくする工夫として、他の業務にも応用できると考えています。
利用条件と提供状況
Portable Computerは、24GB以上のVRAMを搭載したNVIDIA GeForce RTXおよびRTX PRO GPUで利用できます。NVIDIA DGX Stationにも、近日対応する予定です。
VRAMとは、GPUに搭載された専用のメモリです。ローカルモデルは主にこのメモリ上で動くため、容量が実行の可否を大きく左右します。24GB以上という条件は、一般向けのGeForceでは上位の製品に限られると考えられます。手元のPCが条件を満たすかは、まずGPUのVRAM容量で確かめるのが近道だと思います。Windowsでは一般に、タスクマネージャーの「パフォーマンス」タブで確認できます。
料金については、ローカルで完了した作業はクレジットを消費しないことが示されています。一方、アプリの料金プランやクラウド連携時のクレジット消費量は、元記事に記載がありません。日本での提供条件や日本語での使い勝手も明記されていません。導入前に、Perplexityの公式情報で確認するのが確実だと思います。
NVIDIAのローカルAIに関するその他の最新情報
ブログの後半では「#ICYMI」として、NVIDIAのローカルAIに関する他の最新情報も紹介されています。ICYMIは「見逃した方へ」を意味する略語です。
- Z.aiのGLM 5.3 Flash: DGX StationとデュアルDGX Sparkシステムに最適化されている。優れたパフォーマンスと視覚的インテリジェンスを低コストで提供する。
- DeepSeek-v4.1 Flash: 複雑なAIエージェントのワークロードで、キーバリュー(KV)キャッシュのメモリ要件と運用コストを大幅に削減する。
- QwenのQwen3.8-Flash-Next: オープンウェイトのマルチモーダル混合エキスパート(MoE)モデルである。
- Qwen4の早期プレビュー版: Qwenがリリースし、NVFP4を用いて1台のDGX Spark上でローカル実行できる。1クラス上の性能を発揮するとされている。
- Z.aiのGLM 5.3: 7440億パラメーターの主力モデルである。DGX Stationと、4台のDGX Sparkで構成するクラスタ上で、数時間にわたるエージェントセッション向けにチューニングされている。
KVキャッシュとは、文章生成の途中計算を保存して再計算を省く仕組みです。長い対話や作業ほどメモリを使うため、エージェント用途では負担になりやすい要素とされます。MoEは、入力に応じて一部の専門部分だけを動かす構成で、計算量を抑えやすい方式です。NVFP4はNVIDIAが定めた4ビットの数値形式とされ、モデルのメモリ使用量を抑える目的で使われます。本稿としては、エージェント向けの効率化が各社で進んでいる流れと受け止めています。
導入を検討する際の本稿の見方
本稿としては、今回の発表の要点は2つあると考えています。1つは、機密データを手元に置いたままエージェントを使える点です。もう1つは、ローカルで完了した作業がクレジットを消費しない点です。
一方で、24GB以上のVRAMという条件は、一般的な事務用PCでは満たしにくいと思います。また、元記事には処理速度や精度を示す数値がありません。ローカルとクラウドの使い分けが業務に合うかは、実際に試して判断する必要があると考えられます。
試す場合は、まず機密性の低いファイルで動作を確かめる進め方が考えられます。そのうえで、クラウド送信の許可の出方やコネクタの権限を確認すると、安心して範囲を広げられると思います。
まとめ
PerplexityのPortable Computerが、RTX搭載のWindows PCに対応しました。機密データを手元に置いたまま使え、ローカル処理はクレジットを消費しません。24GB以上のVRAMが条件のため、まずは手持ちのGPUを確認するのが第一歩だと思います。今後のDGX Station対応にも注目です。