はじめに
OpenAIは2026年10月26日、高速かつ低コストでコンピュータ操作をこなす新モデル「GPT-6.1 Terra」を公開しました。7月に正式公開されたGPT-5.6 Terraの後継にあたります。本稿では、ベンチマーク結果、事実性・コーディング性能、安全対策、価格を順に整理します。
参考記事
- タイトル: Introducing GPT-6.1 Terra
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年10月26日
- URL: https://openai.com/index/introducing-gpt-6-1-terra
関連記事
要点
- GPT-6.1 TerraのAPI標準価格は、GPT-5.6 TerraおよびGPT-6.1 Solより50%低い
- Agents’ Last Examでは、中程度の推論設定でGPT-5.6 Terraを15ポイント上回り、GPT-6 Astraと同等の性能を示した
- 誤りを誘発するプロンプトでの誤答率は、低推論設定で53.6%から16.7%に下がった
- Terminal-Bench 4.0の解決率は50.3%で、GPT-5.6 Terraの21.5%の2倍以上である
- サイバーセキュリティでCritical閾値に該当し、GPT-6 Astra向けの保護策を引き継いでいる
詳細解説
「日々の業務」に焦点を当てた中位モデル
OpenAIによれば、GPT-6.1 Terraは細かな視覚的推論と精度の高いコンピュータ操作、より自然で明快な文章生成を組み合わせたモデルです。提案書の下書き、技術図面の読み取り、フォームへの入力、動画編集といった、一日の仕事を埋めるコミュニケーション系・PC作業系のタスクを得意とするとされています。
価格面では、API標準価格がGPT-5.6 TerraとGPT-6.1 Solの半額に設定されました。OpenAIは、届いた請求書を読み取って会計ソフトに入力するような大量処理の自動化も現実的になると説明しています。ChatGPT WorkとCodexでも、同じ利用枠でGPT-5.6 Terraより多くのタスクを、GPT-6.1 SolやGPT-6 Astraと比べればかなり多くのタスクをこなせるとしています。
OpenAIのモデルは、最上位のAstra、高性能のSol、バランス型のTerra、軽量のLunaという系統で整理されており、Terraは「速さ・性能・コスト」の釣り合いを担う位置づけと読めます。業務で毎日何百回も呼び出す用途では、最高性能より単価と速度が効いてくる場面が多く、本稿としては、実務への導入で最も選ばれやすい層を強化した発表だと受け止めています。
コンピュータ操作と視覚理解の性能
コンピュータ操作(AIが画面を見ながらマウスやキーボードを操作し、アプリを使って作業を進める機能)の評価には、専門職のタスクを集めた「Agents’ Last Exam」が使われました。建築図面から3Dモデルを作る、アニメ映画をカットごとに確認して修復チーム向けのタイムコード付き記録を作る、といった課題が含まれます。OpenAIの発表による主な結果は次のとおりです。
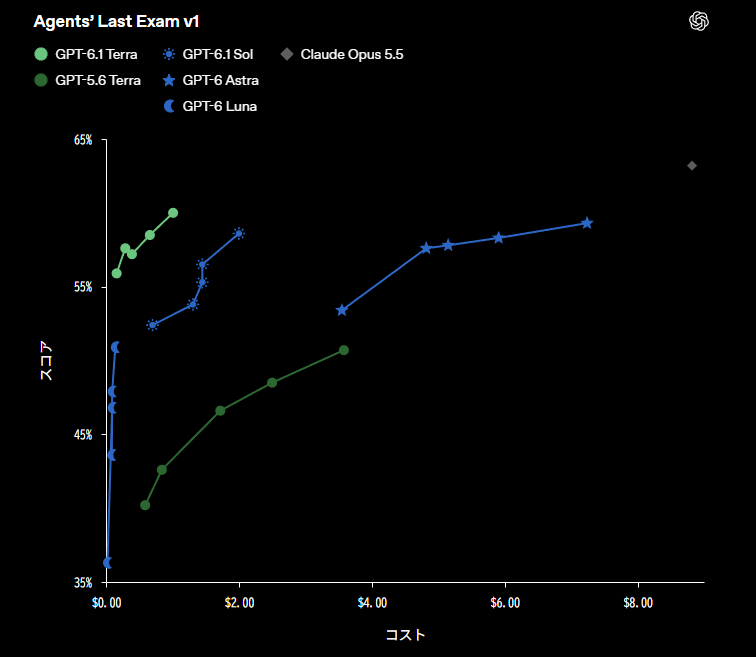
- 中程度の推論設定で、GPT-5.6 Terraより15ポイント高いスコアを約3分の1のコストで達成
- 同設定で、GPT-6 Astraと同等の性能をトークン単価の10分の1で実現
- 最大推論設定では、Claude Opus 5.5と比べてトークン効率が3倍以上、トークン単価は4分の1で、タスクあたりのコストは約9分の1
- タスクの完了速度は、GPT-6 AstraとGPT-6.1 Solのいずれと比べても3倍以上速い
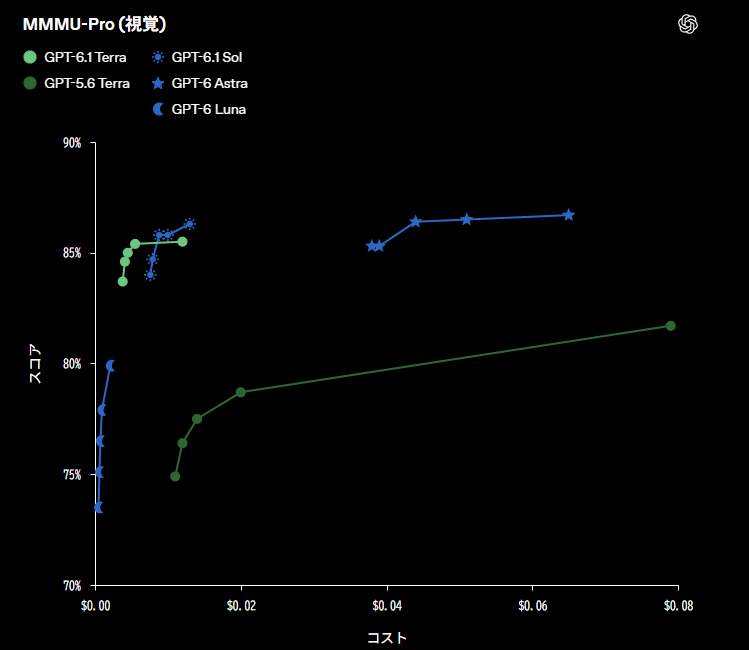
視覚的推論のベンチマーク「MMMU-Pro」では、すべての推論設定でGPT-5.6 Terraを上回り、最上位モデルのGPT-6 AstraやGPT-6.1 Solにほぼ並ぶスコアを、はるかに低いコストで記録したとされています。
また、デスクトップアプリを使った複数ステップの作業を評価する「OSWorld 2.1」でも、中程度の推論設定でGPT-5.6 Terraの最高スコアを上回りました。
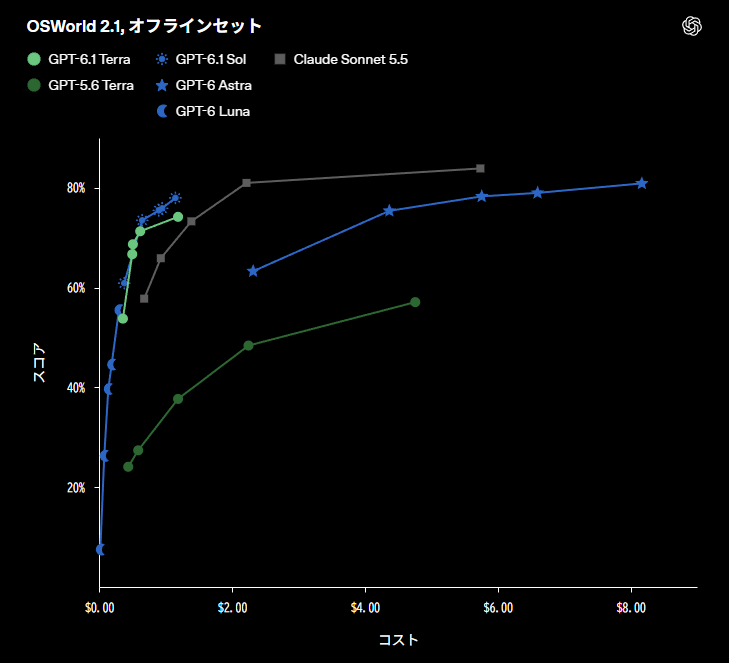
ここでいう推論設定(reasoning effort)は、回答前にモデルがどれだけ時間とトークンをかけて考えるかを調整するパラメータです。設定を上げるほど精度は上がりやすい一方、コストと待ち時間も増えます。今回の発表は「トークン単価」だけでなく「タスクあたりのコスト」を強調している点が特徴的で、単価が安くても考えすぎて大量のトークンを使えば総額は膨らむため、実運用ではこちらの指標の方が参考になると思います。ただし、いずれもOpenAI自身による評価であり、第三者による検証結果もあわせて見ていく必要があると考えています。
事実性の向上:誤答率が大きく低下
OpenAIは今年、ハルシネーション(AIがもっともらしい誤情報を生成する現象)と事実誤認の削減に重点的に取り組んできたと述べています。誤りを誘発しやすいプロンプトを集めた社内ベンチマークでは、次の結果が示されました。
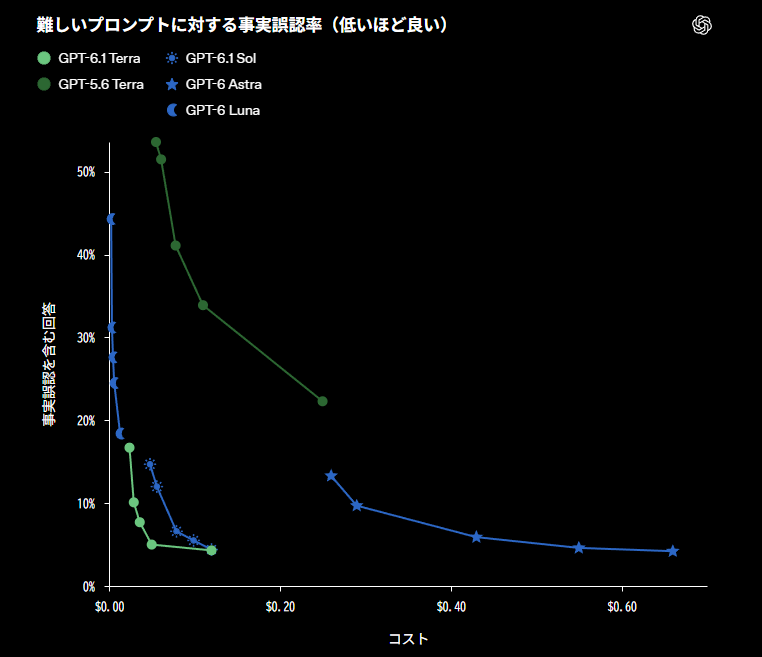
- 低推論設定:誤答率がGPT-5.6 Terraの53.6%から16.7%へ低下(約37ポイント減)
- 最大推論設定:誤答率が18ポイント下がって4.3%となり、GPT-6 AstraやGPT-6.1 Solとほぼ同水準
この社内ベンチマークは「あえて間違えやすい質問」を集めたものなので、通常の業務で同じ割合の誤りが出るわけではないと考えられます。一方で、低推論設定でも誤答率が大きく下がった点は、コストを抑えた設定で大量処理を回す使い方にとって意味が大きいと思います。とはいえ最大設定でも誤答はゼロではないため、請求書処理のように数値が重要な業務では、人による確認の工程を残すのが現実的だと本稿では考えています。
ソフトウェア開発と科学研究タスク
ソフトウェアエンジニアリングでも、GPT-5.6 Terraから大きな改善が見られたとOpenAIは説明しています。
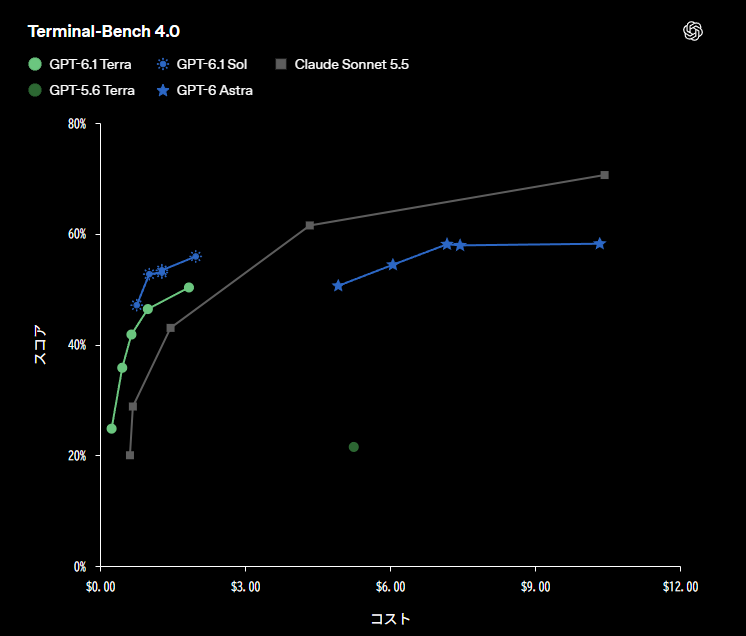
- Terminal-Bench 4.0 (コマンドライン上で問題を解く力を測る評価。読み込み中にレイアウトがずれるWebページの修正など):最大推論設定で50.3%のタスクを解決し、GPT-5.6 Terraの公表スコア21.5%の2倍以上
- Terminal-Bench-Science 0.1 (コードを使って科学研究タスクをこなす力を測る評価。タイムラプス動画からの細胞分裂の追跡など):最大推論設定でGPT-6.1 Solを低コストで上回り、Opus 5.5との差は5ポイント以内、推定コストは5分の1未満
一方でOpenAIは、最も複雑なコーディングタスクにはGPT-6.1 SolやGPT-6 Astraの方が適しているとも明記しています。日常的な修正や定型的な開発作業はTerra、大規模な設計変更や難度の高いデバッグは上位モデル、という使い分けが想定されていると読めます。自社のタスクがどちらに近いかを小規模に試してから選ぶのが、無理のない進め方ではないでしょうか。
安全性とアライメント
OpenAIによれば、GPT-6.1 TerraはPreparedness Framework(OpenAIがリスクの高い能力を段階的に評価する枠組み)のサイバーセキュリティ分野で「Critical」の閾値に該当し、GPT-6 Astraのために開発された保護策をそのまま維持しています。
アライメント(AIの振る舞いを人の意図に沿わせること)の面では、GPT-6シリーズの改善を受け継いでいます。OpenAIの評価では、GPT-5.6 Terraと比べて指示された範囲内にとどまりやすく、自分の限界や作業の妨げになりうる要因をユーザーに正直に伝える傾向が強まったとされます。また、ユーザーの作業から注意をそらす悪意ある指示を仕込むプロンプトインジェクションのテストでも、高い耐性を示したと報告されています。詳細はシステムカードで公開されています。
中位モデルでありながら最上位級の安全措置が適用されている点は、性能の高さの裏返しとも言えます。コンピュータ操作を任せる場合、閲覧したWebページやメールに紛れ込んだ指示に従ってしまうリスクが常にあるため、プロンプトインジェクション耐性の向上は実務上かなり重要な改善だと思います。
価格と提供範囲
GPT-6.1 Terraは発表当日から、ChatGPT WorkとCodexでPlus・Pro・Enterprise・Eduのすべてのユーザーが利用できます。開発者はOpenAI APIからモデル名 gpt-6.1-terra で呼び出せます。API標準価格は次のとおりです。
- 入力:100万トークンあたり1ドル
- キャッシュされた入力:100万トークンあたり0.05ドル
- 出力:100万トークンあたり5ドル
キャッシュ入力(同じ指示文などを繰り返し送る際に割引される入力)は通常入力の20分の1の価格です。仮に請求書1件の処理で入力5,000トークン・出力500トークンを使うとすると、本稿の概算では1件あたり約0.0075ドル(1円程度)となります。実際のトークン量は書類や推論設定によって変わりますが、大量処理を前提とした価格設計であることがうかがえます。
まとめ
GPT-6.1 Terraは、GPT-6 Astraに近い操作・視覚性能を大幅に低い単価で提供し、誤答率やコーディング性能も改善したモデルです。性能とコストの釣り合いがどう実務を変えるか、今後の評価に注目したいと思います。安全対策の背景はAstraに適用されたCritical級の保護策を扱った記事もご覧ください。