はじめに
OpenAIが2026年3月5日に発表した研究により、現在の推論AIモデルが自身の思考プロセス(チェーン・オブ・ソート)を意図的に操作する能力を持たないことが示されました。本稿では、この発見がAI安全性にとってなぜ重要な意味を持つのかを解説します。
参考記事
- タイトル: Reasoning models struggle to control their chains of thought, and that’s good
- 著者: Tomek Korbak, Micah Carroll, Bowen Baker, Ian Kivlichan
- 発行元: OpenAI
- 発行日: 2026年3月5日
- URL: https://openai.com/index/reasoning-models-chain-of-thought-controllability/
要点
- 現在の推論モデルは、チェーン・オブ・ソート(CoT)と呼ばれる思考プロセスを意図的に制御・隠蔽する能力が著しく低い
- OpenAIが開発した評価スイート「CoT-Control」で13のモデルをテストした結果、CoT制御可能性スコアは0.1%から最大15.4%にとどまった
- モデルは自分が禁止事項に違反していると気づきながら、それでも違反を繰り返すという特異な挙動が確認された
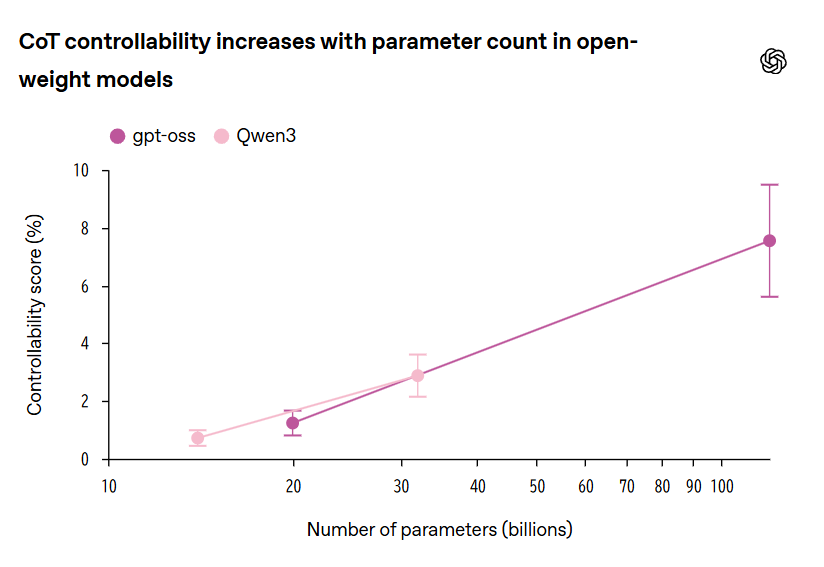
- CoT制御可能性はモデルの規模が大きくなるほど若干上昇するが、推論時間が長くなるほど、また強化学習(RL)訓練が進むほど低下する傾向がある
- OpenAIは今後、フロンティアモデルのシステムカードにCoT制御可能性の評価結果を定期報告する方針を示した
詳細解説
チェーン・オブ・ソートとAI監視の関係
チェーン・オブ・ソート(CoT)とは、AIが問題を解く際に生成する中間的な思考ステップのことです。人間が数学の問題を解くときにメモ書きするようなイメージに近く、最終的な回答に至るまでの推論の流れが記録されます。このCoTを監視・分析することで、AIが安全に、かつユーザーの意図通りに動作しているかどうかを確認できると考えられています。
しかし、もしAIが「自分のCoTが監視されている」と認識したうえで、意図的に思考過程を偽ったり隠したりできるなら、この監視手法は機能しなくなります。OpenAIが今回研究したのは、まさにこのリスクが現実のものかどうかという問いです。
CoT-Controlによる評価の設計と結果
OpenAIはCoT制御可能性を測定するため、「CoT-Control」というオープンソースの評価スイートを開発しました。このスイートはGPQA、MMLU-Pro、HLE、BFCLおよびSWE-Bench Verifiedといった既存のベンチマークをもとに構成された13,000件以上のタスクで構成されています。各タスクでは、「CoT内で特定のキーワードを使わない」「すべて小文字で推論する」「各文に指定した語を末尾に付ける」といった制御指示を与え、モデルがそれに従えるかどうかを測定します。
13の推論モデルに対してテストを実施した結果、OpenAIによれば、CoT制御可能性のスコアはいずれも低く、最低0.1%から最高でも15.4%にとどまりました。一方で出力(最終的な回答)に対する制御可能性は同じモデルでも著しく高く、CoT特有の低い制御性が示されました。
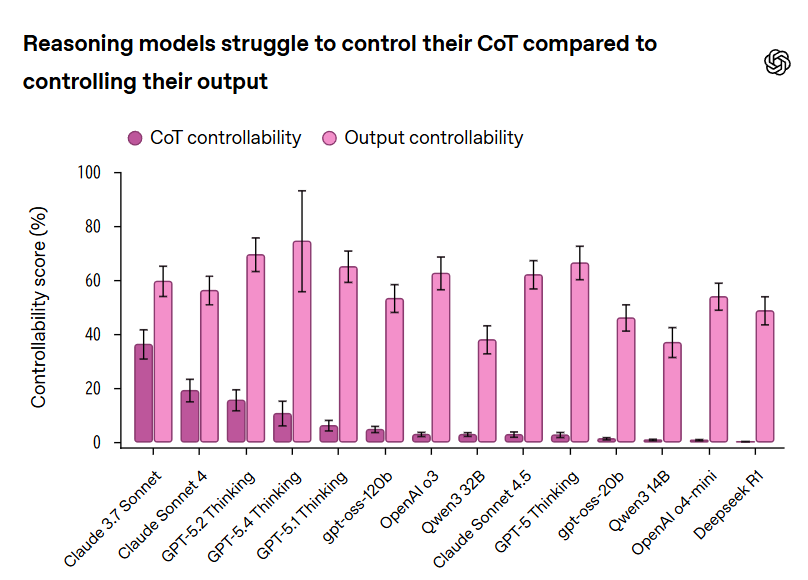
特に注目すべき挙動として、モデルが「自分は禁止されたキーワードをすでに使ってしまった」と気づいたにもかかわらず、その後も同じ語を繰り返し使い続けるケースが確認されています。モデルはタスクの意味を理解できていないのではなく、理解した上でも従えないという点が、この現象の特異な側面です。
モデル規模・推論長・RL訓練との関係
CoT制御可能性には、いくつかの要因が影響することも明らかになっています。モデルのパラメータ数(規模)が大きくなるほど制御可能性はやや上昇する傾向がありますが、その効果は大規模モデルになると頭打ちになると報告されています。
一方、推論にかける時間が長くなるほど制御可能性は低下します。OpenAIの報告では、GPT-5.4 Thinking、GPT-5.2 Thinking、OpenAI o4-miniなど複数のモデルで、推論長が伸びるにつれてCoT制御可能性スコアが顕著に下がることが示されました。また、強化学習(RLVR: Reinforcement Learning from Verifiable Rewards)の訓練ステップが増えるほど制御可能性が下がるという傾向も確認されています。OLMo-3-7B-RL-Zero-Mathの訓練過程では、制御可能性スコアが10分の1以下にまで低下したと報告されています。
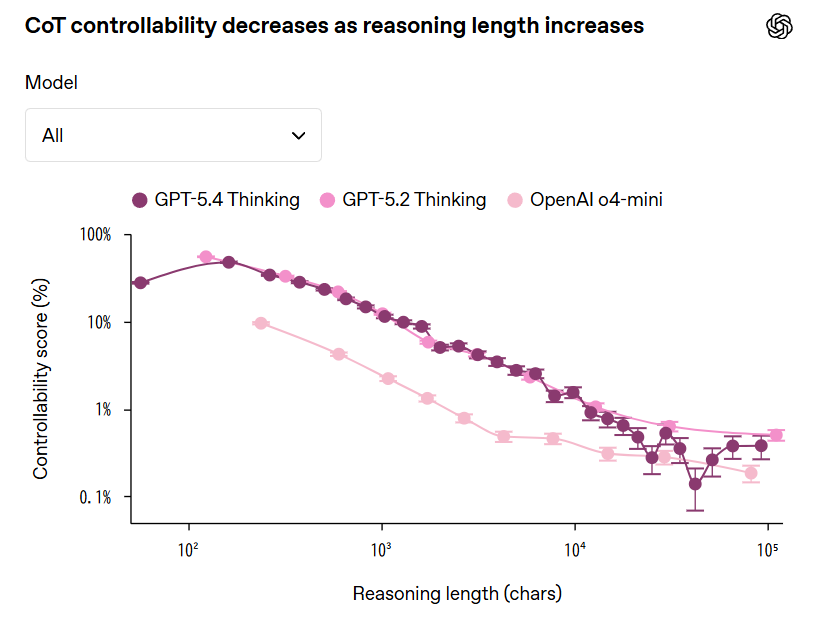
これらの傾向は、推論モデルが学習を重ねるにつれて「純粋に問題を解く」方向に特化していき、それが結果としてCoTの制御性を下げているという解釈も成り立つと思います。
監視への気づきがもたらす影響
監視されていることをモデルに伝えた場合の影響も検証されています。OpenAIによれば、監視されていることを明示すると制御可能性はわずかに(しかし無視できない程度に)上昇しました。また、自動プロンプト最適化によって特定の制御指示に対する制御可能性を引き上げることは可能でしたが、その効果は別の種類の指示には転移しにくいことも示されています。
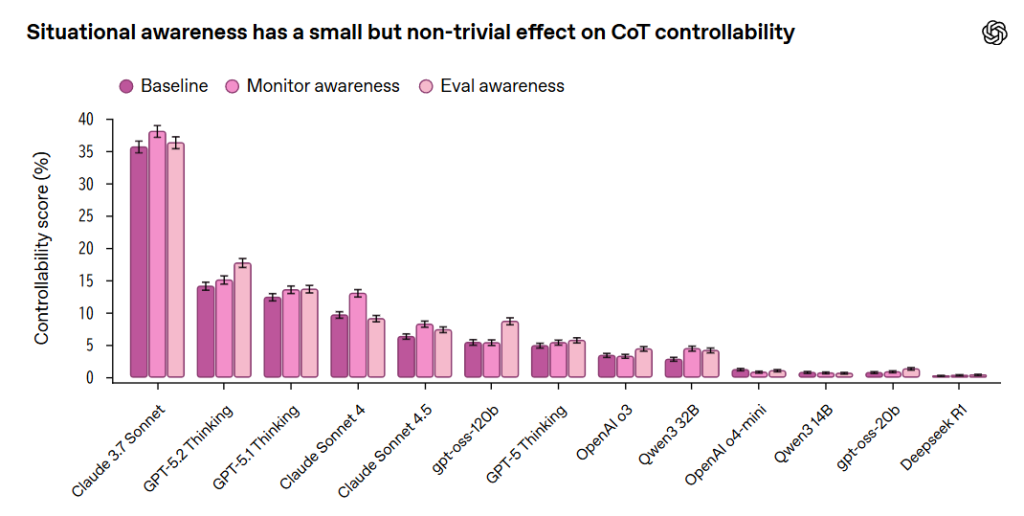
現時点では、監視への気づきによる影響は限定的であり、CoT監視の有効性を根本的に脅かすほどではないと考えられます。ただし、この傾向がモデルの能力向上とともにどのように変化するかは、継続的な評価が求められる部分です。
今後の評価方針と残された課題
OpenAIは今回の結果を踏まえ、「CoT制御可能性の低さは欠点ではなく、安全性の観点からは望ましい特性」という立場を示しています。その一方で、なぜ現在のモデルでCoT制御可能性が低いのか、そしてモデルが高度化した際にこの性質が維持されるかどうかはまだ解明されていないとも認めています。
この「制御できない思考」は、いわば「炭鉱のカナリア」として機能すると研究者たちは表現しています。CoT制御可能性が突然上昇すれば、それはモデルが推論を意図的に操作できるようになったサインである可能性があります。このため、今後はGPT-5.4 Thinkingを皮切りに、フロンティアモデルのシステムカードへCoT制御可能性の評価結果を継続的に公開する方針が示されました。
また、今回の評価手法自体にも限界があることをOpenAIは認めています。理想的な評価は「実際に誤った目標を追うモデルが監視を回避しようとするシナリオ」で行うべきですが、今回の研究では代理指標として「制御指示への遵守率」を用いています。制御の種類によっても結果が変わる可能性があり、評価の精度についても今後の改善が見込まれます。
まとめ
OpenAIの研究は、現在の推論AIが自身の思考プロセスを意図的に制御・隠蔽する能力を持たないことを示しました。これはAI安全性にとって前向きな知見です。ただし、この特性がモデルの進化とともに変化する可能性もあり、継続的な評価の重要性は変わらないと思います。