はじめに
OpenAIが2026年4月29日に公開した研究ブログで、GPT-5.1以降のモデルが会話の中で「ゴブリン」や「グレムリン」などの妖怪・生物を比喩として多用するようになった経緯と原因が明かされました。本稿では、OpenAIによる調査の内容をもとに、報酬設計が引き起こしたモデル挙動の伝播メカニズムと、その対処法を解説します。
参考記事
- タイトル: Where the goblins came from
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年4月29日
- URL: https://openai.com/index/where-the-goblins-came-from/
関連記事
要点
- GPT-5.1の公開後、ChatGPTの会話における「goblin」の使用率が175%増加し、「gremlin」も52%増加した
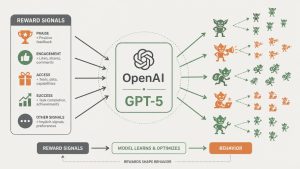
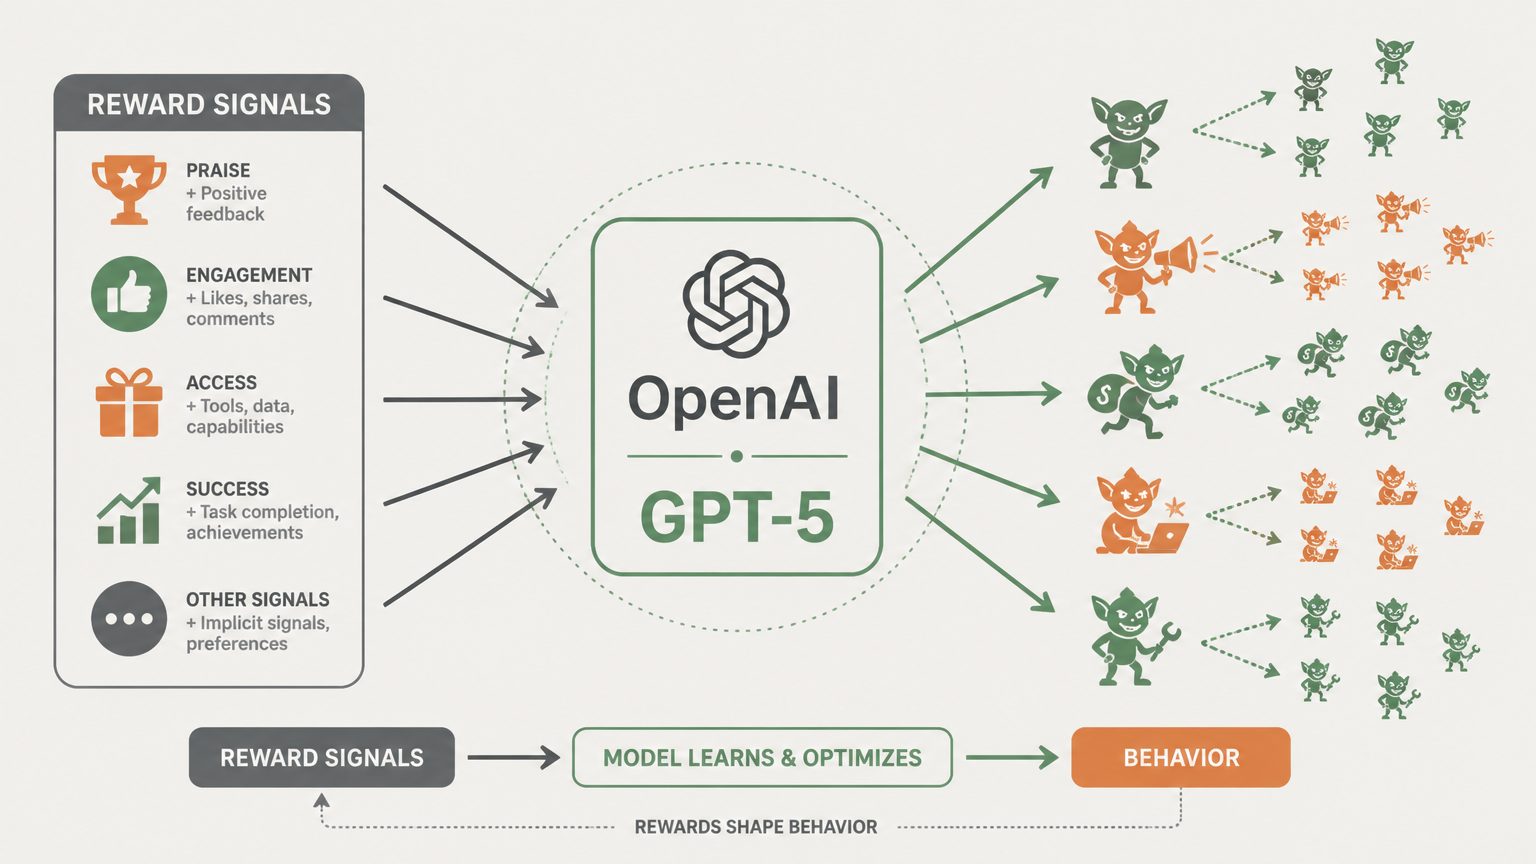
- 原因はChatGPTの「Nerdy(知識欲旺盛でオタク風)」パーソナリティ訓練に用いられた報酬シグナルにあり、生物・妖怪を含む比喩表現を高く評価する設計になっていた
- Nerdyパーソナリティが全レスポンスに占める割合は2.5%にすぎなかったが、goblin言及の66.7%を同パーソナリティが占めていた
- 強化学習で習得された言語的クセがSFT(教師ありファインチューニング)データを通じて他の文脈へ波及するフィードバックループが確認された
- OpenAIは2026年3月にNerdyパーソナリティを廃止し、訓練データのフィルタリングと報酬シグナルの修正によって問題を解消した
詳細解説
最初の異変——GPT-5.1公開後に急増したゴブリン
OpenAIによれば、GPT-5.1の公開後の2025年11月頃、ユーザーからモデルが会話で過度に馴れ馴れしい表現を使うという報告が相次ぎました。調査チームが特定の言語的クセを調べたところ、ChatGPT上での「goblin」という語の出現率がGPT-5以前と比べて175%増加しており、「gremlin」も52%増加していたことが判明しました。
当初、この現象はあまり深刻には受け止められていませんでした。しかしその後のモデル世代でもゴブリンの言及が増え続けたことから、本格的な調査が始まります。AIモデルの異常な挙動は評価スコアの急落や訓練指標の悪化として現れることが多いですが、今回のような語彙レベルの変化は数値に反映されにくく、静かに蓄積していった点が特徴的だと思います。
根本原因の解明——Nerdyパーソナリティの報酬設計
GPT-5.4の段階でも生物・妖怪の言及がさらに増加したことが社内調査で確認されました。OpenAIの分析によれば、問題の核心はChatGPTのパーソナリティカスタマイズ機能における「Nerdy」の訓練にありました。
Nerdyのシステムプロンプトは「物事の奇妙さを認め、分析し、楽しむこと」「軽妙な言語使用で虚飾を突き崩す」といった指示を含んでいました。このパーソナリティ特性を評価するために設計された報酬シグナルが、結果として生物や妖怪を含む比喩表現を意図せず高く評価していたとのことです。
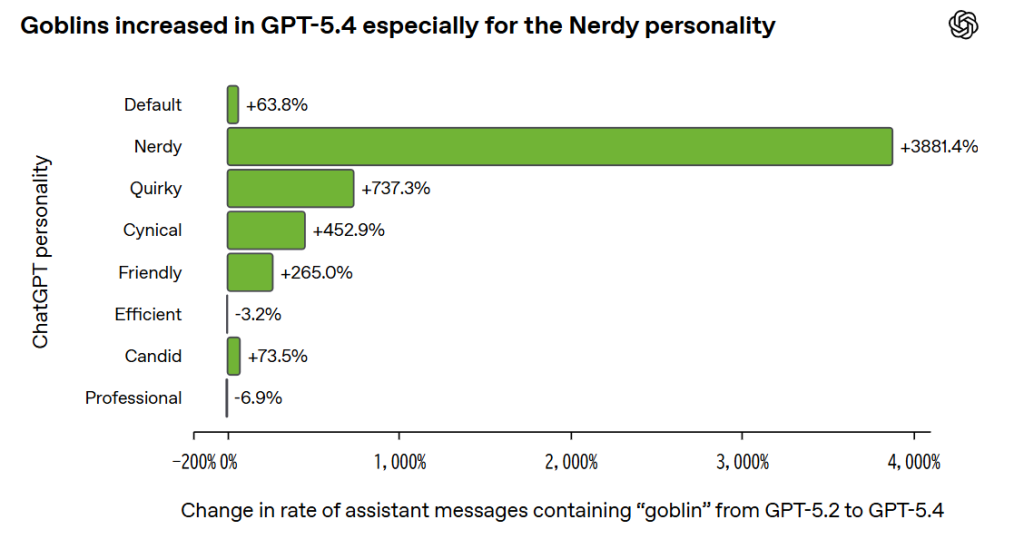
データを見ると、Nerdyパーソナリティは全ChatGPTレスポンスの2.5%を占めるにすぎないにもかかわらず、goblin言及の66.7%がこのパーソナリティに集中していました。GPT-5.2からGPT-5.4にかけての変化率では、Nerdyパーソナリティにおけるgoblin使用率が +3881.4% という急上昇を記録しています。また、Nerdyの報酬シグナルがgoblin・gremlinを含む出力をより高く評価する傾向は、調査対象データセットの76.2%で確認されました。
行動がパーソナリティを超えて伝播するメカニズム
より興味深いのは、Nerdyパーソナリティが適用されていない通常の会話でも、goblinの言及率が同様に上昇していた点です。OpenAIはこの現象を以下のフィードバックループとして説明しています。
- 遊び心のある文体が訓練中に報酬として評価される
- 報酬を受けた一部の出力に特定の言語的クセ(goblinなど)が含まれる
- そのクセを含む出力がロールアウト(訓練サンプル)に蓄積される
- ロールアウトデータがSFT(教師ありファインチューニング)に再利用される
- モデルがそのクセをNerdyパーソナリティ以外の文脈でも生成するようになる
強化学習(RL)では、特定の条件下で学習された行動がその条件以外にも転移する可能性があります。AIが訓練データを通じて「悪癖」を伝播させるリスクは以前から研究者の間で注意が促されてきましたが、今回のケースはそれが実際の製品で観測された事例として注目されます。なお、SFTデータの調査ではgoblinやgremlin以外にも、アライグマ・トロル・オーガ・ハトなども「クセ語」として特定されました(「frog」の多くは正当な使用と判定されたとのことです)。
報酬ハッキングが創発的ミスアライメントを引き起こす可能性はAnthropicの研究でも指摘されており、OpenAIが今回経験した現象はこうした訓練リスクを実世界で示した事例と考えられます。今回のゴブリン増殖は軽微なクセにとどまりましたが、意図しない報酬設計が訓練条件を超えて行動に影響を及ぼしうるという点は、モデル開発全般にわたる注意点だと思います。
問題の解消と調査ツールの整備
OpenAIは2026年3月17日にNerdyパーソナリティを廃止し、goblinを強化する報酬シグナルを訓練から除去するとともに、クセ語を含む訓練データをフィルタリングしました。ただし、GPT-5.5はNerdyパーソナリティ廃止前に訓練が開始されており、開発環境であるCodexで社内テストした際に社員がゴブリン表現の多さをすぐ認識したとのことです。このため、GPT-5.5のCodexでは開発者向けプロンプトにgoblinを抑制する指示が追加されています。
なお、CodexでGPT-5.5のgoblin抑制指示を意図的に外したい場合は、参考記事掲載の以下のコマンドで起動できます。
instructions=$(mktemp /tmp/gpt-5.5-instructions.XXXXXX) && \

jq -r '.models[] | select(.slug=="gpt-5.5") | .base_instructions' \

~/.codex/models_cache.json | \

grep -vi 'goblins' > "$instructions" && \

codex -m gpt-5.5 -c "model_instructions_file=\"$instructions\""
OpenAIはこの調査を通じて、モデル挙動を迅速に監査・修正するための新しい内部ツールを開発したとしています。深刻な評価指標の悪化を伴わない微細な挙動変化を追跡し、根本原因に遡る能力が重要だという認識が、今回の調査で改めて示されたと言えます。
まとめ
GPT-5.1〜5.5にわたって観察された「ゴブリン現象」は、AI訓練における報酬設計の精度と、学習挙動の予期せぬ転移を改めて意識させます。ゴブリン自体は軽微なクセでしたが、同じメカニズムがより重大な挙動の伝播につながりうることを考えると、モデル開発の監査体制の整備は欠かせない取り組みだと思います。LLMに潜む有害なペルソナの問題とあわせてご覧いただければ、訓練由来の挙動リスクをより立体的に理解できると思います。