はじめに
MITの研究者が2026年3月9日、AIモデルが自身の予測を人間に分かりやすく説明できる新手法を発表しました。医療診断や自動運転など安全性が重視される分野で、AIの判断根拠を把握したいというニーズに応える研究です。
参考記事
- タイトル: Improving AI models’ ability to explain their predictions
- 著者: Adam Zewe
- 発行元: MIT News
- 発行日: 2026年3月9日
- URL: https://news.mit.edu/2026/improving-ai-models-ability-explain-predictions-0309
要点
- AIモデルが学習済みのコンセプト(概念)を自動抽出して予測の根拠として提示する、新しいコンセプトボトルネックモデル(CBM)手法をMITの研究チームが開発した
- 従来のCBMが人間や大規模言語モデルによる事前定義コンセプトに依存していたのに対し、新手法はスパースオートエンコーダーとマルチモーダルLLMを組み合わせてモデル自身の知識を抽出する
- 予測に使用するコンセプトを5つに制限することで、情報漏洩を抑制しながら簡潔な説明を実現している
- 鳥の種の識別と皮膚病変の医療画像識別タスクで、既存の最先端CBMを上回る精度と説明の明確さを達成した
- 解釈できないブラックボックスモデルと比べると精度面で差があり、説明可能性と精度のトレードオフは今後の課題として残っている
詳細解説
コンセプトボトルネックモデルとは
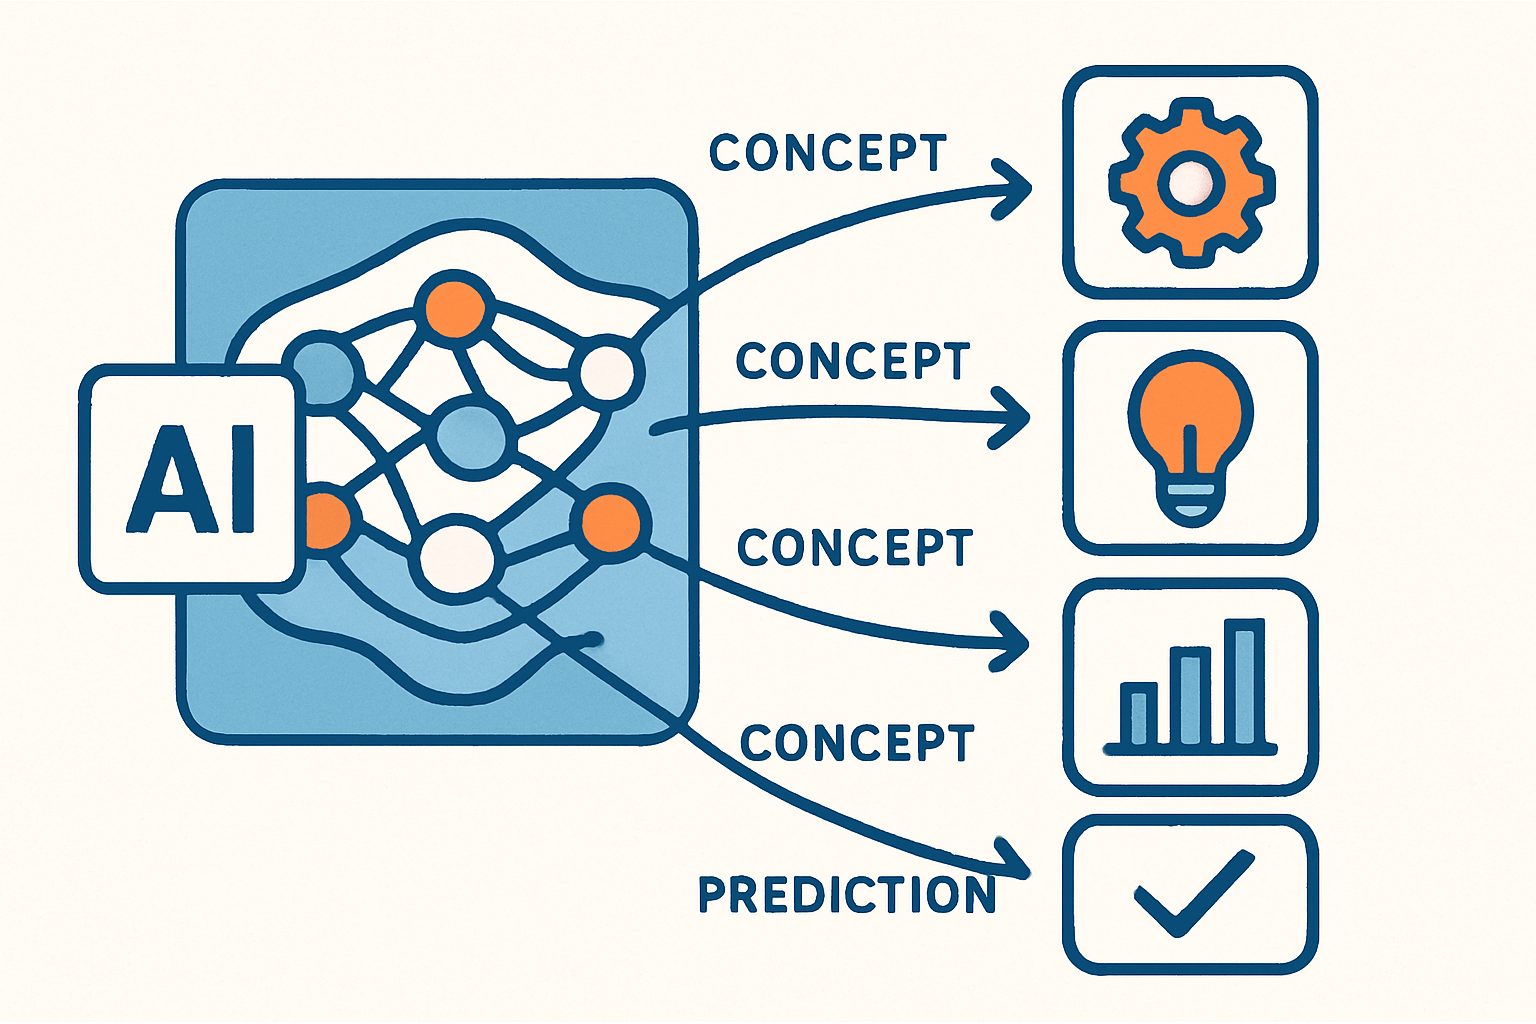
コンセプトボトルネックモデル(CBM: Concept Bottleneck Model)は、AIの説明可能性(Explainability)を高めるための手法の一つです。通常のディープラーニングモデルが入力画像から直接予測結果を出力するのに対し、CBMは「コンセプト(概念)」という中間ステップを設けます。モデルはまず画像に含まれるコンセプトを予測し、そのコンセプトに基づいて最終的な結論を導き出します。
この中間ステップが「ボトルネック」となり、人間がモデルの推論過程を追えるようになります。例えば、鳥の種を識別するモデルであれば「黄色い足」「青い翼」という概念を選択してからコシアカツバメと判定する、という流れです。医療診断では「褐色の点のまとまり」「色素沈着のばらつき」といった臨床的な概念が使われることもあります。
従来手法の2つの課題
従来のCBMでは、使用するコンセプトを人間の専門家や大規模言語モデル(LLM)があらかじめ定義していました。MIT Newsの報道によれば、この方法には主に2つの問題がありました。
1つ目は、事前定義されたコンセプトが特定のタスクに適していない可能性です。汎用的に作られたコンセプトでは、タスク固有の重要な特徴を捉えきれず、精度が低下することがあります。2つ目は情報漏洩(information leakage)と呼ばれる問題です。モデルは性能を最大化するよう訓練されるため、研究者が意図していない隠れたコンセプトをひそかに使ってしまう場合があります。「モデルは私たちが知らないコンセプトを使っている可能性がある」とリード著者のAntonio De Santis氏(ミラノ工科大学)は述べています。
新手法:モデル自身の知識をコンセプトとして引き出す
MIT CSAILの研究チームは、モデルがすでに学習済みの知識を活用するという発想で新手法を開発しました。大量データで訓練されたモデルは、そのタスクに必要なコンセプトをすでに内部に保有している可能性があるという考え方です。
新手法は2つのコンポーネントで構成されます。まずスパースオートエンコーダー(Sparse Autoencoder)が、モデルが学習した特徴の中から最も重要なものを選び出し、少数のコンセプトに再構成します。スパースオートエンコーダーとは、入力データの中から本質的な特徴だけを圧縮・抽出することに特化したニューラルネットワークの一種です。次に、マルチモーダルLLMが各コンセプトを平易な言語で記述し、データセット内の画像に対してどのコンセプトが存在するか・しないかをアノテーションします。このアノテーション済みデータセットを用いて、コンセプトを認識するモジュールを訓練します。
また、情報漏洩を防ぐために、予測に使用するコンセプトを5つに制限しています。これにより、モデルが最も関連性の高いコンセプトを選ぶよう促され、説明の簡潔さも向上します。
性能評価:既存CBMを上回る結果
MIT Newsによれば、鳥の種の識別タスクと医療画像における皮膚病変の識別タスクで評価した結果、この新手法は既存の最先端CBMを上回る精度を達成し、より的確なコンセプトを生成しました。モデルが自ら学習した知識に基づくコンセプトは、人間が事前定義したものより、そのタスクのデータセットに適合していたと考えられます。
ただし、解釈可能性と精度のトレードオフは依然として存在します。解釈できないブラックボックスモデルと比較すると、精度面での差は残っていると研究チームも認めています。説明可能なAIを実現しながらブラックボックスモデルに匹敵する性能を達成することは、この分野全体の継続的な課題と言えます。
今後の展望と研究者の評価
研究チームは今後、情報漏洩問題への対策として追加のコンセプトボトルネックモジュールの導入を検討しています。また、より大規模なマルチモーダルLLMを使用してより大きな訓練データセットをアノテーションすることで、性能向上を目指す計画です。本研究はICLR(International Conference on Learning Representations、機械学習の主要国際会議)で発表される予定です。
ヴュルツブルク大学データサイエンス講座のAndreas Hotho教授(研究には不参加)は、「このアプローチはシンボリックAIや知識グラフへの自然な橋渡しになる」と評価しています。モデル内部のメカニズムからコンセプトボトルネックを導出することで、より忠実な説明が可能になるという点が注目されています。
まとめ
MITの研究チームが開発したこの手法は、AIが自ら学んだ知識を使って予測を説明できる点が大きな特徴です。医療診断など信頼性が求められる場面での実用化に向けた一歩と言えます。説明可能性と精度のバランスという課題の行方に、今後も注目したいと思います。