はじめに
Microsoftリサーチが2026年6月30日、AIエージェントの動作指示(スキル)をディープラーニング的な最適化ループで自動改善するフレームワーク「SkillOpt」を発表しました。本稿では、SkillOptの仕組みと性能評価の結果、そして今後のエージェント開発における意義について解説します。
参考記事
- タイトル: SkillOpt: Agent skills as trainable parameters
- 著者: Yifan Yang, Xuemei Gao, Qi Dai, Bei Liu, Kai Qiu, Dongdong Chen, Chong Luo
- 発行元: Microsoft Research Blog
- 発行日: 2026年6月30日
- URL: https://www.microsoft.com/en-us/research/blog/skillopt-agent-skills-as-trainable-parameters/
関連記事
要点
- AIエージェントのスキル(動作指示ファイル)を「訓練可能なパラメータ」として扱い、モデルの重みを変えずに性能を向上させるフレームワークである
- 6つのベンチマーク・7つのモデル・3つの実行モードにまたがる52の評価セルすべてで、比較手法と同率1位または最高性能を記録した
- GPT-5.5との組み合わせでは6ベンチマーク平均スコアが58.8から82.3へと23.5ポイント向上し、モデルの重み更新なしとしては異例の改善幅である
- 最適化されたスキルファイルは異なるモデルスケール・実行環境・関連タスクにも転用でき、再利用可能なワークフロー知識として機能する
- 最終的なスキルファイルは中央値で約920トークンと小さく、検証ゲートにより1〜4件の編集のみが採用される仕組みで、制御可能かつ監査可能である
詳細解説
従来の課題:スキル編集に「最適化」がなかった
AIエージェントはLLM(大規模言語モデル)を中核に、ツールの呼び出しや多段階タスクの実行を担います。このとき、エージェントの振る舞いを規定するのが「スキルファイル」と呼ばれる自然言語の指示書です。
Microsoftリサーチによれば、従来のスキルは主に3つの方法で作成されてきました。専門家による手書き、フロンティアモデルによるワンショット生成、そして実行後にエージェントが緩やかに改訂する方式です。しかしこれらはいずれも、深層学習のオプティマイザーとは根本的に異なります。ステップサイズの制御も、ホールドアウト検証も、失敗した改訂の記録もないため、スキルはリライトのたびに長くなり、内容が漂流しがちです。一見もっともらしい改訂が実タスクの性能をひそかに下げてしまうこともあります。
この「制御されないスキルの進化」が、エージェントをプロトタイプから本番運用へと発展させる際の大きな障壁になっていると、Microsoftリサーチは指摘しています。
SkillOptの仕組み:テキスト空間での前進・後退・更新
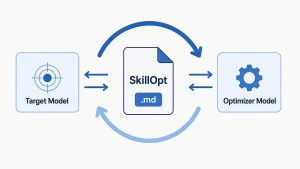
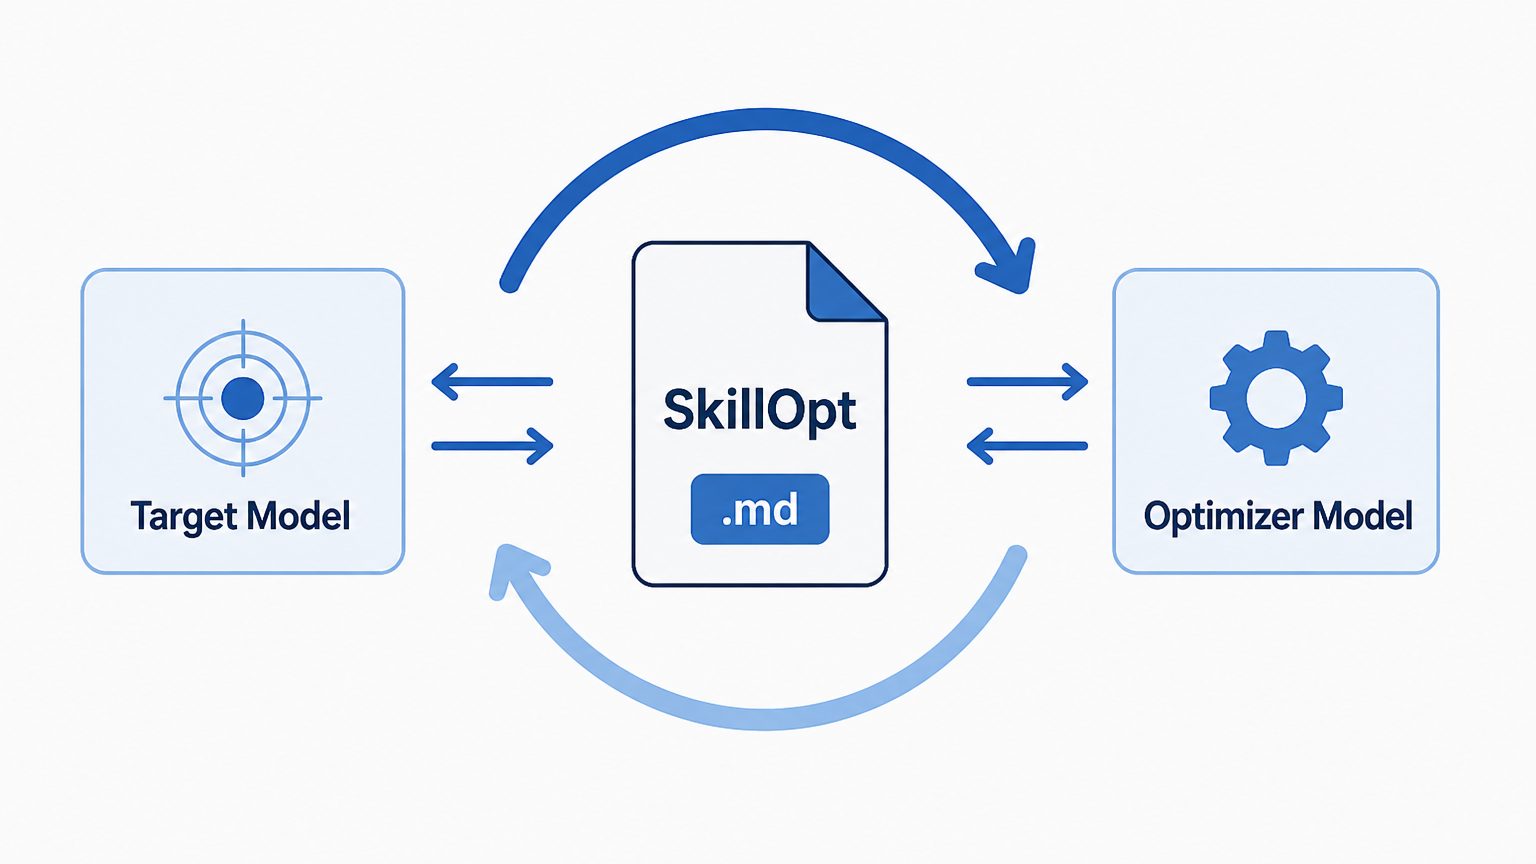
SkillOptは、スキルファイルをフリーズされたターゲットモデルの外側に置かれた「訓練可能なパラメータ」として扱います。モデルの重みには一切手を加えず、スキルの文章そのものを最適化の対象とする点が特徴です。
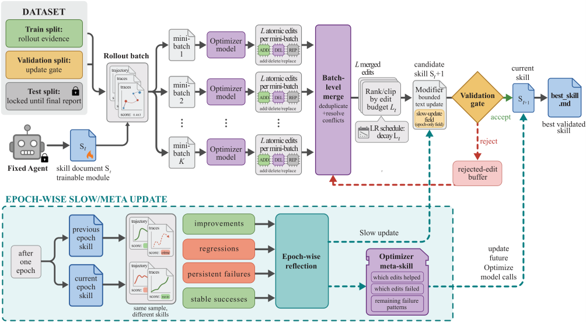
最適化は「前進パス・後退パス・更新ステップ」の3段階サイクルで進みます。前進パスでは、現在のスキルを持つフリーズモデルが訓練タスクのバッチを実行してトラジェクトリ(実行軌跡)を収集します。後退パスでは、別途用意したオプティマイザーモデルがそのトラジェクトリを読み込み、成功パターンの保持と失敗パターンの修正を抽出します。更新ステップでは、追加・削除・置換という小さな編集候補が生成され、「テキスト学習率」(1ステップあたりの編集予算)によって変更量が制御されます。
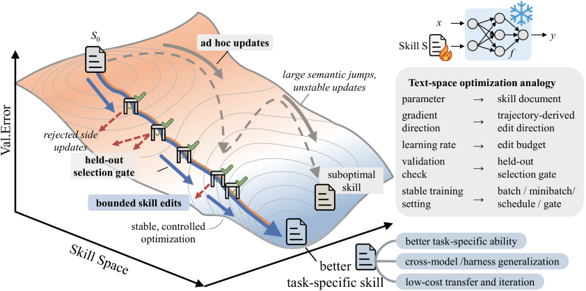
候補スキルは厳格な検証ゲートを通過した場合にのみ採用されます。拒否された編集は廃棄されず、後続のオプティマイザー呼び出しへの「ネガティブフィードバック」として蓄積されます。また、エポック単位で「スロー/メタ更新」が実施され、単バッチでは見えない長期的なパターンが統合されます。この組み合わせにより、スキルは漂流ではなく収束する設計になっています。
ベンチマーク結果:52評価セルすべてで最高性能
Microsoftリサーチは、SearchQA・SpreadsheetBench・OfficeQA・DocVQA・LiveMathematicianBench・ALFWorldの6ベンチマークを使い、GPT-5.5からQwen3.5-4Bまで7種のモデル、ダイレクトチャット・Codex・Claude Codeの3実行モードで評価を実施しました。比較対象は、手書きスキル・ワンショットLLMスキル・Trace2Skill・TextGrad・GEPA・EvoSkillの6手法です。
結果として、52の評価セルすべてでSkillOptは最高または同率1位を記録しました。GPT-5.5のダイレクトチャットモードでは6ベンチマーク平均が58.8から82.3へ、+23.5ポイントの向上です。各ベンチマーク別ではSpreadsheetBenchが41.8→80.7、OfficeQAが33.1→72.1、LiveMathematicianBenchが37.6→66.9と、手順的なタスクで特に大きな改善が見られます。エージェント実行ループでも、Codex上で+24.8ポイント、Claude Code上で+19.1ポイントの改善がそれぞれ確認されています。
注目すべきは、スモールモデルへの波及効果です。最適化後、GPT-5.4-miniの平均スコア(64.3)は無スキルの大型モデルGPT-5.4(59.7)を上回り、4億パラメータのオープンウェイトモデルQwen3.5-4BもGPT-5.2の無スキルベースラインを超えました。モデルサイズを大きくする代わりに、スキルファイルを最適化するという選択肢が現実的になる可能性があります。
スキルの転移性:一度訓練して、どこでも再利用
最適化されたスキルは、特定のモデルやベンチマーク専用の指示書にはなりませんでした。Microsoftリサーチの転移実験では、スキルをモデルスケール・実行環境・関連タスクをまたいで移植した場合でも改善効果が持続しています。
特に顕著な例が、実行環境(ハーネス)をまたいだ転移です。Codex上で訓練したスプレッドシート用スキルをClaude Codeに移植した場合、追加の最適化なしで無スキルベースラインの22.1から81.8(+59.7ポイント)に向上しました。これはClaude Code上で直接訓練した場合の80.4をわずかに上回る結果です。2つのハーネスが異なるツール環境を持つにもかかわらずこの結果が得られたことは、SkillOptがハーネス固有の操作ではなく、汎用的なワークフローロジックを学習していることを示唆しています。
コンパクトで監査可能なスキルファイル
最適化後に出力されるスキルファイル(best_skill.md)は、6つのケーススタディにおける中央値で約920トークンという小さなサイズです。検証ゲートがほとんどの提案を拒否するため、最終ファイルへの採用編集数は1〜4件にとどまります。OfficeQAで+39.0ポイントの改善が「たった1回の編集採用」から生まれているという事実は、品質重視の設計が機能していることを示していると思います。
アブレーション実験によれば、拒否済み編集バッファを外すと全評価ベンチマークでスコアが低下し、メタスキルとスロー更新の両方を除去するとSpreadsheetBenchのスコアが77.5から55.0まで落ちます。各コンポーネントが明確な役割を持って機能していることが確認されています。
まとめ
SkillOptは、エージェントの性能向上をモデル重みの更新ではなく、自然言語スキルの最適化で実現するアプローチです。コンパクトで転移可能なスキルファイルという成果物は、ファインチューニングに代わる軽量なドメイン適応の手段として注目に値すると思います。エージェント開発の実務にどう組み込まれていくか、今後の展開が興味深いです。エージェントのリスク面から気になる方は、MicrosoftのLLMドキュメント編集リスクを扱った記事もあわせてご覧ください。