はじめに
IBM Thinkが2026年3月5日に報じた記事をもとに、ソーシャルメディアで話題になった「洗車テスト」を取り上げます。LLM(大規模言語モデル)が一見シンプルな問いに誤った回答を返す現象を、IBMの研究者たちの見解を交えながら解説します。
参考記事
- タイトル: The viral “car wash” LLM challenge doesn’t mean what you think it means
- 著者: Euny Hong
- 発行元: IBM Think
- 発行日: 2026年3月5日
- URL: https://www.ibm.com/think/news/viral-car-wash-llm-challenge
要点
- 「洗車場が100フィート先にある。歩くか、車で行くか」という問いに対し、多くのLLMが「歩くべき」と回答する現象がSNSで広まった
- IBMの研究者によれば、モデルの規模や「思考」機能のオン・オフが回答の質に大きく影響する
- LLMの誤りの根本には、「ユーザーの意図(user intent)」を把握する能力の限界がある
- LLMはリアルタイムで学習せず、誤りを修正するには正式なトレーニングサイクルが必要である
- 一度SNSで広まった問題は学習データに取り込まれるため、同じ問いで再現することは難しくなる
詳細解説
「洗車テスト」とは何か
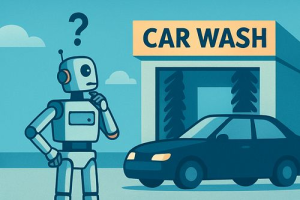
IBM Thinkによれば、「洗車場が100フィート(約30メートル)先にある。歩くか、車で行くか」という問いをLLMに投げかけると、多くのモデルが「歩くべきだ」と回答する現象がRedditなどで話題になりました。あるモデルは「駐車スペースを探す時間のほうが歩く時間より長い。すでに車に乗っていて歩くのが危険な場合のみ、車を使うべきだ」とまで答えたといいます。
SNS上の反応は大きく2つに分かれました。「チューリングテストより先に洗車テストをクリアしろ」とAIを批判する声と、「質問の情報が足りない」とユーザー側の問題を指摘する声です。IBM Distinguished ScientistのChris Hayは、こうした誤りの背景を「LLMは次のトークン(単語)を予測するモデルであり、類似の問いを学習していなければ間違える」と説明しています。
LLM(Large Language Model)とは、大量のテキストデータを学習し、文脈に応じて自然な文章を生成するAIモデルです。その仕組みは、与えられた文脈から「次に来る確率が高い言葉」を順に予測することにあります。
モデルの「思考量」が回答の質を左右する
Hayはさらに、同じLLMでも「思考」に使えるトークン数によって回答の質が変わると指摘しています。ChatGPTを例に挙げ、「auto」「instant」「より長く考えてから回答」といった設定のうち、洗車テストで失敗するのは小規模なモデルや、思考機能をオフにした状態が多いと説明しました。
「モデルが問題に費やせるトークン数が多いほど、正答率が上がる」というこの考え方は、近年注目されている「推論モデル(reasoning model)」の考え方と重なります。複雑な問いほど、単純な即答より段階的な思考プロセスを踏むことが有効と考えられます。
なお、「LLMがユーザーに『なぜ洗車場に行くのですか?』と聞き返せばよいのでは」という意見もSNSには見られましたが、HayはIBM Thinkの取材に対し「それではすぐに煩わしくなる」と述べており、過剰な確認も現実的ではないとしています。
「ユーザーの意図」を理解することの難しさ
IBMシニア研究科学者のMarina Danilevsky は、こうした課題の本質を「ユーザーインテント(user intent)」の問題として整理しています。ユーザーインテントとは、「人が何かを尋ねるとき、その言葉の裏にある本当の意図を理解すること」で、個人の経験や文脈の積み重ねによって培われるものだといいます。
Danilevsky はその例として医師との対話を挙げています。医師は患者の症状から本当の意図(何を心配しているか、何を求めているか)を読み取ることができますが、検索エンジンはキーワードをもとに文書を返すだけで、そのような推論は行いません。LLMはテキストを生成する「ジェネレーター」であり、文書を取り出す「リトリーバー(検索エンジン型)」とは異なるため、検索エンジンよりはユーザーの意図に近いレスポンスを返せることもあります。ただ、いまだ「意図の読み取り」には限界があるということです。
LLMはリアルタイムで学習しない
話題になったもう一つの事例として、「上が密封され、底が開いているカップからどうやって飲むか」という問いがあります。正解は「カップが逆さまなので、ひっくり返せばよい」ですが、LLMの多くは「飲めない」と回答しました。写真を見せても訂正できず、実際にカップを正しい向きにしても「リバーシブルカップに違いない」と答えたといいます。
Danilevsky はこの現象を、LLMがリアルタイムで学習しない性質で説明しています。「LLMは強制されるまで学習しない。誤りを修正するには、それを明示的に伝える必要がある」と述べています。
LLMの誤りを修正するには、モデルを一時オフラインにしてトレーニングサイクルを回す必要があり、数百万人のユーザーが使っている状態でそれを頻繁に行うことは現実的ではありません。「どのくらいの頻度でトレーニングを行うべきか」は、大手テック企業が現在も模索している課題だとDanilevsky は述べています。これはLLMの「カスタマイズ(特定タスクへの適応)」と「パーソナライゼーション(個別ユーザーへの適応)」の違いにも関係する問題で、検索エンジンが個々のユーザー行動に応じて結果を調整するのと異なり、LLMは単一の入力で重みを更新することができません。
「チャレンジ」はなぜ繰り返されるのか
Danilevsky はLLMへのチャレンジが繰り返されること自体に対しても言及しています。「エンジニアリング的な思考様式として、新しい技術を見たらすぐに壊してみたくなる。どこまで機能するかを試したい」という人間の性質が背景にあると指摘しました。
ただし、注意すべき点もあります。一度SNSで広まったテスト問題(洗車テストや逆さカップなど)は、すでにトレーニングデータに組み込まれているため、同じ問いを使って再現実験を行うことはもはや難しいとDanilevsky は述べています。「Redditに載ったから、もう使えない。学習済みだ」という言葉が端的に状況を示しています。
こうした現象を踏まえると、「LLMへの問いかけ自体が意図的に曖昧であれば、機械がユーザーの望む答えを返せないのは当然かもしれない」というDanilevsky の見解は、LLMの限界と同時に、問いを立てる側の責任も示唆していると言えます。
まとめ
「洗車テスト」が示すのは、LLMが常識的な判断を苦手とする場合がある一方、その原因はモデルの規模・思考量・学習データの偏りなど複数の要因が絡み合っているということです。リアルタイム学習の限界やユーザーインテントの難しさを理解した上でLLMを活用することが、より良い使い方につながると思います。