はじめに
Google ResearchのSjoerd van SteenkisteとTal Linzenらの研究チームが2025年1月7日にNature Communications誌で発表し、2026年3月4日にGoogleリサーチブログでも解説された研究を紹介します。LLM(大規模言語モデル)が確率的な信念更新を苦手とする問題に対し、「ベイズ教示(Bayesian teaching)」という手法でその能力を大幅に改善できることを示した論文です。
参考記事
紹介記事:
- タイトル: Teaching LLMs to reason like Bayesians
- 著者: Sjoerd van Steenkiste, Tal Linzen
- 発行元: Google Research Blog
- 発行日: 2026年3月4日
- URL: https://research.google/blog/teaching-llms-to-reason-like-bayesians/
論文情報:
- タイトル: Bayesian teaching enables probabilistic reasoning in large language models
- 著者: Linlu Qiu, Fei Sha, Kelsey Allen, Yoon Kim, Tal Linzen, Sjoerd van Steenkiste
- 発行元: Nature Communications (vol. 17, Article number: 1238)
- 発行日: 2026年1月7日
- URL: https://www.nature.com/articles/s41467-025-67998-6
要点
- 既存のLLMは複数回のユーザーとのやり取りを通じて情報が蓄積されても、推薦精度がほとんど向上しない——つまり「確率的信念の更新」が苦手である
- ベイズ推論の最適戦略を実装した「ベイズアシスタント」の行動をLLMに模倣させるファインチューニング手法(ベイズ教示)により、確率的推論能力が大幅に向上する
- 「正解だけを教えるオラクル教示」よりも「ベイズアシスタントの推測過程を模倣させる教示」の方が、一貫して高い効果を示した
- フライト推薦タスクで訓練したモデルが、ホテル推薦・ウェブショッピングなど未経験のドメインにも汎化した
- ベイズ教示を受けたLLMは、合成ユーザーだけでなく実際の人間ユーザーとのやり取りでも学習効果を示した
詳細解説
LLMの「確率的推論の苦手さ」とは何か
LLMはエージェントとして世界に働きかける場面が増えています。パーソナライズされた推薦や対話型アシスタントとして機能するためには、ユーザーとの複数回のやり取りを通じて「このユーザーは何を好むのか」を徐々に推定し、その推定を新情報に応じて更新していく必要があります。この「信念の更新」を数学的に最適化した枠組みがベイズ推論(Bayesian inference)です。
ベイズ推論とは、「事前確率(prior)」を出発点として、新たな観察(証拠)が得られるたびに「事後確率(posterior)」へと更新していくプロセスです。たとえば「このユーザーは安い便を好む可能性が60%」という推定が、実際に安い便を選んだという観察によって「80%」へと更新されるイメージです。この事後確率が次の推定の事前確率になる——という繰り返しにより、精度が高まっていきます。
Google Researchの研究チームは、こうした確率的信念の更新をLLMがどの程度実行できているかを調べるため、フライト推薦タスクを設計しました。LLMが5回のラウンドを通じてシミュレーションユーザーの好み(出発時刻・フライト時間・乗り継ぎ回数・費用に対する選好)を推定しながら、最適なフライトを推薦するというタスクです。ユーザーの選好は直接伝えられず、各ラウンドでの選択結果からのみ推定する必要があります。
評価対象には、Gemini 1.5 Pro・GPT-4.1 Miniといった商用クローズドモデルに加え、Gemma 2(9B・27B)、Llama 3(8B・70B)、Qwen 2.5(7B・32B)などのオープンウェイトモデルが含まれます。比較対象として、ベイズ理論の最適解を厳密に実装した「ベイズアシスタント」が設定されました。
結果は明確でした。評価したすべてのLLMが、ベイズアシスタントを大幅に下回る精度にとどまりました。特に重要な点として、ベイズアシスタントが情報を蓄積するにつれて着実に精度を高める一方、LLMの多くは1回目のやり取りの後に精度が頭打ちになるという傾向が確認されました。つまり、追加の情報を活かして推定を更新する能力が著しく限られていたわけです。
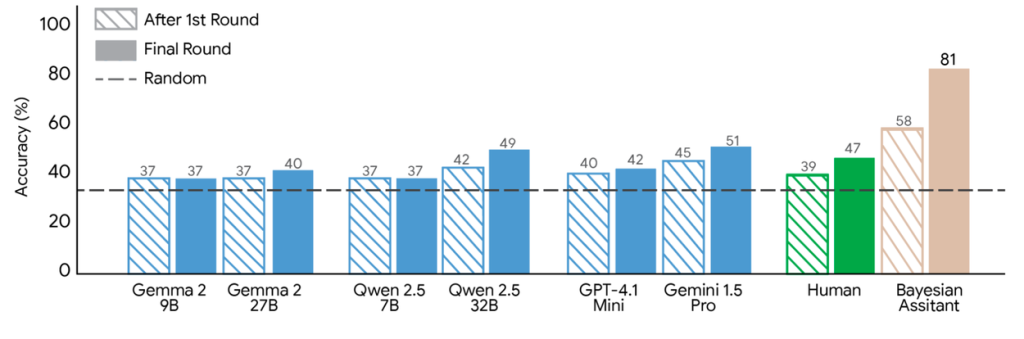
人間参加者とも比較しており、人間はほとんどのLLMよりも多くの改善を示したものの、最適なベイズ戦略には及ばなかったとのことです。「チェーンオブソート(chain-of-thought)プロンプティング」や数値表現の変更、30ラウンドへの延長など各種の工夫を試みても、LLMの性能に大きな改善は見られなかったことも報告されています。
「ベイズ教示」フレームワークの仕組み
こうした限界を受け、研究チームはLLMをベイズアシスタントの振る舞いを模倣させる形でファインチューニングするという手法を提案しました。これが「ベイズ教示(Bayesian teaching)」です。
比較対象として、「オラクル教示(oracle teaching)」も設計されました。こちらは完全なユーザー選好の知識を持つ「オラクルアシスタント」——つまり常に正解を知っており、毎回正しいフライトを選ぶ教師——との対話データでLLMを訓練する手法です。
2つの手法の根本的な違いは何でしょうか。オラクル教示では、LLMは常に「正解」を見ます。一方、ベイズ教示では、LLMはベイズアシスタントの「不確かさを抱えながら最善を推測する過程」を見ます。特に序盤のラウンドでは、ベイズアシスタントもしばしば間違えます。しかし研究チームはむしろ、この「推測の過程」を模倣させる方が、LLMに不確実性を保持しながら信念を更新させる能力を効果的に教えられると仮説を立てました。これはモデル蒸留(distillation)の一形態とも言えます。
ファインチューニングには、Gemma 2 9B・Llama 3 8B・Qwen 2.5 7Bの中規模オープンウェイトモデルが使われました。各ユーザー(624種類の選好パターン)につき10回の対話シナリオを生成し、合計6,240件のファインチューニングデータが用意されました。学習は4枚のH100 GPUを使用し、各モデルで約1時間で完了したとのことです。
実験結果:ベイズ教示の効果
フライト推薦タスクにおける精度向上として、両手法ともにLLMの性能を大幅に改善しました。ファインチューニング後のモデルは、情報が増えるにつれて推薦精度が継続的に向上する傾向を示し、1回目で頭打ちになっていた元のLLMとは明確に異なる挙動を見せました。そしてベイズ教示は、一貫してオラクル教示を上回りました。
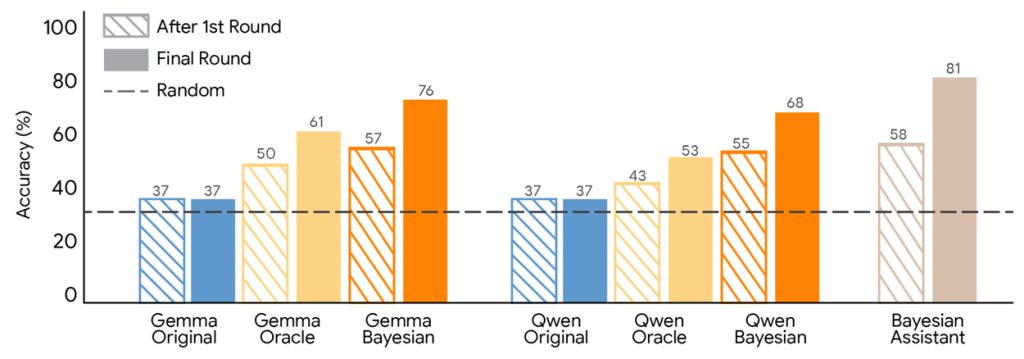
ベイズアシスタントとの一致率も測定されています。ベイズ教示を受けたLLMは、ベイズアシスタントと約80%のケースで同じ予測を行うようになったとのことです。これはオラクル教示後のモデルや元のLLMよりも有意に高い数値です。また、ベイズ教示後のモデルは、情報量の多い選択肢セットからより多くを学習するという「選択肢セットの情報量への感度」も高まることが確認されました。この感度はオラクル教示後のモデルにはほとんど見られなかったとのことで、確率的思考の深化を示す一指標と考えられます。
さらに注目すべきは汎化能力です。フライト推薦タスクで訓練したモデルを、訓練中に見たことのない課題で評価しました。具体的には、フライトの特徴量の数を2〜8個に変化させたバリエーション、ホテル推薦タスク(距離・価格・評価・設備を特徴量とする合成タスク)、そして実在商品を扱うウェブショッピングタスクの3種類です。いずれの場合もベイズ教示後のモデルは元のLLMを大幅に上回り、ベイズ教示はオラクル教示より効果的でした。
ウェブショッピングタスクは特に重要な検証です。このタスクでは選好空間が広大すぎてベイズアシスタント自体を構築することが困難であり、合成的な単純タスクで得たスキルが複雑な現実的ドメインにどこまで移転するかを問うものです。結果として、フライトデータで訓練したモデルはウェブショッピングでも明確な改善を示しました。ただし、ウェブショッピングデータで直接ファインチューニングしたモデルには及ばなかったとのことで、ドメイン固有データの価値も否定されるものではありません。
人間ユーザーへの汎化も検証されました。実際の人間参加者(500名)がユーザー役を担ったシナリオでは、ベイズ教示後のモデルがオラクル教示後のモデルを一貫して上回り、ラウンドを重ねるごとに精度が向上することが確認されました。一方で、人間ユーザーの選択が自分の選好と必ずしも一致しないことから、シミュレーションユーザーの場合より全体的な精度は低くなったとのことです。また元のLLMが人間ユーザーに対して比較的高い初期精度を示したことについては、「安い便を好む」など人間に共通する傾向をLLMがすでに学習しているためと分析されています。
なぜ「正解より推測の過程」が有効なのか
直感に反するようにも見えるこの結果——なぜ「常に正解を教えるオラクル」より「不確実性を抱えた推測を見せるベイズ教示」の方が有効なのでしょうか。
研究チームの解釈では、オラクル教示のデータには「なぜその選択が正しいか」という確率的推論のプロセスが反映されていないのに対し、ベイズ教示のデータにはベイズアシスタントが「現時点の情報でどう最適に推測するか」という過程が示されている点が大きいと考えられます。LLMが次のトークンを予測する訓練を通じて、このプロセスを内在化していくというわけです。言語モデルが単語予測の訓練を通じて構文的な規則を獲得することとの類比として論文では議論されており、確率的推論の原理が同様に内在化されうると示唆しています。
また研究チームは、ベイズ教示後のLLMが「ユーザーの選好について尋ねられたときに、より正確な信念を言語化できる」ことも確認しています。これは単にタスク固有のパターンを暗記したのではなく、ある程度の確率的推論能力を汎用的に獲得した可能性を示しています。
まとめ
本研究は、ベイズ最適モデルの振る舞いを模倣させるという比較的シンプルな手法で、LLMの確率的推論能力を大幅に向上させられることを示しました。訓練ドメインを超えた汎化が確認された点は実用上も重要で、ベイズ教示が多様なインタラクティブAIの設計に活かせる可能性があります。ただし、より大規模なモデルへの適用や連続的・複雑なドメインへの展開については、今後の研究が待たれるところです。