はじめに
OpenAIは2026年7月29日、GPT-5.6の高い性能とコスト効率を支える技術的背景を公式ブログで解説しました。本稿では、推論スタックとエージェント基盤の両面から、GPT-5.6自身が改善作業に関わった経緯も含めて紹介します。
参考記事
- タイトル: How GPT‑5.6 fuses frontier intelligence with frontier efficiency
- 著者: Matthew Ferrari, Phil Tillet, Ahmed Ibrahim, Joe Gershenson, Steve Coffey
- 発行元: OpenAI
- 発行日: 2026年07月29日
- URL: https://openai.com/index/gpt-5-6-frontier-intelligence-efficiency/
関連記事
要点
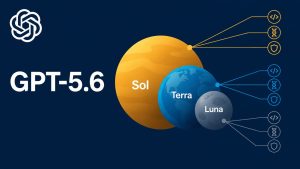
- OpenAIは、GPT-5.6ファミリー(Sol・Terra・Luna)について、いずれも同等以上の性能を従来モデルより低コストで提供していると説明している
- 推論面では、ロードバランシング・カーネル最適化・投機的デコード・KVキャッシュ管理という4つの領域で改善を行い、サービング費用や生成効率を大きく高めたとされている
- ChatGPT WorkやCodexを支えるRust製のエージェント基盤では、コンテキスト肥大化の抑制とプロンプトキャッシュの活用によって、リクエストあたりの処理コストを削減している
- これらの改善の多くは、GPT-5.6 Sol自身がCodexを通じて分析・実験・実装を自律的に担うことで実現されたとOpenAIは述べている
詳細解説
GPT-5.6ファミリーが目指す効率性
OpenAIによれば、GPT-5.6ファミリーは用途ごとのコストと性能のバランスを重視して設計されました。最上位モデルの「Sol」は最大推論設定において、Artificial Analysis Coding Agent Indexでコーディング性能を比較したところ、Claude Fable 5を上回る結果を、その半分未満のコストで達成したと説明されています。中位モデルの「Terra」は前世代のGPT-5.5と同等の知能指標を半額で、最軽量の「Luna」はSolに比べて80%安い価格で提供されているとのことです。
こうした効率化は、モデルが1トークンあたりでより多くの成果を出せるよう学習された結果だと考えられます。タスク達成度と効率性の両方を学習時に最適化することで、遠回りせずに直接的な経路でタスクを解けるようになったと言えそうです。
推論スタックの最適化——ロードバランシングから投機的デコードまで
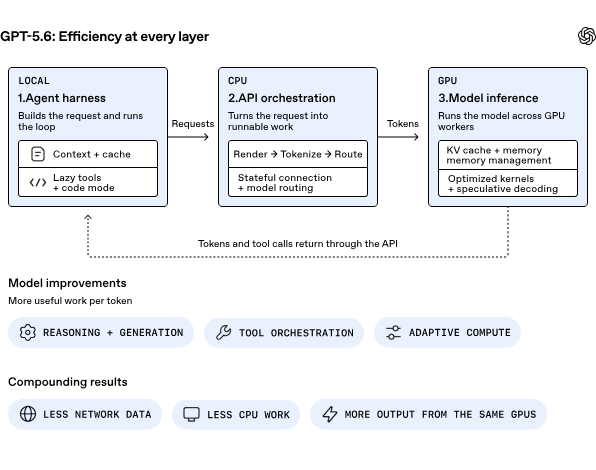
推論とは、学習済みモデルを実際に動かして応答を生成する処理を指します。OpenAIの説明では、地理・利用可能な処理能力・アクセラレータの種類(GPUや専用チップの種類)に応じたグローバルなルーティングに加え、クラスタ内やインスタンス内でも負荷・コンテキスト長・キャッシュの有無に基づく細かな作業分配を行っているとのことです。GPT-5.6 Solは、Codexを通じて本番トラフィックを分析し、これまで見落とされていた偏りを特定し、新しいルーティング戦略をテストする役割を担ったとされ、この改善だけでサービング費用が大きく下がったと報告されています。
カーネル(GPUで実行される演算コード)の最適化では、GPT-5.6 SolがOpenAI製のオープンソース言語であるTritonとGluonを用いて本番カーネルを自律的に書き換え、その正しさは検証ツール「FpSan(浮動小数点サニタイザー)」で確認されたと述べられています。この取り組みにより、エンドツーエンドのサービング費用が20%削減されたとのことです。
投機的デコードは、小型の「ドラフトモデル」が複数トークンを提案し、本体モデルがそれを並列に検証する手法です。提案が採用されれば、1回の本体モデル処理で複数トークンを生成でき、逐次計算の負担を減らせます。GPT-5.6 Solはドラフトモデルのアーキテクチャについて数百件の実験を自ら設計・実行し、学習プロセスの監視やハードウェア障害への対応も自律的に行ったとされ、トークン生成効率が15%以上向上したと報告されています。KVキャッシュ(生成済みトークンの計算結果を再利用する仕組み)についても、バッチサイズやキャッシュ命中率など多数の要因が絡み従来は人手でのチューニングが難しかった設定領域を、GPT-5.6 Solが分析・候補生成・評価まで担うことで、ワークロードごとの最適化が実用的になったと説明されています。
これらの最適化はいずれも一つの指標だけでなく本番環境全体で効果を検証しながら進められており、 継続的な改善サイクル として位置づけられている点が特徴的だと思います。
エージェント基盤の効率化——コンテキスト肥大化とプロンプトキャッシュ
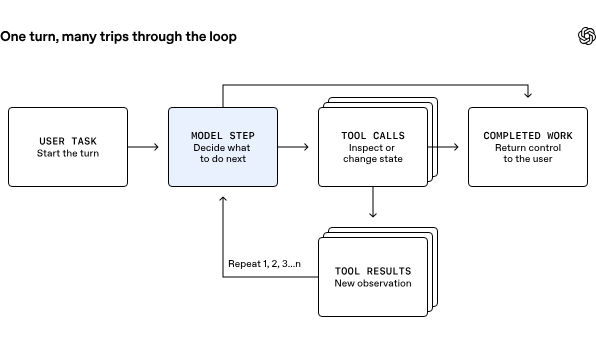
ChatGPT WorkやCodexは、1つのユーザーリクエストに対してコード確認・履歴検索・ファイル編集・テスト実行など複数のモデル呼び出しとツール呼び出しを繰り返しながらタスクを完了します。1つのタスクが30回のモデルリクエストを要する場合、1回あたりのわずかな遅延も積み重なって全体のコストに影響するため、OpenAIはこれらの繰り返し処理を効率化するRust製のオーケストレーション層(エージェント基盤)を設計したとしています。
まず、ツールや会話履歴が増えるほどコンテキストウィンドウが膨らみやすくなる問題に対しては、必要になるまでツール定義やスキル、プラグインを表面化させない「遅延ディスカバリー」という仕組みを導入しています。また、ツールからの出力は、モデルが別の上限を要求しない限り既定で1万トークンに制限されており、想定外のコンテキスト消費を防いでいるとのことです。
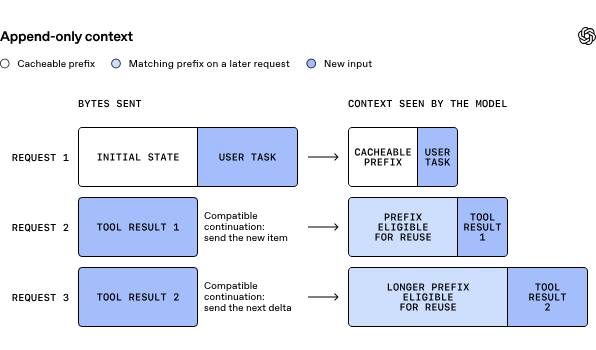
もう一つの工夫がプロンプトキャッシュの活用です。同じ指示や会話履歴、ツール定義を1つのターン内で何度もGPUに送る処理は計算コストが高いため、以前処理したプロンプトの先頭部分(プレフィックス)の計算結果を再利用する仕組みが使われています。これを機能させるため、モデルに見える履歴を追記専用として扱い、新しいメッセージやツール結果は末尾にのみ追加し、過去の内容へ差し込まないよう設計されています。承認ポリシーなどの実行時設定もツール定義に埋め込まず、実行時に適用する形にしており、こうした設計判断がキャッシュ命中率の高さにつながっていると考えられます。
まとめ
GPT-5.6の効率性は、推論とエージェント基盤の両面での積み重ねによるもので、一部はモデル自身が自律的に担ったとOpenAIは述べています。性能面については以前の一般提供開始の記事もあわせてご覧いただければと思います。