はじめに
Google Researchが2025年12月3日、音響知能を測定する包括的なベンチマーク「Massive Sound Embedding Benchmark(MSEB)」を発表しました。NeurIPS 2025で公開されたこのオープンソースプラットフォームは、検索から分類、再構築まで8つのコア機能を統合し、音響ベースのAI研究を前進させることを目指しています。本稿では、MSEBの構造と現行モデルの課題について解説します。
参考記事
- タイトル: From Waveforms to Wisdom: The New Benchmark for Auditory Intelligence
- 著者: Ehsan Variani (Senior Staff Research Scientist, Google Research)
- 発行元: Google Research Blog
- 発行日: 2025年12月3日
- URL: https://research.google/blog/from-waveforms-to-wisdom-the-new-benchmark-for-auditory-intelligence/
- 論文URL:https://openreview.net/forum?id=X0juYgFVng
- GitHubURL:https://github.com/google-research/mseb/tree/main
- DatasetURL:https://huggingface.co/datasets/google/svq
要点
- MSEBは音響知能を測定するオープンソースプラットフォームで、検索、分類、転写、再構築など8つのコア機能を統合している
- 多様なデータセット、包括的な評価タスク、堅牢な評価フレームワークの3つの柱で構成される
- 新たに公開されたSimple Voice Questions(SVQ)データセットは、26ロケール・17言語で177,352件の音声クエリを収録している
- 現行の音響AIモデルには意味理解のボトルネック、目的の不一致、言語間の性能差、ノイズ耐性の欠如、過剰な複雑性という5つの重大な限界がある
- すべての評価タスクで現行アプローチと最大性能の間に大きなギャップが確認され、統一的で堅牢な音響表現の研究が必要とされている
詳細解説
MSEBが解決を目指す課題
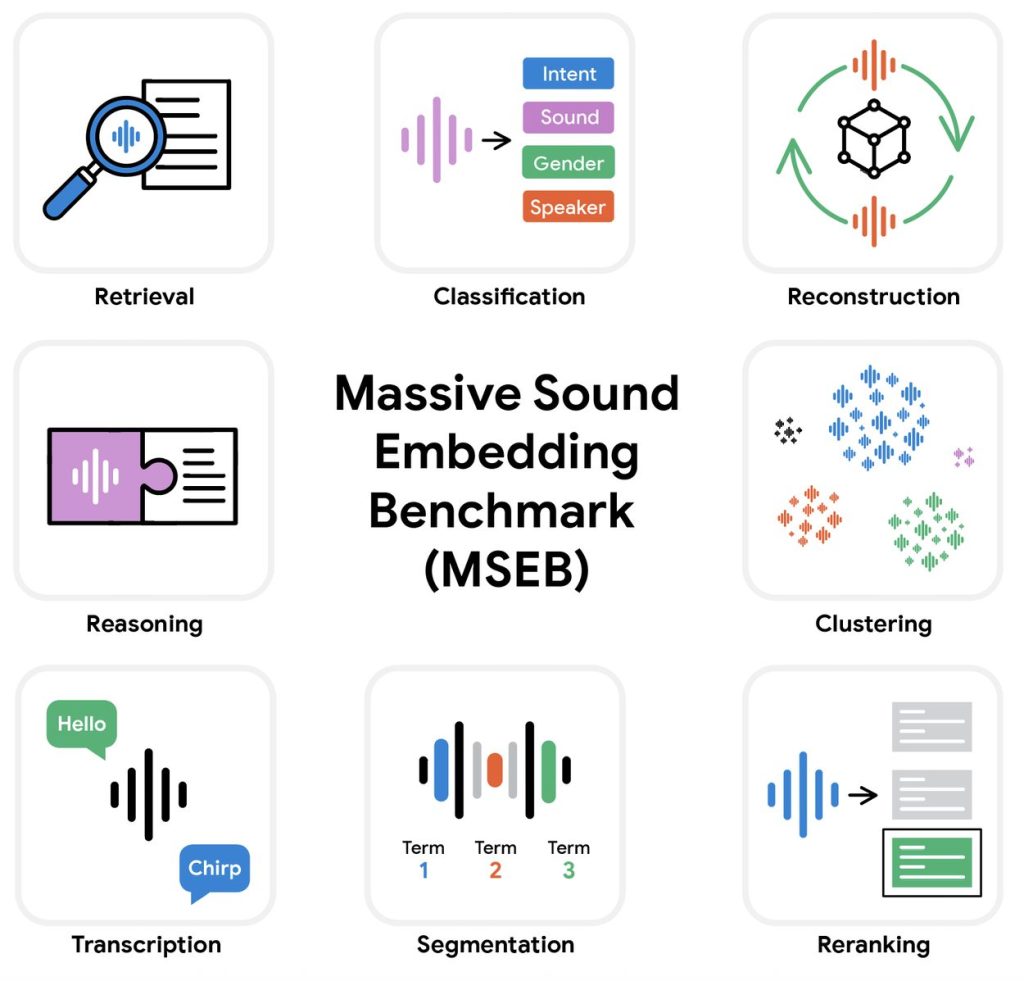
音は、音声アシスタントや自律エージェントなどのシステムが自然に振る舞うために不可欠な要素です。Googleによれば、これらのシステムには転写、分類、検索、推論、セグメンテーション、クラスタリング、再ランク付け、再構築といった多様な聴覚機能が求められます。
これらの機能は、生の音を中間表現である埋め込み(embedding)に変換することに依存しています。埋め込みとは、音響データを機械学習モデルが処理しやすい数値ベクトルに変換したもので、音の特徴を圧縮して保持する技術です。しかし、従来の研究は断片的で、人間の音声と生物音響などの異なるドメイン間での性能比較方法や、単一の汎用音響埋め込みがすべての機能の基盤となり得るかといった重要な疑問が未解決のままでした。
MSEBの3つの柱
MSEBは、次世代の音理解モデル構築に必要なツールを提供するため、3つの基盤で設計されています。
1. 実世界を反映する多様なデータセット
ベンチマークの品質はデータに依存します。MSEBの中核となるのは、新たに公開されたSimple Voice Questions(SVQ)データセットです。このデータセットには、26ロケールと17言語にわたる177,352件の短い音声クエリが含まれており、クリーンな環境、背景音声、交通騒音、メディア騒音という4つの異なる音響環境で収録されました。話者属性や時間整列された重要語句に関する詳細なメタデータも含まれており、Hugging Faceで公開されています。
さらにMSEBは、以下の高品質な公開データセットを統合しています:
- Speech-MASSIVE: 多言語音声言語理解と意図分類用
- FSD50K: AudioSet Ontologyの200クラスを含む大規模な環境音イベント認識データセット
- BirdSet: 複雑な音風景録音を含む鳥類生物音響の大規模ベンチマーク
Googleは、さらに関連性の高い大規模データセットをMSEBに追加する作業を進めており、GitHubリポジトリを通じてコミュニティからの提案や協力を募っています。
2. 8つのコア機能を網羅するタスク設計
MSEBの設計は、AI音響インタラクションの未来がマルチモーダルであるという前提に基づいています。各タスクは音を主要な入力としつつ、テキストコンテキストや知識ベースなど他のモダリティからの情報も組み込み、現実的なシナリオを再現します。
MSEBは8つの「スーパータスク」で構成されています:
- 検索(音声検索): 音声クエリから知識ベース内の関連文書や段落を見つける
- 推論(インテリジェントアシスタント): 音声質問に基づき、文書内から正確な回答を見つける
- 分類(監視/セキュリティ): 話者属性、ユーザー意図、録音環境、特定の音イベントに基づき音を分類
- 転写: 音声信号を逐語的なテキスト表現に変換(自動音声認識)
- セグメンテーション(インデックス化): 音声クリップ内の最重要語句を特定し、開始・終了時刻で位置を特定
- クラスタリング(組織化): 事前定義されたラベルに頼らず、共通属性に基づき音サンプルをグループ化
- 再ランク付け(仮説精錬): 曖昧なテキスト仮説のリスト(ASR出力など)を元の音声クエリに合うよう並べ替え
- 再構築(生成AI): 埋め込みから元の音声波形を再生成できる忠実度を測定
これらのタスクは、情報アクセス(検索、再ランク付け、推論)、基本的な知覚(分類、転写、セグメンテーション)、高次の組織化・生成(クラスタリング、再構築)という幅広い範囲をカバーしています。将来的には、音楽や画像との組み合わせなど、新しいドメインでの実用的なマルチモーダルタスクに焦点を当てる予定とされています。
3. 堅牢な評価フレームワークとヘッドルームベースライン
MSEBの主な目標は、2つの主要なタスクカテゴリで現行AIモデルを評価し、強力なベースラインを確立してヘッドルーム(改善余地)を明らかにすることです:
- 意味的タスク(音声検索、推論など): モデルが音声がノイズを含んでいても、話された言葉の意味と意図を正しく理解できるか
- 音響的タスク(分類、クラスタリングなど): 意味に関係なく、誰が話しているか、環境音が何かを正確に識別できるか
MSEBライブラリのモデル非依存設計により、カスケードシステムから最新のエンドツーエンド音声エンコーダまで、幅広いモデルを標準化された比較フレームワーク内で評価できます。
現行音響表現の5つの重大な限界
Googleは、MSEBフレームワークを使用して現行の音響埋め込みモデルの性能を評価し、真に知的で普遍的なモデルにどれだけ近づいているかを検証しました。意味的タスクではモデルを正解テキスト入力と比較し、非意味的タスクでは現在最良の専用ソリューションと比較してベースラインを設定しました。
評価の結果、現行AIモデルには全ての主要な音理解機能において測定可能な欠陥があることが判明しました。評価には、MRR(平均逆順位)、F1スコア、mAP(平均適合率)、ACC(精度)、WER(単語誤り率)、NDCG(正規化割引累積利得)、VMeasure(クラスタリング評価指標)、FAD(Fréchet Audio Distance)などの指標が使用されました。
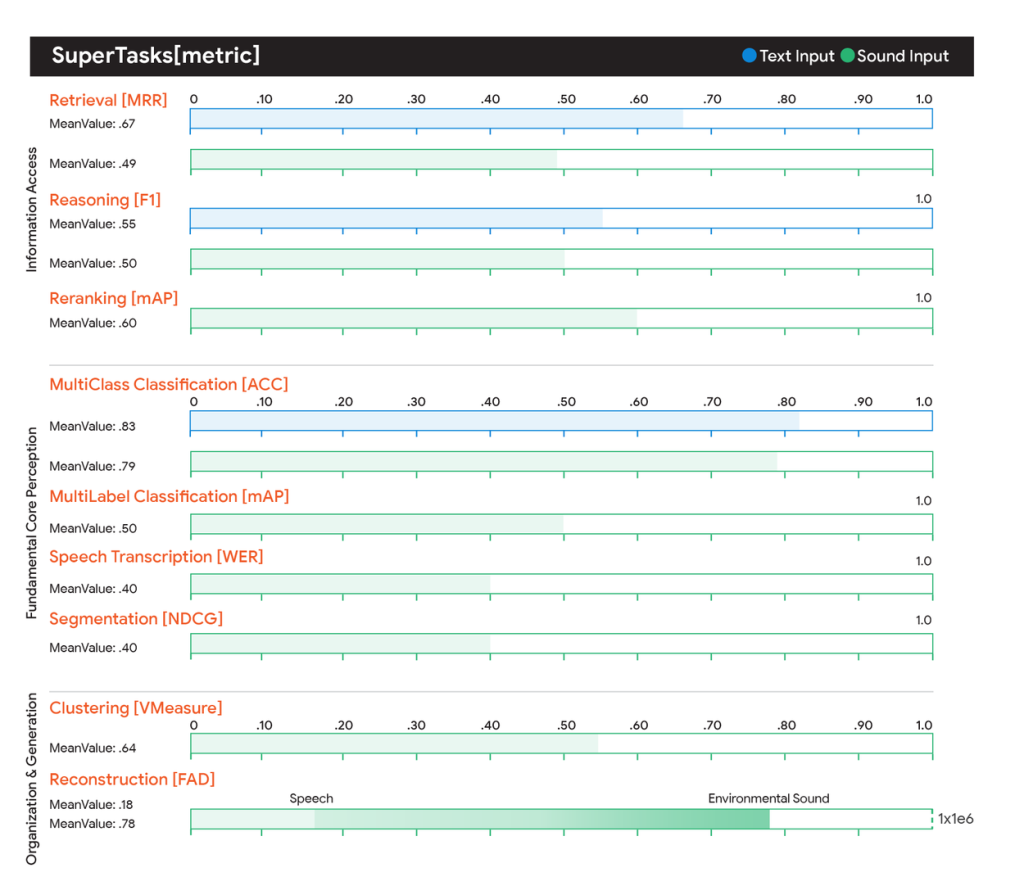
この評価から、音処理AIの能力を現在制限している5つの主要な問題が明らかになりました:
1. 意味的ボトルネック
言語内容に依存するタスク(検索、推論、再ランク付け)では、ASR(自動音声認識)段階が一貫して性能のボトルネックとなり、意味的忠実度の損失をもたらしています。意味的忠実度とは、AIが事実を正しく捉えながらも意味を誤解する問題を指す概念で、音声認識の精度だけでは実際の理解度を測れないことを示しています。
2. 目的の不一致
音声技術の標準的な手法は、音声をテキストに転写してから、そのテキストを全ての下流タスクに使用するカスケードモデルです。Googleによれば、この手法は根本的に誤っています。なぜなら、ASRコンポーネントは単語誤り率の最小化のみを目標に訓練されるため、実世界のアプリケーションが必要とする関連性、精度、推論能力の最大化という目標と大きく乖離しているからです。
従来のカスケード方式では、まず音声をテキストに変換し、次にそのテキストを使って検索や質問応答などのタスクを実行します。しかし、完璧な転写が必ずしも最良の検索結果や回答につながるわけではないため、この2段階のアプローチには構造的な限界があると考えられます。
3. 非普遍性
モデルは信頼性の深刻な欠如を示しており、言語によって性能が大きく異なります。主要な一般的言語では良好に機能しますが、マイナー言語でテストすると転写品質が崩壊し、検索、ランキング、セグメンテーションで重大なタスク失敗を引き起こします。
これは、グローバルなサービス展開を目指す企業にとって重要な課題と言えます。英語や中国語などの主要言語では高性能を示すモデルでも、リソースの少ない言語では実用に耐えない可能性があります。
4. 堅牢性の欠如
ノイズ下で音再構築の品質が急激に劣化します。背景ノイズが導入されると、モデルが元の音と環境を正確に解釈する能力が著しく低下します。これは、忙しいオフィスや騒がしい通りなど、実世界で見られる複雑で一般的な環境音を処理する際のシステムの困難さを浮き彫りにしています。
実用環境では常にある程度のノイズが存在するため、この限界は実装時の大きな障壁となる可能性があります。
5. 過剰な複雑性
意味理解を必要としない単純なタスク(話者識別など)では、複雑な事前学習済みAIモデルが、生の音波の表現を使用するよりも驚くほど優れていないことが判明しました。これは、開発者が基本的なデータで十分な場合に、過度に複雑なモデルに労力を費やしてしまう可能性を示唆しています。
この発見は、タスクの性質に応じて適切なモデルの複雑さを選択することの重要性を示していると考えられます。
MSEBの今後の展望
評価結果は、8つ全てのスーパータスクにわたって、既存の汎用音響ベースアプローチに大きな性能ギャップがあることを示しています。これらの上限によって定義される最大潜在能力に対する広範な性能不足は、機械聴覚知能のギャップを埋めることができる統一的で堅牢な音響表現のさらなる研究の必要性を強調しています。
Googleは、MSEBを音響処理コミュニティ全体のための動的で成長するプラットフォームと位置づけています。独自の音響表現技術の評価へのMSEBの使用、ベンチマークの成長を支援する新しいタスクやデータセットの貢献、機械音響知能の可能性の境界を押し広げる協力的な取り組みへの参加を呼びかけています。
まとめ
Google ResearchのMSEBは、音響AIの性能を包括的に評価する初の統一ベンチマークとして、8つのコア機能と多様なデータセットを提供します。評価結果は現行モデルの5つの重大な限界を明らかにし、意味理解からノイズ耐性まで幅広い改善余地があることを示しました。オープンソースプラットフォームとして公開されることで、コミュニティ全体での音響知能研究の加速が期待されます。