はじめに
Googleが2026年6月9日、リアルタイムの音声間翻訳モデル「Gemini 3.5 Live Translate」を発表しました。70以上の言語に自動対応し、話者の声のトーンや間合いを保ちながら自然な音声を生成する点が特徴です。開発者向けAPIから一般向けアプリまで、同日より順次提供が始まっています。
参考記事
- タイトル: Fluid, natural voice translation with Gemini 3.5 Live Translate
- 著者: Anuda Weerasinghe(Product Manager)、Tony Lu(Senior Staff Software Engineer)
- 発行元: Google
- 発行日: 2026年6月9日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-live-3-5-translate/
関連記事
要点
- Gemini 3.5 Live Translateは70以上の言語を自動検出し、話者のイントネーション・ペース・音程を保ちながら音声間翻訳を生成するモデルである
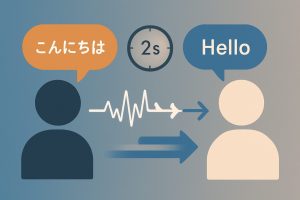
- 従来の「発話終了後に翻訳する」方式ではなく、音声を受信しながら継続的に翻訳を生成するため、話者から数秒遅れで流暢な音声が出力される
- 開発者向けにはGemini Live APIとGoogle AI Studioでパブリックプレビューが開始された
- Google Meetへは法人向けのプライベートプレビューとして今月から導入が始まり、対応言語数が従来の5言語から70以上に拡大される
- Google翻訳アプリ(Android/iOS)でもグローバル展開が開始され、Androidでは「リスニングモード」としてイヤホンなしで耳に当てて翻訳を聞ける新機能が追加された
詳細解説
リアルタイム連続翻訳の仕組み
Googleによれば、Gemini 3.5 Live Translateは音声ストリームを受信しながら並行して翻訳音声を生成する設計になっています。従来の音声翻訳システムの多くは「ターン制」と呼ばれる方式を採用しており、話者が発話を終えてから翻訳処理を始めます。そのため会話の流れに不自然な間が生じやすいという課題がありました。
今回のモデルはこの課題に対し、文脈を待つことと即時翻訳のバランスを動的に調整しながら翻訳を行う仕組みを採用しています。Googleは「話者から数秒遅れを維持しながら、セッション全体を通じて流暢な音声を継続的に出力する」と説明しており、会話の途切れ感を抑えることを重視した設計だと考えられます。
また、騒がしい環境でも動作するノイズ耐性が組み込まれており、屋外や多人数が同席する場所でも実用的に使える点も特徴として挙げられています。言語の事前設定は不要で、複数言語が混在する会話にも自動で対応します。
音声品質の特徴——声の「個性」を保つ翻訳
Googleの発表では、翻訳後の音声が元の話者のイントネーション・ペース・音程を再現する点が強調されています。従来の翻訳音声は機械的なトーンになりやすく、感情や強調のニュアンスが失われることが多くありました。声質そのものを保持した翻訳音声は、通話やプレゼンテーションでの利用時に自然さを大きく向上させると考えられます。
なお、Googleのモデルカードによれば、生成されるすべての音声にはSynthIDによる不可視の電子透かしが埋め込まれます。SynthIDはDeepMindが開発したAI生成コンテンツの検出技術で、音声データに知覚できないレベルで識別情報を付加することで、生成AIコンテンツのなりすましや誤情報拡散の防止を目的としています。
提供形態と対応プラットフォーム
Googleによれば、2026年6月9日時点での提供状況は以下の通りです。
開発者向け: Gemini Live APIとGoogle AI Studioでパブリックプレビューが開始されました。RealTimeメディアのストリーミングインフラを提供するAgoraやLiveKit、Pipecatなどのプラットフォームとの統合にも対応しており、開発者はメディア基盤の構築に時間をかけず、翻訳体験のUI設計に集中できる環境が整いつつあります。
企業向け(Google Meet): 法人向けのGoogle Workspaceを対象としたプライベートプレビューとして今月から開始され、年内に広く展開される予定です。従来のMeet翻訳機能は英語との組み合わせ5言語のみに限定されていましたが、今回の更新で70以上の言語、2,000以上の言語組み合わせに対応します。英語を介さない言語間の直接翻訳が可能になる点は、国際会議での実用性を高める変化だと思います。
一般向け(Google翻訳アプリ): AndroidおよびiOS向けのGoogle翻訳アプリで、すでにグローバル展開が始まっています。新たに追加された「リスニングモード」(Android)では、イヤホンを接続しなくても、スマートフォンを耳に当てるだけで翻訳音声をイヤースピーカーから直接受け取ることができます。観光地でのガイド音声の同時翻訳など、日常の場面での利用が想定されています。
実際の導入事例——GrabとCJ ENM
Googleの発表では、配車・デリバリーサービス「Grab」がこのモデルのテストを進めていることが紹介されています。Grabの最高製品責任者によれば、多言語の自動検出と低遅延での翻訳精度が評価されており、ドライバーと乗客が月間1,000万件以上の音声通話を行うGrabのような環境での活用を見据えています。韓国のコンテンツ企業CJ ENMやLiveKitも、翻訳の品質・精度・低遅延を評価するコメントを寄せています。
Googleは2025年末にもGemini 2.5 Flash Native Audioでリアルタイム音声翻訳の実現を発表していますが、今回はそれを専用モデルとして独立させ、より広い対応言語数と一般向けアプリへの展開という形で実用化を進めた段階と言えそうです。また、Google翻訳20周年の取り組みとして蓄積されてきた翻訳技術が、今回の音声モデルの基盤になっていることも発表の中で触れられています。
まとめ
Gemini 3.5 Live Translateは、発話を遮らずに連続的に翻訳音声を生成し、70以上の言語で話者の声質を保つリアルタイム翻訳モデルです。開発者向けAPIから一般アプリ、企業向けビデオ会議まで幅広い形で展開が始まっており、多言語コミュニケーションの実用性がどこまで高まるか、今後の動きが注目されます。