はじめに
Z.ai(旧ZhipuAI)が2026年4月、エージェントエンジニアリング向け次世代フラッグシップモデル「GLM-5.1」をオープンソースで公開しました。SWE-Bench Proで最高水準の性能を記録し、長時間タスクで持続的に成果を上げる設計が特徴です。本稿では、GLM-5.1とその前世代GLM-5のアーキテクチャ・性能を整理し、SGLang・vLLMを使ったローカルデプロイの実践的手順を解説します。
参考記事
メイン記事:
- タイトル: GLM-5.1 — Model Card
- 発行元: Z.ai / zai-org
- 発行日: 2026年4月
- URL: https://huggingface.co/zai-org/GLM-5.1
関連情報:
- タイトル: GLM-5.1 & GLM-5 — GitHub Repository (README)
- 発行元: Z.ai / zai-org
- 発行日: 2026年4月
- URL: https://github.com/zai-org/GLM-5
関連記事
要点
- GLM-5.1はSWE-Bench Pro(実世界のGitHubイシュー修正ベンチマーク)で58.4%を達成し、掲載された競合モデルの中でトップの数値を記録した
- 従来モデルの「早期頭打ち問題」を克服し、数百ラウンド・数千ツール呼び出しにわたって継続的に最適化できる設計を採用している
- GLM-5はパラメータ数744B(アクティブ40B)のMoEモデルで、DeepSeek Sparse Attention(DSA)を統合しデプロイコストを抑制している
- vLLM・SGLang・Transformers・KTransformersなど主要フレームワーク全てでローカルデプロイが可能で、FP8量子化版も提供されている
- Z.ai APIプラットフォームを通じてAPIサービスとしての利用も可能である
詳細解説
GLM-5.1 と GLM-5:2つのモデルの位置づけ
GLM-5.1とGLM-5は、中国・清華大学発スタートアップのZ.ai(旧ZhipuAI)が2026年4月に公開したモデルシリーズです。どちらも744Bパラメータ(アクティブ40B)のMixture of Experts(MoE)アーキテクチャを採用しており、BF16版とFP8版の両方が提供されています。
本ブログでは以前GLM-4.5を取り上げましたが(→ https://jobirun.com/chinas-ai-price-war-z-ai-glm-4-5/ )、今回のGLM-5.1はその2世代先にあたる次世代フラッグシップモデルです。
GLM-5の技術報告書によれば、前世代GLM-4.7からパラメータ数を355B(アクティブ32B)から744B(アクティブ40B)へ拡張し、事前学習データも23Tトークンから28.5Tトークンへ増量しています。また、DeepSeek Sparse Attention(DSA)を統合することで長コンテキスト処理能力を維持しながらデプロイコストを大きく削減しています。DSAはトークン間の注意計算をスパース化して計算量を削減する技術で、長大なコンテキストを扱うエージェントタスクに特に有効と考えられます。
GLM-5.1はGLM-5のコーディング・エージェント能力をさらに強化したモデルという位置づけです。
長時間タスクでの持続的最適化:核心的な差別化点
Z.aiによれば、従来のモデル(GLM-5を含む)には「早期頭打ち問題」がありました。使い慣れた手法で初期に急速な成果を上げるものの、その後は改善が止まり、計算時間を追加しても効果がないという課題です。
GLM-5.1はこの問題を克服するよう設計されています。具体的には、曖昧な問題に対してより的確な判断を下しながら、複雑な問題を細かく分解し、実験を繰り返して結果を読み取り、ブロッカーを正確に特定できると説明されています。推論と戦略を反復的に見直すことで、数百ラウンド・数千ツール呼び出しにわたって最適化を持続できる点が最大の差別化点です。「長く動かすほど結果が良くなる」という設計は、長時間稼働を前提とするAIエージェント開発にとって実用的な意義があると思います。
同じ中国発オープンモデルのKimi K2も長時間エージェントタスクを強みとしていますが(→ https://jobirun.com/chinese-ai-kimi-k2-explained/ )、後述のベンチマークを見る限り、GLM-5.1はコーディング系タスクで一歩リードしていると言えます。
ベンチマーク性能:開発者が注目すべき指標
GLM-5.1が特に優れた成績を収めているのは、実世界の開発タスクに近いベンチマーク群です。
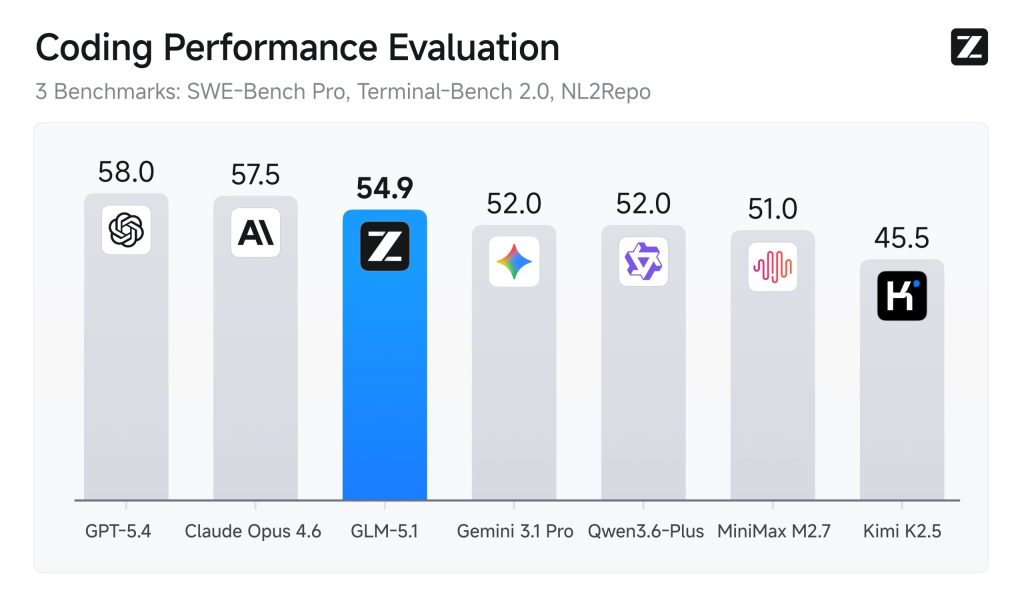
SWE-Bench Pro(GitHub実イシュー修正)はコード生成だけでなく既存コードベースの理解と変更が求められるベンチマークです。Z.aiによれば、GLM-5.1はここで 58.4% を記録しています。掲載された主要モデルと比較すると、Claude Opus 4.6が57.3%、GPT-5.4が57.7%、Kimi K2.5が53.8%となっており、GLM-5.1が最高値となっています。
NL2Repo(リポジトリ自動生成)では42.7%を記録し、GLM-5の35.9%から大きく向上しています。
Terminal-Bench 2.0(実世界のターミナル操作タスク)では63.5%で、Claude Code環境での最良自己報告値は69.0%とされています。
一方、HLE(難問知識問題)やGPQA-Diamondなどの純粋な知識・推論ベンチマークでは、Gemini 3.1 Pro(HLE: 45.0%)やGPT-5.4(HLE: 39.8%)が上位を占めており、GLM-5.1のコーディング・エージェント特化という設計方針が数値にも表れています。用途に応じたモデル選択の判断材料として参考にしてください。
ローカルデプロイ:vLLM と SGLang の実装手順
GLM-5.1はオープンソースモデルとして公開されており、HuggingFaceおよびModelScopeからダウンロードできます。本番環境での利用を想定した場合、FP8量子化版(zai-org/GLM-5.1-FP8)がコスト・性能バランスの観点から現実的な選択肢になると思います。BF16版は精度優先の研究・評価用途に適しています。
vLLM(v0.19.0 以上)
Docker経由での起動が推奨されています。
# Dockerイメージの取得
docker pull vllm/vllm-openai:glm51

# CUDA 13.0の場合
# docker pull vllm/vllm-openai:glm51-cu130
サーブ起動コマンド(テンソル並列 8GPU 構成の例):
vllm serve zai-org/GLM-5.1-FP8 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.85 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 3 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --enable-auto-tool-choice \
  --served-model-name glm-5.1-fp8
SGLang(v0.5.10 以上)
# Dockerイメージの取得
docker pull lmsysorg/sglang:v0.5.10

# CUDA 13.0の場合
# docker pull lmsysorg/sglang:v0.5.10-cu130
サーブ起動コマンド:
SGLANG_ENABLE_SPEC_V2=1 sglang serve \
  --model-path zai-org/GLM-5.1-FP8 \
  --tp-size 8 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --mem-fraction-static 0.85 \
  --served-model-name glm-5.1-fp8
どちらの構成でも –tool-call-parser glm47 と –reasoning-parser glm45 の指定が必要な点に注意が必要です。ツール呼び出しと推論トレースのパーサーを明示することで、エージェントループ内での正確な応答パースが可能になります。
投機的デコード(Speculative Decoding)の設定も含まれており、推論速度の向上が期待できます。SGLangはEAGLEアルゴリズム、vLLMはMTP(Multi-Token Prediction)を使用する構成です。より詳細な設定オプションはそれぞれの公式ドキュメントで確認できます。
その他のフレームワーク
| フレームワーク | 対応バージョン | 用途 |
| Transformers | v0.5.3以上 | 研究・プロトタイプ |
| KTransformers | v0.5.3以上 | 消費者向けGPUでの動作 |
| xLLM | v0.8.0以上 | Ascend NPU対応 |
消費者向けGPUでの動作を目指す場合はKTransformers、Huaweiの Ascend NPU環境ではxLLMが選択肢になると考えられます。
RL 基盤「slime」によるポストトレーニング最適化
GLM-5の技術報告書では、強化学習(RL)基盤として独自開発の slime(非同期RLインフラ)を紹介しています。大規模LLMへのRL適用はトレーニング効率に問題がありましたが、slimeはスループットと効率を大きく改善することで、より細粒度なポストトレーニングの反復を可能にしていると説明されています。モデルの改善サイクルを加速するRLインフラとして、今後の研究への応用も期待できると思います。なお、slimeはGitHub上でオープンソース公開されています(https://github.com/THUDM/slime)。
まとめ
GLM-5.1は、長時間・多ステップのエージェントタスクで持続的な性能を発揮するオープンソースのコーディング特化モデルです。SWE-Bench Proでの最高水準の結果と、vLLM・SGLangを通じた実践的なデプロイ手段が揃っており、AIエージェント構築の選択肢として検討する価値があると思います。FP8版での利用でインフラコストを抑えつつ、エージェントシステムへの組み込みを試してみてはいかがでしょうか。