はじめに
GitHubが2026年2月5日、従来のCI(継続的インテグレーション)を補完する新しい概念「Continuous AI」を公式ブログで発表しました。本稿では、この発表内容をもとに、Continuous AIの仕組みと実用例、そして開発者が今日から試せる具体的な自動化パターンについて解説します。
参考記事
- タイトル: Continuous AI in practice: What developers can automate today with agentic CI
- 著者: GitHub Staff
- 発行元: GitHub Blog
- 発行日: 2026年2月5日
- URL: https://github.blog/ai-and-ml/generative-ai/continuous-ai-in-practice-what-developers-can-automate-today-with-agentic-ci/
要点
- Continuous AIは、判断や推論を必要とするタスクのためにリポジトリ内で動作するバックグラウンドエージェントを指す
- 従来のCIはルールベースの自動化に優れているが、文脈や意図の理解が必要なタスクには対応できない
- 自然言語でタスクの期待を記述し、エージェントがプルリクエストや課題などの成果物を生成する
- デフォルトで読み取り専用アクセスを持ち、明示的に許可された操作のみを実行するSafe Outputsの仕組みがある
- ドキュメントと実装の不一致修正、継続的な翻訳更新、依存関係の変更検出など、7つの実用例が示されている
詳細解説
Continuous AIの基本概念
GitHubによれば、Continuous AIは「リポジトリ内で動作するバックグラウンドエージェント」として定義されます。ただし、これは従来のCIジョブのように動作しますが、ルールではなく推論を必要とするタスクにのみ使用される点が特徴です。
GitHub NextのIdan Gazit氏は「ヒューリスティックに還元できない判断を必要とするタスクは、AIが非常に役立つ領域です」と説明しています。例えば、docstring(関数の説明文)が実装と一致しているか、テキストが技術的には正しくてもユーザーにとって分かりにくくないか、といった判断は、単純なルールでは表現できません。
Continuous AIは、このような「意図が保たれているか」を評価するタスクに焦点を当てています。従来のCIは決定論的な検証(テストの合否、ビルドの成功など)に優れていますが、文脈依存の判断には対応できなかったと言えます。
なぜ従来のCIだけでは不十分なのか
GitHubの発表では、CIが失敗しているわけではなく、設計された目的を正確に果たしていると説明されています。CIは二値的な結果(成功/失敗)のために設計されており、明確に定義された違反を検出するリンターやテストに適しています。
しかし、エンジニアリングの最も困難な部分は、判断を必要とする作業であることが多いと指摘されています。具体的には以下のようなシナリオです:
- ドキュメントの記述と実装が異なる
- アクセシビリティのリントは通過するが、実際にはユーザーにとって分かりにくいテキスト
- 依存関係が新しいフラグを追加し、メジャーバージョンを上げずに動作を変更する
- 正規表現がループ内でコンパイルされ、パフォーマンスが微妙に低下する
- UIの動作変更が製品と対話した時にのみ明らかになる
これらの問題は「意図が保たれているか」に関するもので、ルールベースの自動化では対応が難しいと考えられます。Gazit氏は「AIのコード生成は第一の時代でした。第二の時代は認知と、開発者から認知的に重いタスクを取り除くことです」と述べています。
Continuous AIの実際の意味とパターン
GitHubの説明によれば、Continuous AIは新しい製品やCIの置き換えではありません。むしろ、一つのパターンとして定義されています:
Continuous AI = 自然言語ルール + エージェント的推論、リポジトリ内で継続的に実行
実際には、コードについて真であるべきことを平易な言葉で表現し、特にヒューリスティックに還元できない期待を記述します。エージェントがリポジトリを評価し、開発者がレビューできる成果物(パッチの提案、課題、ディスカッション、インサイト)を生成します。
重要な点として、開発者はエージェントのワークフローを一度で作成することは稀だと説明されています。実際には、エージェントと協力して意図を洗練させ、制約を追加し、許容される出力を定義します。ワークフローは反復を通じて形成されます。
例えば、以下のような指示が考えられます:
- 「文書化された動作が実装と一致しているか確認し、不一致を説明し、具体的な修正を提案する」
- 「プロジェクトの活動、新たなバグの傾向、変更が増加している領域を要約した週次レポートを生成する」
- 「重要なパスでのパフォーマンス低下を検出する」
これらのワークフローは簡潔さで定義されるのではなく、決定論的なルールとしてエンコードすることが困難または不可能な期待を表現するために、意図、制約、許可された出力を組み合わせていると言えます。
設計による安全対策:権限とSafe Outputs
GitHubは、エージェントワークフローを安全性を第一原則として定義していると説明しています。デフォルトでは、エージェントはリポジトリへの読み取り専用アクセスを持ちます。明示的に許可されない限り、課題の作成、プルリクエストのオープン、コンテンツの変更はできません。
この仕組みは「Safe Outputs」と呼ばれ、エージェントが実行できることについての決定論的な契約を提供します。ワークフローを定義する際、開発者はエージェントが生成できる成果物(プルリクエストのオープン、課題の提出など)とその制約を正確に指定します。
この境界外のものは禁止されます。このモデルは、エージェントが失敗したり予期しない動作をする可能性があることを前提としています。出力はサニタイズされ、権限は明示的で、すべての活動がログに記録され監査可能です。影響範囲は決定論的と考えられます。
GitHubは「これは『AIがソフトウェア開発を乗っ取る』ことではなく、開発者が明示的に定義したガードレール内でAIが動作することです」と強調しています。
自然言語がYAMLを補完する理由
GitHubの発表では、「なぜCIをより多くのルールで拡張しないのか」という質問に対する回答が示されています。問題が決定論的に表現できる場合、CIの拡張が正しいアプローチであり、YAML、スキーマ、ヒューリスティックがそれらのタスクに適したツールのままだとされています。
しかし、多くの期待は、意味を失わずにルールに還元できないと説明されています。例えば、「ドキュメントとコードが乖離した時、それを特定して修正する」というルールは、正規表現やスキーマでは表現できません。これにはセマンティクスと意図の理解が必要です。自然言語の指示は、エージェントがそれを推論するのに十分明確にその期待を表現できると考えられます。
自然言語はYAMLを置き換えるのではなく、補完するものとされています。CIは基礎として残り、Continuous AIは、CIが処理するように設計されていなかったコマンドへと自動化を拡張します。
開発者が常にループ内に留まる設計
GitHubによれば、エージェントワークフローは自律的にコミットを行いません。代わりに、ワークフローが実行を許可されている内容に応じて、開発者が作成するのと同じ種類の成果物(プルリクエスト、課題、コメント、ディスカッション)を作成できます。
プルリクエストは、開発者が既に変更をレビューし推論する方法と一致するため、最も一般的な出力とされています。Gazit氏は「PRは、開発者が作業をレビューすることを期待する既存の名詞です。それは全員が集まるチェックポイントです」と述べています。
これは以下を意味します:
- エージェントはコードをマージしない
- 開発者は完全な制御を保持する
- すべてが可視化されレビュー可能
開発者の判断が最終的な権限として残り、Continuous AIはその判断をコードベース全体にスケールさせるのを支援すると考えられます。
GitHub Nextの実験とプロトタイプ
GitHubは、GitHub Nextプロトタイプ(gh aw)が意図的にシンプルなパターンを使用していると説明しています:
- エージェントワークフローを書く
- GitHub Actionにコンパイルする
- プッシュする
- エージェントがGitHub Actionsのトリガー(プルリクエスト、プッシュ、課題、コメント、スケジュール)で実行される
すべてが透明で可視化されています。Gazit氏は「スタイル違反のためのセクションが必要なら、それはヒューリスティックです。しかし、より深い意図のチェックが必要な場合は、AIが必要です」と説明しています。
Continuous AIが今日自動化できる7つのタスク
GitHubは、これらが理論的な例ではなく、実際のリポジトリでテストされたパターンだと説明しています。
1. ドキュメントと動作の不一致を修正
これは、意図の理解を必要とするため、CIにとって最も困難な問題の一つとされています。エージェントワークフローは以下ができます:
- 関数のdocstringを読む
- 実装と比較する
- 不一致を検出する
- コードまたはドキュメントへの更新を提案する
- プルリクエストをオープンする
Gazit氏は、これをContinuous AIが対処できる最も意味のある作業カテゴリーの一つと呼んでいます。「コードを出荷するたびに、ドキュメントがまだ正しいか心配したくないでしょう。それは以前はAIなしでは自動化できませんでした」
2. 推論を伴う継続的なプロジェクトレポートを生成
GitHubによれば、メンテナーとマネージャーは、同じ質問に繰り返し答えるために多くの時間を費やしています。昨日何が変わったか?バグは増加傾向か減少傾向か?コードベースのどの部分が最も活発か?
エージェントワークフローは、複数のデータソース(課題、プルリクエスト、コミット、CI結果)から情報を取得し、その上に推論を適用する定期的なレポートを生成できるとされています。例えば:
- 日次または週次の活動を要約する
- 新たなバグの傾向を強調する
- 最近の変更とテスト失敗を相関させる
- 変更が増加している領域を明らかにする
価値はレポート自体ではなく、手動分析を必要とする複数のデータソースにわたる統合にあると考えられます。
3. 翻訳を自動的に最新に保つ
ローカライズされたアプリケーションを扱った経験がある人なら、このパターンを知っているとGitHubは説明しています。英語のコンテンツが変更されると翻訳が遅れ、チームはリリース直前にまとめて作業することが多いと指摘されています。
エージェントは以下ができます:
- 英語テキストが変更されたことを検出する
- すべての言語の翻訳を再生成する
- 更新を含む単一のプルリクエストをオープンする
ワークフローは断続的ではなく継続的になります。機械翻訳はすぐには完璧ではないかもしれませんが、プルリクエストでレビュー可能な翻訳ドラフトを持つことで、プロの翻訳者やコミュニティ貢献者からの支援を得やすくなると考えられます。
4. 依存関係のドリフトと文書化されていない変更を検出
GitHubによれば、依存関係はメジャーバージョンを変更せずに動作を変更することがよくあります。新しいフラグが表示され、デフォルトが変わり、ヘルプ出力が進化します。
あるデモでは、エージェントが以下を実行しました:
- 依存関係をインストールする
- CLIヘルプテキストを検査する
- 前日との差分を取る
- 文書化されていないフラグを発見する
- メンテナーが気付く前に課題を提出する
これには単なる差分ではなく、意味的な解釈が必要であり、古典的なCIでは処理できない理由だと説明されています。Gazit氏は「これはAIの新しいフェーズの最初の兆候です。生成から推論へと移行しています」と述べています。
5. 自動化されたテストカバレッジのバーンダウン
ある実験では、以下の結果が得られたとされています:
- テストカバレッジが約5%から100%近くまで向上
- 1,400以上のテストが作成された
- 45日間にわたって
- 約80ドル相当のトークンで
エージェントが毎日小さなプルリクエストを生成したため、開発者は変更を段階的にレビューできたと説明されています。
6. バックグラウンドでのパフォーマンス改善
リンターとアナライザーは、コードの意図を理解することに依存するパフォーマンスの落とし穴を常に捕捉するわけではないとGitHubは説明しています。
例:関数呼び出し内で正規表現をコンパイルし、呼び出しごとにコンパイルされる場合。
エージェントは以下ができます:
- 非効率性を認識する
- 正規表現を事前コンパイルするようにコードを書き換える
- 説明付きのプルリクエストをオープンする
頻繁に呼び出されるコードパスでは、小さなことが積み重なると考えられます。
7. 自動化されたインタラクションテスト(決定論的なプレイテスターとしてのエージェント)
GitHubは、これが普遍的でより創造的なデモの一つだったと説明しています。エージェントを使用してシンプルなプラットフォーマーゲームを何千回もプレイし、UXの劣化を検出するものでした。
ゲームを取り除くと、パターンは広く有用と考えられます:
- オンボーディングフロー
- 複数ステップのフォーム
- 再試行ループ
- 入力検証
- インタラクション下でのアクセシビリティパターン
エージェントは大規模にユーザー行動をシミュレートし、バリアントを比較できるとされています。
最初のエージェントワークフローの構築方法
GitHubによれば、開発者はこれを試すために新しいCIシステムや別のインフラストラクチャを必要としません。GitHub Nextプロトタイプ(gh aw)はシンプルなパターンを使用しています:
- Markdownファイルに自然言語ルールを書く
例:
—
on: daily
permissions: read
safe-outputs:
create-issue:
title-prefix: “[news] “
—
リポジトリの最近の活動を分析し:
– 活動についての明るい日次ステータスレポートを作成
– 活動に基づいてプロジェクトを改善するエージェントタスクの説明を提供
レポートで課題を作成する
- アクションにコンパイルする
gh aw compile daily-team-status
これにより、GitHub Actionsワークフローが生成されます。
- YAMLをレビューする
何も隠されておらず、エージェントが何をするか正確に確認できます。
- リポジトリにプッシュする
エージェントワークフローは、定義したスケジュールまたはリポジトリイベントに応じて、他のアクションと同様に実行を開始します。
- 作成された課題をレビューする
次に注目すべきパターン
GitHubは、まだ初期段階ですが、開発者ワークフローでいくつかの傾向が既に現れていると説明しています:
パターン1:自然言語ルールが自動化の一部になる
開発者は意図を表現する短い英語のルールを書くようになると考えられます:
- 「翻訳を最新に保つ」
- 「パフォーマンス低下を検出する」
- 「安全でないように見える認証パターンについて警告する」
パターン2:リポジトリが小さなエージェントの群れをホストし始める
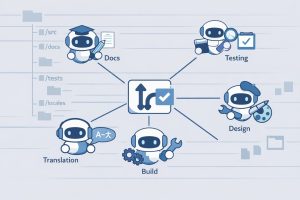
一つの汎用エージェントではなく、多くの小さなエージェントがあり、それぞれが一つのタスク、一つのチェック、または一つの経験則に責任を持つと予測されています。
パターン3:テスト、ドキュメント、ローカリゼーション、クリーンアップが「継続的」モードに移行する
これは初期のCI運動を反映しており、開発者を置き換えるのではなく、タスクが発生するタイミングを「誰かが思い出した時」から「毎日」に変えることだとされています。
パターン4:デバッガビリティが複雑さに勝つ
開発者は、透明で監査可能で差分ベースのエージェントパターンを採用し、可視性なしに動作する不透明なシステムは採用しないと考えられます。
まとめ
GitHubが提唱するContinuous AIは、従来のCIが対応できなかった判断を必要とするタスクを自動化する新しいパターンです。自然言語でワークフローを記述し、Safe Outputsにより安全性を確保しながら、ドキュメント更新、翻訳管理、依存関係の監視など、7つの実用的な自動化例が示されました。GitHubのGazit氏は「以前は外注できなかったものが、今は可能になります」と述べており、開発者が小さなワークフローから始めることを推奨しています。