はじめに
Cursorは 2026年8月17日 、大規模なGitホスティングを支える「Continuity」と「Origin」の設計を公開しました。本稿では、従来のSpokes方式の制約と、S3上の先行書き込みログ(WAL)を正本にする仕組みを整理します。
参考記事
- タイトル: あらゆる規模のGit
- 著者: Vicent Martí
- 発行元: Cursor
- 発行日: 2026年8月17日
- URL: https://cursor.com/ja/blog/git-at-any-scale
関連記事

要点
- Gitはオブジェクトをたどる際にpackfile内をランダムに読むため、単純な分散ファイルシステムやオブジェクト単位のKVSとは相性がよくない
- 従来のSpokesはローカルNVMe上の通常のGitリポジトリと三相コミットで強い一貫性を実現したが、レプリカ数を増やすほどpushが遅くなる
- ContinuityはS3上のWALを信頼できる情報源にし、ローカルのGitリポジトリを再生成可能なウォームキャッシュとして扱う
- すべての読み取りをS3上のETagで検証し、レプリカ数を1台から数百台まで負荷に応じて変えられる
- Cursorの合成試験では最大100レプリカまで読み取りが線形に伸び、S3 Standardで最大120 push/秒、S3 Express One Zoneで300 push/秒超を確認した
詳細解説
Gitの分散設計がサーバー側を難しくする
Gitのオブジェクトは内容から計算したハッシュで識別され、commit、tree、blobが有向非巡回グラフを構成します。ローカル環境では効率的ですが、サーバー側で巨大なリポジトリを扱う場合は、packfile内の離れた位置を何度も読む処理が発生します。ネットワーク越しにオブジェクトを一つずつ取得する設計では往復遅延が積み上がり、clone時にGitが期待するpackfileを再構成する負担も増えます。
そのため、Cursorは「Gitを別のデータモデルへ置き換える」のではなく、通常のGitリポジトリを高速なNVMeへ置く方針を維持しました。既存のGitクライアントやOSSの最適化をそのまま利用できることは、性能だけでなく互換性と運用の面でも重要です。
Spokesが実現した一貫性と限界
GitHubが2013年ごろに開発したSpokesは、packfileを複数サーバーへ配布し、reference transactionだけを三相コミットで同期します。pushされたオブジェクトは参照が更新されるまで見えないというGitの性質を利用し、過半数の承認後に変更を公開します。これにより、push直後のfetchや多数のCI runnerによるcloneでも同じcommitを確認できます。
一方、各段階の待ち時間は最も遅いレプリカに左右されます。巨大なモノレポへ数多くのレプリカを追加するとpush性能が落ち、使い捨ての小規模リポジトリにも複数コピーが必要です。さらに、ディスク上の各コピーが正本であるため、配置台帳、チェックサム、破損検出、修復を常に管理しなければなりません。
ContinuityはWALを正本にする
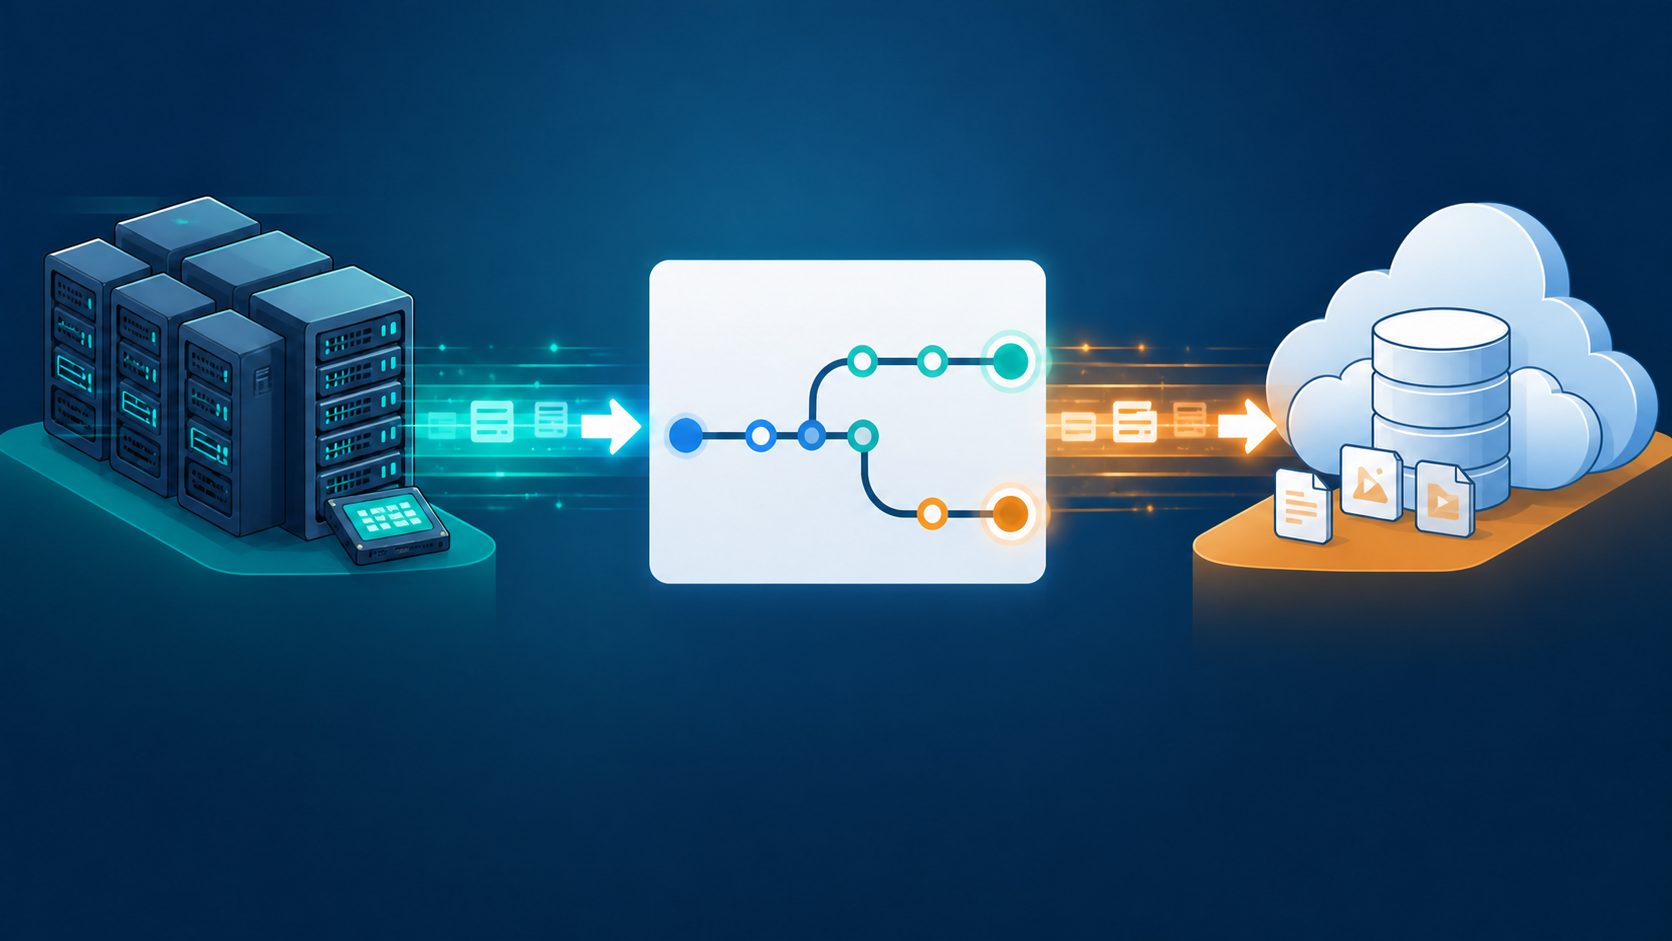
ContinuityではpushをS3互換オブジェクトストレージへWALエントリとして保存し、完全に永続化されるまで受理しません。ローカルでreference transactionの準備が完了し、WALインデックスへのポインタを原子的に更新して初めて変更が見えるため、pushは線形化可能です。更新はS3のcompare-and-swapで同期し、特定サーバーを恒久的なprimaryとして管理する必要をなくしています。
ローカルのリポジトリは正本ではなくウォームキャッシュです。あるノードに対象リポジトリがなければWALから再構成できます。通常はランデブーハッシュでアクセス先を決めますが、ルーティング情報が一時的にずれてもデータの正しさは失われません。運用上の状態を減らしながら、一貫性の根拠をS3へ集約した設計です。
高速化と検証を分けたレプリケーション
レプリカ間ではUDPのgossipで新しいpushを通知します。UDPは到達保証がありませんが、通知は高速化のための手段にすぎません。実際の読み取りではレプリカが把握するWALインデックスのETagを使ってS3へ条件付きGETを行い、304ならそのまま提供し、200なら最新状態へ追いついてからcloneやfetchを返します。
この分離により、大規模モノレポには数百レプリカ、低頻度の小規模リポジトリには1台、休眠中は0台という調整が可能です。Cursorの合成試験では100レプリカまで読み取り性能が線形に増えました。ただし、120 push/秒や300 push/秒超は同社の試験・環境での値であり、すべてのワークロードにそのまま当てはまる保証ではありません。
コンパクションを一度だけ行う
pushのたびにpackfileが増えると、Gitは多数のインデックスを探索する必要があります。Continuityではprimaryだけが再パックを行い、その結果をWALへ記録します。他のレプリカはCPU負荷の高い再パックを繰り返さず、コンパクション済みpackをS3から取得します。CPU消費を帯域幅へ置き換え、クラスター全体で同じ作業を重複させない考え方です。
AIエージェントによってコード、PR、CI実行が増えるほど、バージョン管理基盤は表面に見えにくいボトルネックになります。Continuityの価値はS3を使ったことだけでなく、正しさを担保する経路と、性能を高める経路を分離した点にあります。自社基盤へ応用する場合も、まず「正本は何か」「キャッシュは捨てて復元できるか」「読み取り前に何を検証するか」を明確にすることが重要です。
まとめ
Continuityは通常のGitをNVMeで扱う利点を残し、S3上のWALを正本にしました。Originはその設計で増え続けるclone、fetch、pushへ対応します。公開値はCursorの環境での結果ですが、一貫性と運用性を両立する考え方は社内開発基盤にも参考になります。