はじめに
Anthropicは2026年7月24日、公式ブログでモデル選定の考え方を解説する記事を公開しました。本稿では、Mythos・Opus・Sonnet・Haikuという4つのモデルクラスの特徴と、業務でモデルを選ぶ際に確認すべき判断基準について紹介します。
参考記事
- タイトル: Claude models explained: choosing the best model for your use case
- 著者: Anthropic
- 発行元: Anthropic公式ブログ(claude.com)
- 発行日: 2026年7月24日
- URL: https://claude.com/blog/claude-models-explained-choosing-the-best-model-for-your-use-case
関連記事
要点
- Anthropicは基本方針として、まず最も高性能な提供可能モデルを選び、そこから効果水準(effort level)を調整して性能とコストを最適化することを推奨している
- モデルファミリーはMythos/Fable、Opus、Sonnet、Haikuの4クラスで構成され、扱える課題の難易度と速度・価格のバランスが異なる
- Mythos/Fableは同一モデルの2パッケージ展開で、Mythosは信頼された組織向け、Fableは一般提供用に追加の安全対策を施したものである
- 「アドバイザー戦略」と呼ばれる手法では、低コストのモデルが必要な場面でのみ高性能なモデルに計画確認や評価を仰ぐことで、コストを抑えつつ性能を高められる
- 高性能モデルはベンチマークが飽和しやすいため、実運用や自社の課題から抽出した独自評価を用いた判断が推奨されている
詳細解説
モデルファミリーの全体像
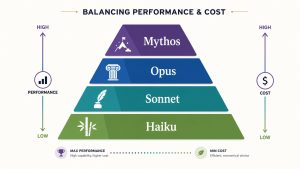
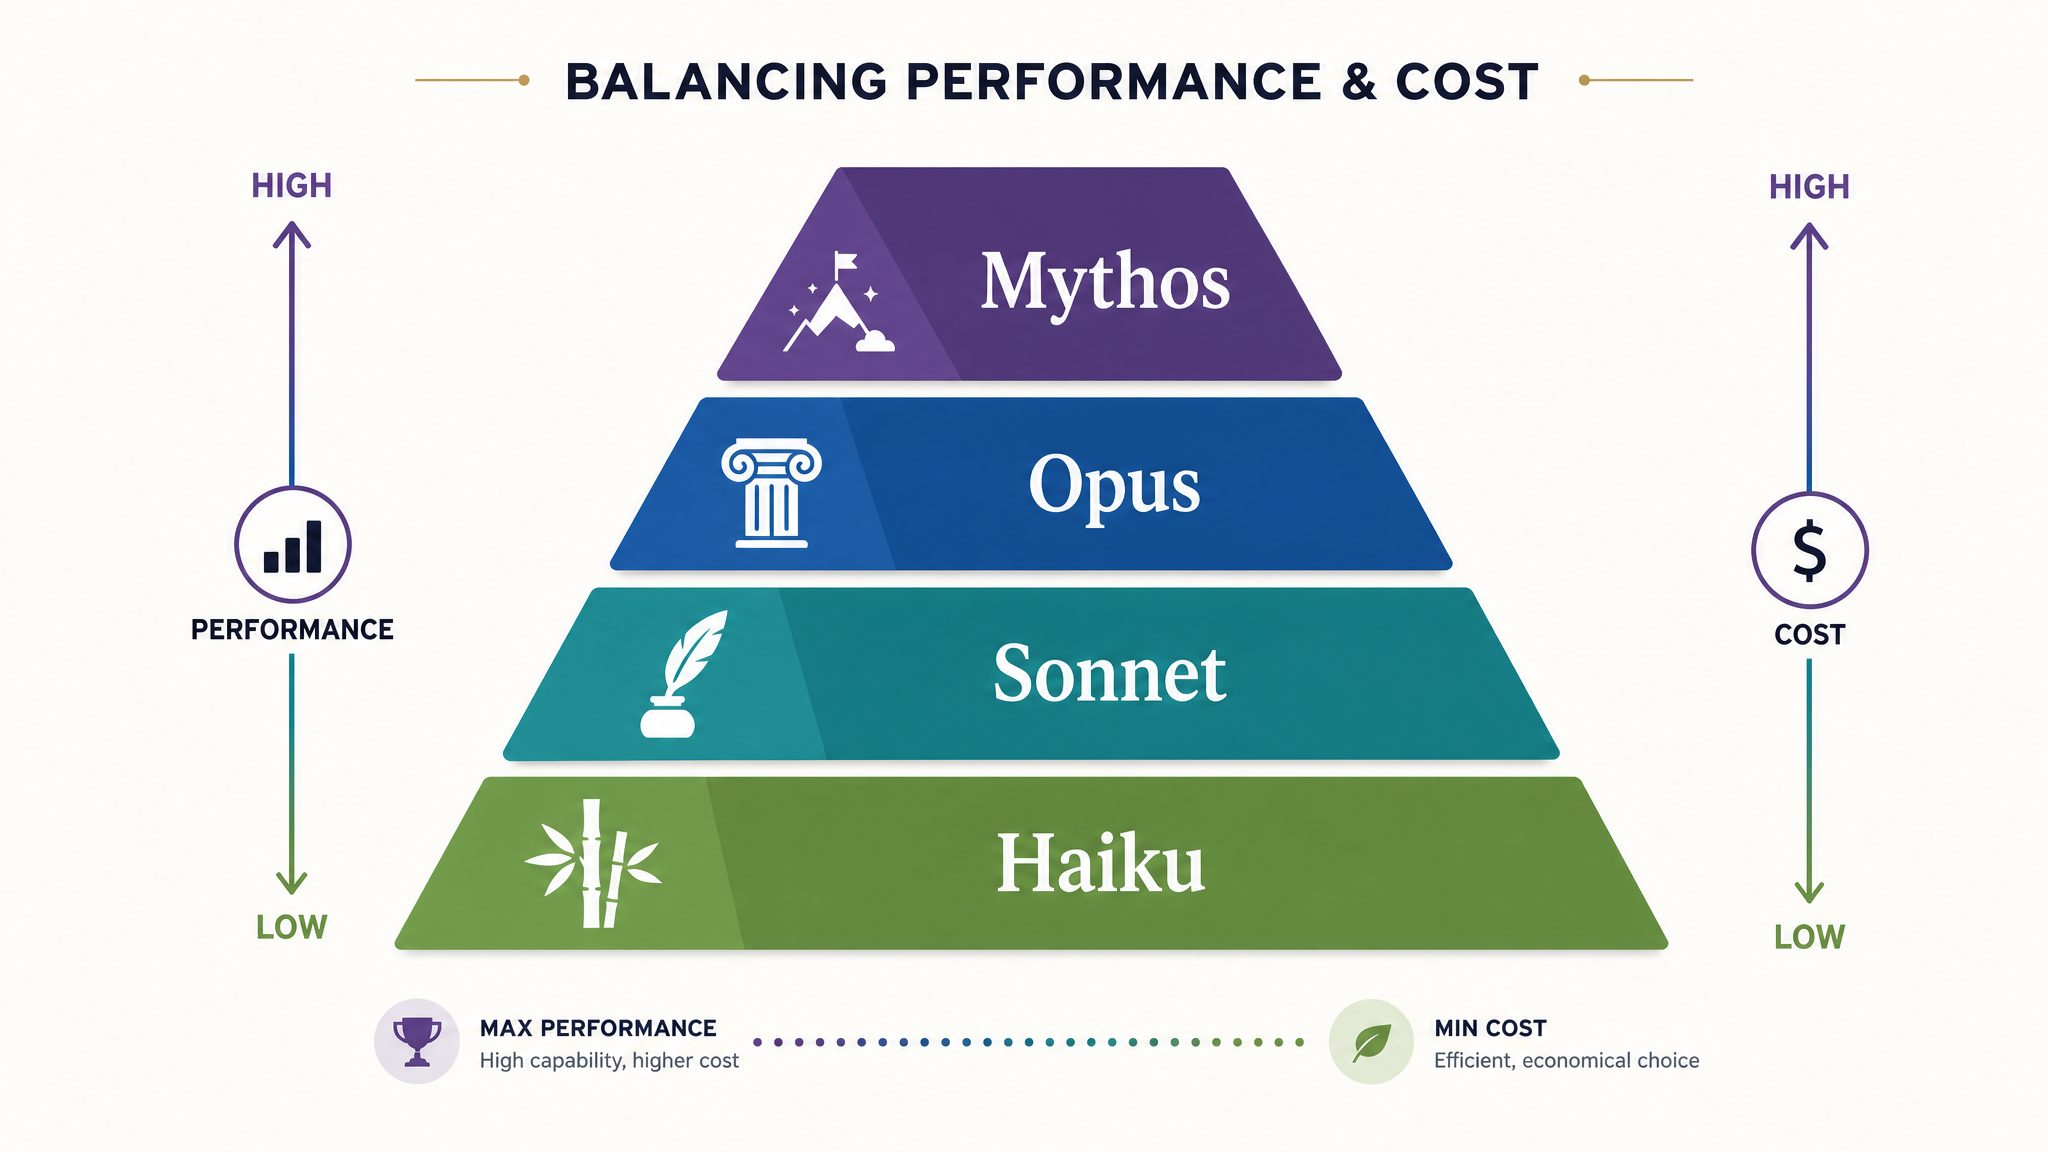
Anthropicによれば、モデルファミリーは4つのクラスで構成されています。最上位に位置する「Mythos」は、コーディングや長時間稼働するエージェントタスク、これまでAIが安定して扱えなかった問題に強みを持つとされています。同クラスは同一モデルの2パッケージ展開で、サイバーセキュリティや生物学分野のデュアルユース(民生・軍事の両方に応用しうる用途)業務を扱う信頼された組織向けが「Claude Mythos」、一般提供用に追加の安全対策を施したものが「Claude Fable」です。両モデルとも、安全に利用するためデータの保持期間が限定されているということです。
Fable 5については、サイバー安全対策の詳細や輸出規制解除の経緯もAnthropicが公開しており、上位クラスのモデルほど提供にあたっての制約が伴う場合があることがうかがえます。「Opus」は推論を重視するエンタープライズ向けの強力なクラスで、知識労働の評価指標「GDPval-AA」やエージェント型コーディングの指標「Terminal-Bench 2.1」といった主要ベンチマークで上位にランクインしているとのことです。汎用モデルの「Sonnet」は幅広い日常業務に向いており、多数のサブエージェントを動かすマルチエージェント構成でも使われています。最も低コストで高速な「Haiku」は、高頻度で低遅延が求められる用途に適した位置づけです。
タスクの難易度・アクセス制約・コストという判断軸
Anthropicは、モデルを選ぶ際に確認すべき観点として、タスクの難易度、レイテンシ要件、アクセス制約、単位当たりのコストの4点を挙げています。時間がかかる、複数の手順を要する、これまで解けなかったといった課題ほど、より高性能なクラスが適しているとされています。一方、顧客対応など高頻度でレイテンシが重視される場面ではSonnetが適していることが多いということです。
アクセス制約についても留意が必要です。MythosはProject Glasswingという枠組みのもとで一部の組織にのみ提供されており、すべての組織・役割にすべてのクラスが開放されているわけではありません。このように、性能だけでなく提供体制の違いも選定材料になる点は、実務上見落としやすいポイントだと思います。単価が高いモデルでも、少ない対話回数や短い思考時間でタスクを終えられれば、タスクあたりのコストはむしろ低くなる場合があるとされており、単純な価格比較だけでは判断しづらい面があると考えられます。
アドバイザー戦略によるコストと性能の両立
Anthropicが提唱する「アドバイザー戦略」は、高速で低コストなワーカーモデルが、必要な場面でのみより高性能なモデルに計画のチェックや評価を仰ぐという手法です。Anthropicによれば、SWE-bench ProにおいてFable 5をアドバイザーに据えたSonnet 5は、Fable 5単体でタスク全体を実行する場合の価格の63%で、性能差を10%以内に抑えられたということです。
常に最上位モデルだけを使う場合と比べて、必要な場面に限って高性能モデルを呼び出す設計は、コストを抑えながら品質を確保する実践的な手立てになると考えられます。複数モデルを組み合わせるアーキテクチャを検討する際の参考になりそうです。
ベンチマークの限界と評価のあり方
Anthropicは、OpusやFableのような高性能モデルは、あらかじめ用意された課題のほぼすべてを解けてしまう「飽和」と呼ばれる状態が起きやすいと指摘しています。ベンチマークは複数のモデルやプロバイダーの傾向をつかむ指標として有用ですが、上位クラス同士の比較では差が見えにくくなるとのことです。そのため、実運用での利用や、自社の本番業務から抽出した課題をもとにした独自の評価(カスタムeval)で判断することが推奨されています。
性能差が僅かになりやすい上位クラスの比較では、自社のタスクに即した評価基準を別途整えることが、遠回りに見えて実は確実な判断材料になるのではないかと思います。
まとめ
Anthropicは、モデル選定に万能な正解はなく、タスクの難易度や用途を理解した上で、評価の仕組みを継続的に整えることが重要だとしています。単価ではなくタスクあたりのコストで比較するという視点は、GPUのコスト評価に関する過去記事とも通じる考え方だと思います。