はじめに
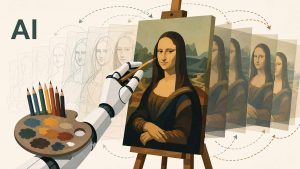
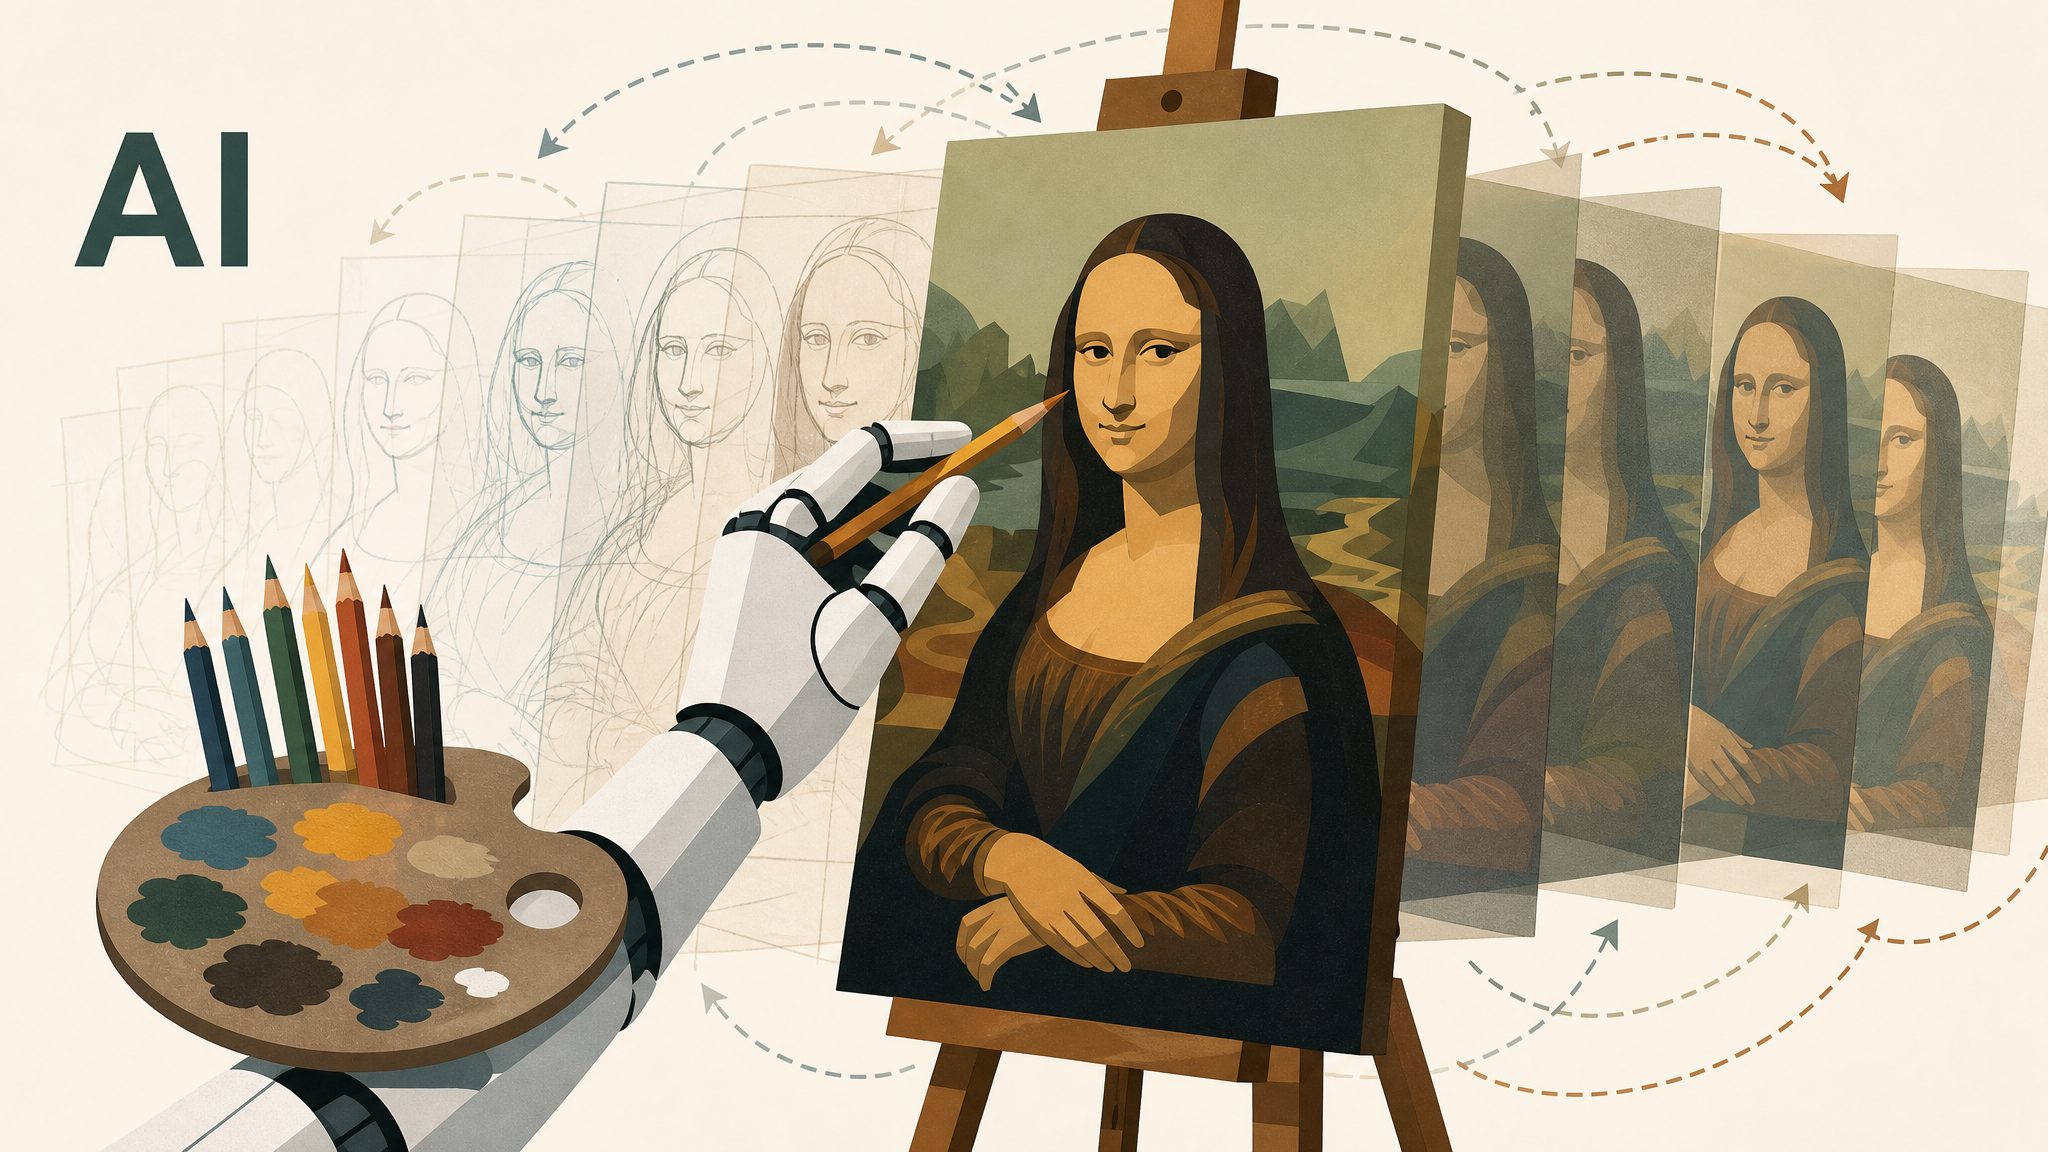
AIスタートアップTryAIが2026年7月24日、IBM Thinkで紹介した実験では、GPT-5.6 Sol、Claude Fable 5、Grok 4.5、Gemini 3.6 Flashに素朴な描画ツールだけを与え、モナリザなどの模写に挑戦させました。本稿では実験結果と自己修正の傾向を解説します。
参考記事
- タイトル: Researchers gave AI models some colored pencils to copy the Mona Lisa. They kept making it worse
- 著者: Antonia Davison
- 発行元: IBM Think
- 発行日: 2026年7月24日
- URL: https://www.ibm.com/think/news/ai-models-drawing-mona-lisa-overrevise
関連記事
要点
- AIスタートアップTryAIは、GPT-5.6 Sol、Claude Fable 5、Grok 4.5、Gemini 3.6 Flashの4モデルに、色鉛筆型のシンプルな描画ツールのみを与えてモナリザや「星月夜」の模写に挑戦させる実験を実施した。
- スコアが記録された8件の制作すべてで、最終的な作品の評価は制作途中のピーク時点を下回った。
- Gemini 3.6 Flashは22回、Claude Fable 5は27回にわたり自己レビューを繰り返したが、いずれも早い段階でスコアがピークに達し、その後の修正が完成度を下げる結果となった。
- GPT-5.6 Solは最も低いコストで最良の結果を残した一方、Claude Fable 5は7枚の制作で約160.58ドルと突出して高額であり、Grok 4.5は1,349回のツール呼び出しのうち65%が設定調整に費やされたと報告されている。
- 評価には構造的類似度スコアと人間による目視評価の両方が用いられ、実験に使われたツール一式はGitHub上でオープンソース公開されている。
詳細解説
モナリザに挑んだ4つのAIモデル
AIスタートアップTryAIは2026年7月、GPT-5.6 Sol(7月に正式公開されたOpenAIの最新モデル)、Claude Fable 5、Grok 4.5、Gemini 3.6 Flashの4つのフロンティアモデルに対し、色を選ぶ・筆圧を設定する・線を引く・ぼかす・消すといった基本操作しかできない、ショートカット抜きの描画ツールを与えました。IBM Thinkの記事によれば、モデルにはダ・ヴィンチの「モナリザ」とゴッホの「星月夜」の模写に加え、参照画像なしで「窓辺で日向ぼっこするトラ猫」のような文章プロンプトから絵を描く課題も5つ課されたとのことです。
この実験のポイントは、各モデルが制作途中で何度でも自分のキャンバスを確認し、目標画像と見比べて修正するかどうかを自分で判断できる点にあります。いわゆる「自己批判ループ(self-critique loop、AIが自らの出力を振り返り修正を繰り返す仕組み)」と呼ばれる機能で、多くのAIエージェントに組み込まれた基本要素の一つとされています。
直すほど下手になるという逆説
評価はモデルの出力と目標画像との構造的な類似度を測る客観スコアと、人間による目視評価の2種類で行われました。IBM Thinkによれば、スコアが記録された8件の制作すべてで、最終的な作品の評価が制作途中のピーク時点を下回ったといいます。
特に顕著だったのがGemini 3.6 Flashで、モナリザの制作中に22回も自分の作品を見直しましたが、最高スコアに達したのは5回目あたりで、残り17回の見直しはむしろ完成度を下げる方向に働いたとされています。Claude Fable 5も同じ絵で27回のセルフチェックを行いましたが、5回目以降はスコアがほぼ横ばいだったと報告されています。研究チームは「見直しの回数を増やしても、仕上がりの良さにはつながらなかった」と述べ、モデルが自身の最高到達点を通り過ぎてなお修正を続けてしまう傾向を指摘しています。
この現象は、完璧を目指して何度も手を入れた結果、最初の勢いのある一枚より劣ってしまうという、人間の創作でもしばしば起こる失敗と重なる部分があると考えられます。
コストと品質のばらつき
IBM Thinkの記事では、モデルごとの品質とコストの違いにも触れられています。GPT-5.6 Solは最も低いコストで最良の出力を残した一方、Claude Fable 5は7枚の制作で合計160.58ドルと、他モデルの約20倍のコストがかかったものの、品質面では2位相当の結果だったとされています。また、Grok 4.5は1,349回ものツール呼び出しを行い、その65%が設定調整に費やされたうえ、最終的な作品は「ほぼ使い物にならない」水準だったと評されています。
こうしたコストと品質の関係は、処理回数や試行錯誤の多さが必ずしも良い結果に結びつくとは限らないことを示す一例と考えられます。導入を検討する際は、精度だけでなく、目的の成果物に対してどの程度の試行錯誤コストが妥当かという視点も重要だと思います。
「見えない修正」への示唆
TryAIの実験自体は美術の模写という一見軽いテーマですが、IBM Thinkは、自己批判ループが現在のAIエージェントに広く組み込まれた基本機能である点を踏まえ、絵のように結果を目で確認できないタスクでも同様の行き過ぎた修正が起きていないか、注意を向ける必要があると論じています。コーディングや文書作成など、最終出力だけを見て良し悪しを判断しがちな場面では、この傾向に気づきにくい点が課題だと思います。
まとめ
TryAIの実験は美術の模写という切り口ながら、AIエージェントに共通する自己批判ループの落とし穴を示しました。修正回数の多さが品質向上に直結しない点は、業務活用でも参考になると思います。AIと画像表現の関わりは、Googleが取り組む生成AIアートの動向でも整理していますので、あわせてご覧いただければと思います。