はじめに
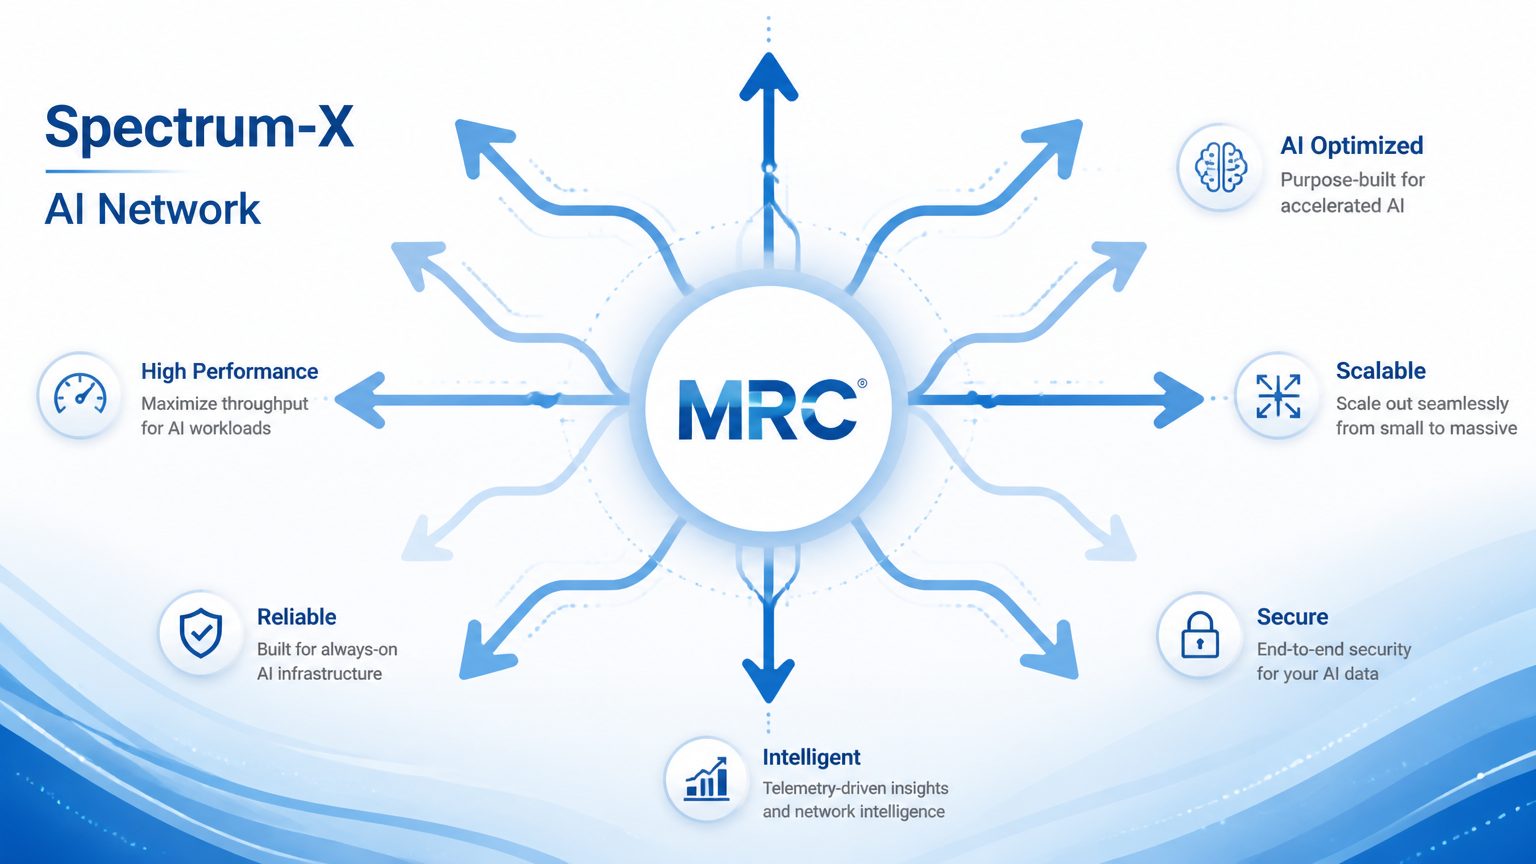
NVIDIAは2026年5月14日、大規模AIトレーニング向けRDMAトランスポートプロトコル「MRC(マルチパス信頼性接続)」を、Open Compute Project(OCP)を通じてオープン仕様として公開しました。Spectrum-Xイーサネット上で初めて実証されたMRCは、OpenAI・Microsoft・Oracleの実稼働環境にすでに採用されており、ギガスケールのAIインフラ標準として注目されています。
参考記事
- タイトル: NVIDIA Spectrum-X — オープンな AI ネイティブ イーサネット ファブリック — MRC によりギガスケール AI の標準を確立
- 著者: Gilad Shainer
- 発行元: NVIDIA 日本語ブログ
- 発行日: 2026年5月14日
- URL: https://blogs.nvidia.co.jp/blog/spectrum-x-ethernet-mrc/
関連記事
要点
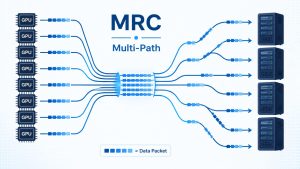
- MRC(マルチパス信頼性接続)は、単一のRDMA接続内で複数のネットワークパスにトラフィックを分散させることで、スループット・負荷分散・可用性を向上させるトランスポートプロトコルである
- NVIDIA Spectrum-Xイーサネットハードウェア上で初めて実証・最適化され、Open Compute Project(OCP)を通じてオープン仕様として公開された
- OpenAI(Blackwell世代)、Microsoft(Fairwaterデータセンター)、Oracle Cloud Infrastructure(Abileneデータセンター)が実稼働環境でMRCを採用している
- 障害迂回技術により、ネットワークパスの障害を数マイクロ秒で検出し、ハードウェアレベルで自動的にトラフィックを迂回させる
- NVIDIA、AMD、Broadcom、Intel、Microsoft、OpenAIの共同開発によるオープン標準である
詳細解説
MRCとは——「渋滞を動的に回避する」ネットワーク設計
RDMA(Remote Direct Memory Access)は、CPUを介さずにサーバー間でデータを直接転送する技術で、大規模AIトレーニングにおける高速通信の基盤となっています。ただし従来のRDMA実装は単一の通信パスに依存しがちで、輻輳(ふくそう)や障害が発生した際にスループットが大きく低下するという課題がありました。
MRC(Multipath Reliable Connection)はこの課題を解決するために設計されたプロトコルです。NVIDIAは「一車線の道路を、リアルタイム交通情報アプリと格子状の街路の組み合わせに置き換えるようなもの」と表現しており、輻輳時でも過負荷状態のパスをリアルタイムで動的に回避できる仕組みを持ちます。
同月上旬にOpenAIもMRCの大規模実装成果を発表しましたが、今回のNVIDIAの発表はその技術基盤であるSpectrum-Xイーサネットと、MRCのオープン標準化についてさらに詳述するものです。
実稼働環境での採用——OpenAI・Microsoft・Oracle
MRCはすでに大手テクノロジー企業の本番環境に導入されています。OpenAIのIndustrial Compute部門責任者であるSachin Katti氏は、「Blackwell世代におけるMRCの導入は非常に成功しており、ネットワーク関連の速度低下や中断の多くを回避でき、大規模な最先端AIトレーニングで高い効率を維持できた」と述べています。
MicrosoftのFairwaterデータセンターとOracle Cloud InfrastructureのAbileneデータセンターも同様にMRCを活用しています。NVIDIAによれば、これらはいずれも「最先端LLMのトレーニングと展開のために専用に構築された最大級のAIファクトリー」であり、パフォーマンス・拡張性・効率性の要件を満たすためにMRCが選ばれたとしています。
ギガスケール対応の耐障害性設計
大規模AIトレーニングでは、数千台のGPUが同期して動き続ける必要があります。わずかなネットワーク障害でも、トレーニングジョブ全体が遅延・中断するリスクがあるため、高い耐障害性は欠かせない要件です。
NVIDIAによれば、Spectrum-Xイーサネット上のMRCは、ネットワークパスの障害を数マイクロ秒で検出し、ハードウェアレベルで自動的にトラフィックを迂回させます。データ損失が発生した場合もインテリジェントな再送信機能が働き、GPUのアイドル時間を最小限に抑えるとしています。
OpenAIが採用するマルチプレーンネットワーク設計では、複数の独立したネットワークファブリック(プレーン)が各GPUに代替通信パスを提供します。Spectrum-Xはプレーン間でのハードウェアベースの高速負荷分散をサポートしており、数十万基のGPUにスケールしてもレイテンシを予測可能な低水準に維持できると説明されています。
オープン標準化の意義——業界横断での共同開発
MRCはNVIDIA単独の技術ではなく、AMD、Broadcom、Intel、Microsoft、OpenAIとの共同開発によって生まれたプロトコルです。Open Compute Projectを通じたオープン仕様の公開は、特定ベンダーのプロプライエタリな実装に依存しない形で、業界全体が次世代AIインフラの標準化を進める姿勢を示すものと言えます。
AIトレーニングクラスターの規模が急速に拡大するなか、ネットワークのボトルネックはGPU性能の最大活用を妨げる重要な課題となっています。複数のベンダーが互換実装を開発できるオープン標準の整備は、AIインフラ全体の底上げにつながると考えられます。なお、Spectrum-Xイーサネットではアダプティブ RDMAやMRCを含む複数のRDMAトランスポートモデルを選択できる柔軟な設計が採用されており、ユーザーは自身のワークロードに応じた構成を選べます。
まとめ
NVIDIAがMRCをオープン仕様として公開したことで、ギガスケールのAIトレーニング向けネットワーク技術の標準化が一段と進む見通しです。OpenAI・Microsoft・Oracleの実稼働採用は、技術の成熟度を示す有力な指標といえます。MRCをOpenAI側の実装・性能の視点から掘り下げた解説記事もあわせてご覧いただければと思います。